在 GTC 柏林上,银行、支付企业和金融数据提供商正在展示生产级智能的落地形态 —— 基于 NVIDIA 加速计算构建,采用开放权重模型,并运行在客户自有基础设施之上。
Revolut 正基于单一基础模型 PRAGMA 重构其技术栈,该模型由 NVIDIA 加速计算提供支持。借助 NVIDIA cuDF toolkit 和 Dynamo-Triton 软件,并在 NVIDIA Blackwell Ultra GPU 上运行,Revolut 正在生产环境中规模化部署 PRAGMA,目前已服务 8000 万初始客户,并具备 3 倍扩展能力。
Revolut 的 AI 负责人 Pavel Nesterov 表示:“Revolut 每天处理数十亿笔交易 —— 机会一直存在,但问题在于,基础模型能否在大规模以及跨越业务场景中稳定运行。PRAGMA 给出了答案。我们与 NVIDIA 联合打造这一模型,这也是迄今为止最有力的证明:研究突破与生产级银行系统之间的鸿沟可以被弥合。”
在加速基础设施上开展训练
Starling Bank 是首家在英国云基础设施上训练智能体模型的银行。已在 Civo 英国云上利用自有交易数据开发出“Starling Intelligence” —— 这一支撑其 AI 能力的智能层。
劳埃德银行集团 (Lloyds Banking Group) 打造了交易基础模型 ATUM,可将数十亿笔银行交易转化为可复用的智能 —— 该模型由 NVIDIA RTX Blackwell GPU 提供加速,并提升了全行各类应用场景的效率。
SBS 推出银行自主可控的智能平台,使银行能够在自有环境中运行生成式模型和智能体模型,而无需数据离开自身系统。
以极低成本使用开放模型
开放权重模型让欧洲金融机构能够基于自有数据构建专属智能,并将成本控制在自身可控范围内。NVIDIA 加速计算平台,正是支撑这一切的底层引擎。
荷兰数字银行 bunq 的智能体助手 Finn 现已基于开放权重模型运行。在 NVIDIA 加速计算的支持下,将其部署于 Nebius 平台,其每次回答的效果可媲美领先的闭源模型,而成本仅为后者的 60%。
NatWest 正在开发一项语音识别技术,旨在准确识别英国各类口音、方言及金融专业术语;该技术基于 NVIDIA 语音模型构建,其中包括 Nemotron 3.5 ASR。
Modulr 正基于 NVIDIA Nemotron-3-Ultra-550B 开放模型,为支付业务的不同环节构建专用模型。
桑坦德银行 (Santander) 正率先采用全新的 NVIDIA Kumo 系列开放权重基础模型,面向结构化金融数据,并以此构建面向核心银行业务场景的专用智能。
加速计算重塑金融研究
伦敦证券交易所集团 (LSEG) 正与 NVIDIA 合作,借助 Polars GPU 引擎,帮助金融机构将海量历史逐笔交易数据的分析速度提升高达 10 倍;该引擎由 NVIDIA cuDF 提供加速支持,并运行于 NVIDIA RTX Blackwell GPU 上。
RavenPack 在 Bigdata.com 上构建了一套数据集生成流水线,只需输入自然语言的研究假设,即可转化为经过标注、可直接用于回测的数据集 —— 该流水线运行于经过微调的 NVIDIA Nemotron 模型之上。投资者可利用这些数据集来识别、分析和可视化市场趋势。
加速数据流,强化欺诈检测能力
RTX Blackwell 服务器版 GPU 与 NVIDIA cuDF 可加速跨多 TB 级、相互独立且合规数据源的数据处理,大幅缩短从数据到决策的周期,助力欺诈检测及其他业务场景。
汇丰银行 (HSBC) 借助 Starburst Enterprise GPU Engine,将数据处理速度提升 5 倍,从而提供近乎实时的客户洞察,在支持客户流程与按需决策的同时,最大限度降低风险与欺诈隐患。
全球可编程金融服务提供商 Stripe,在离线测试中借助 NVIDIA GPU 加速的 Ray Data,使其 Stripe Radar 欺诈检测平台的数据流提速 42 倍,成本降低 92%。这一加速能力使 Stripe Radar 的机器学习流水线能够持续优化模型训练,并不断提升欺诈检测能力。
了解更多 NVIDIA 加速计算在金融服务业的应用。
请参阅软件产品信息服务条款。
]]>NVIDIA RTX Spark 为纤薄笔记本电脑注入强劲动力,全面满足开发者、创作者和玩家的需求。
华硕、戴尔、联想、微软和微星现已推出 RTX Spark 笔记本电脑。这些性能强大的系统将 NVIDIA Blackwell RTX GPU 和 NVIDIA Grace CPU 集成于一颗超级芯片,最高配备 128GB 统一内存,并提供最高 1 Petaflop 的 FP4 AI 性能。这让便携的高端 Windows 笔记本电脑拥有了 NVIDIA CUDA 平台、RTX 图形技术和个人 AI 超级计算机的能力。
RTX Spark 最新及即将推出的更新包括:
- NVIDIA Nemotron 3.5 Transcribe 现已支持 RTX Spark。这款开放权重语音模型可完成转录、说话人归属识别和翻译。
- LFM3 开放模型系列获得首日支持。
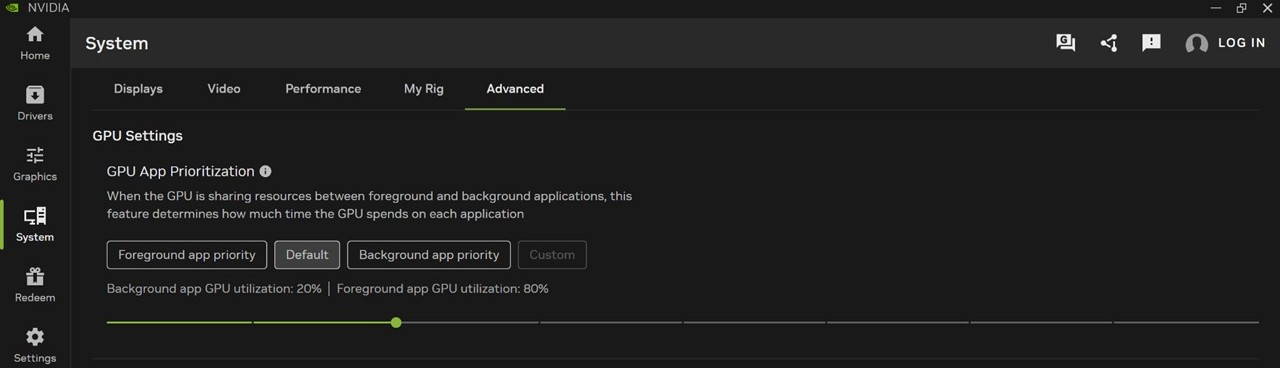
- NVIDIA App 新增资源管理功能,可在前台应用和后台智能体之间分配 GPU 资源。
- 灵游坊备受期待的动作角色扮演游戏《影之刃零》(Phantom Blade Zero) 首发支持路径追踪和 NVIDIA DLSS 4.5。
- RTX Remix 1.6 现已支持 RTX Spark,用户可借此在《我的世界》(Minecraft) 中开启路径追踪和 DLSS。
借助 NVIDIA Nemotron 3.5 Transcribe,将录音转化为有用信息
今日发布的 NVIDIA Nemotron 3.5 Transcribe 是一款全新开放权重语音模型,可将录制的对话转化为有用信息。开发者无需分别使用多个模型来完成转录、说话人标注和翻译,只需一个可通过提示词引导的模型,即可完成这三项任务,还能回答与音频相关的问题。该模型支持 40 种语言的转录,其中包括 7 种印度语言。
开发者可使用自然语言提示词引导模型。例如,针对同一段会议录音,用户可提出以下要求:
- “转录这段录音,并标注每位说话人。”
- “将这段音频翻译成英语。”
- “列出本次会议作出的决定。”
提示词还可包含产品术语和格式规范,帮助模型处理医疗、金融服务和客户服务等领域的专业词汇。由于模型权重开放,开发者可自行选择音频处理的位置,从桌面端到云端均可。
Nemotron 3.5 Transcribe 在 Hugging Face Open ASR 排行榜上位列第一,在 Artificial Analysis 的开放权重模型排名中位列第二。该模型仅需约 43 亿活跃参数,即可提供领先的准确率,其活跃参数量比排名第一的开放权重模型少 80%,让在本地硬件上进行高质量智能转录更具实用性。
该模型现已在 Hugging Face 上提供 BF16、FP8 和 NVFP4 格式,并支持 NVIDIA RTX Spark 和 DGX Spark 系统、Jetson AGX Thor 设备以及 GeForce RTX 5090 D v2 GPU,为开发者提供灵活的部署选择。开发者可通过 NeMo-Speech.cpp 或 vLLM 部署 NVFP4 版本。
阅读 NVIDIA 技术博客,了解更多详情。
掌控智能体与 PC 应用之间的 GPU 资源分配
在 RTX Spark 上,用户可让长时间运行的智能体与日常应用同时工作。两者共享系统的 GPU 算力,合理的资源分配取决于用户当下的优先需求。
借助 NVIDIA App 新增的资源管理功能,用户现在可自行选择 GPU 资源的分配方式。用户可优先为前台应用分配资源,以获得最佳性能,也可为后台运行的智能体提供更多资源,让它更快完成工作。
在 NVIDIA App 的“系统 > 高级”中,可使用资源共享控制选项。使用此功能前,需在 Windows 设置中开启硬件加速 GPU 调度。
Liquid AI:一个模型系列,多种工作方式
Liquid AI 的 LFM3 是新一代面向专用任务的 Liquid Foundation Models。该系列基于统一的主干架构,涵盖文本、视觉、音频、全模态和决策模型,并以开放权重形式提供基础模型及经过后训练的模型。这些模型体积小巧、运行迅速:Liquid AI 全新的 17 亿参数基础模型,性能超越其上一代 26 亿参数基础模型。
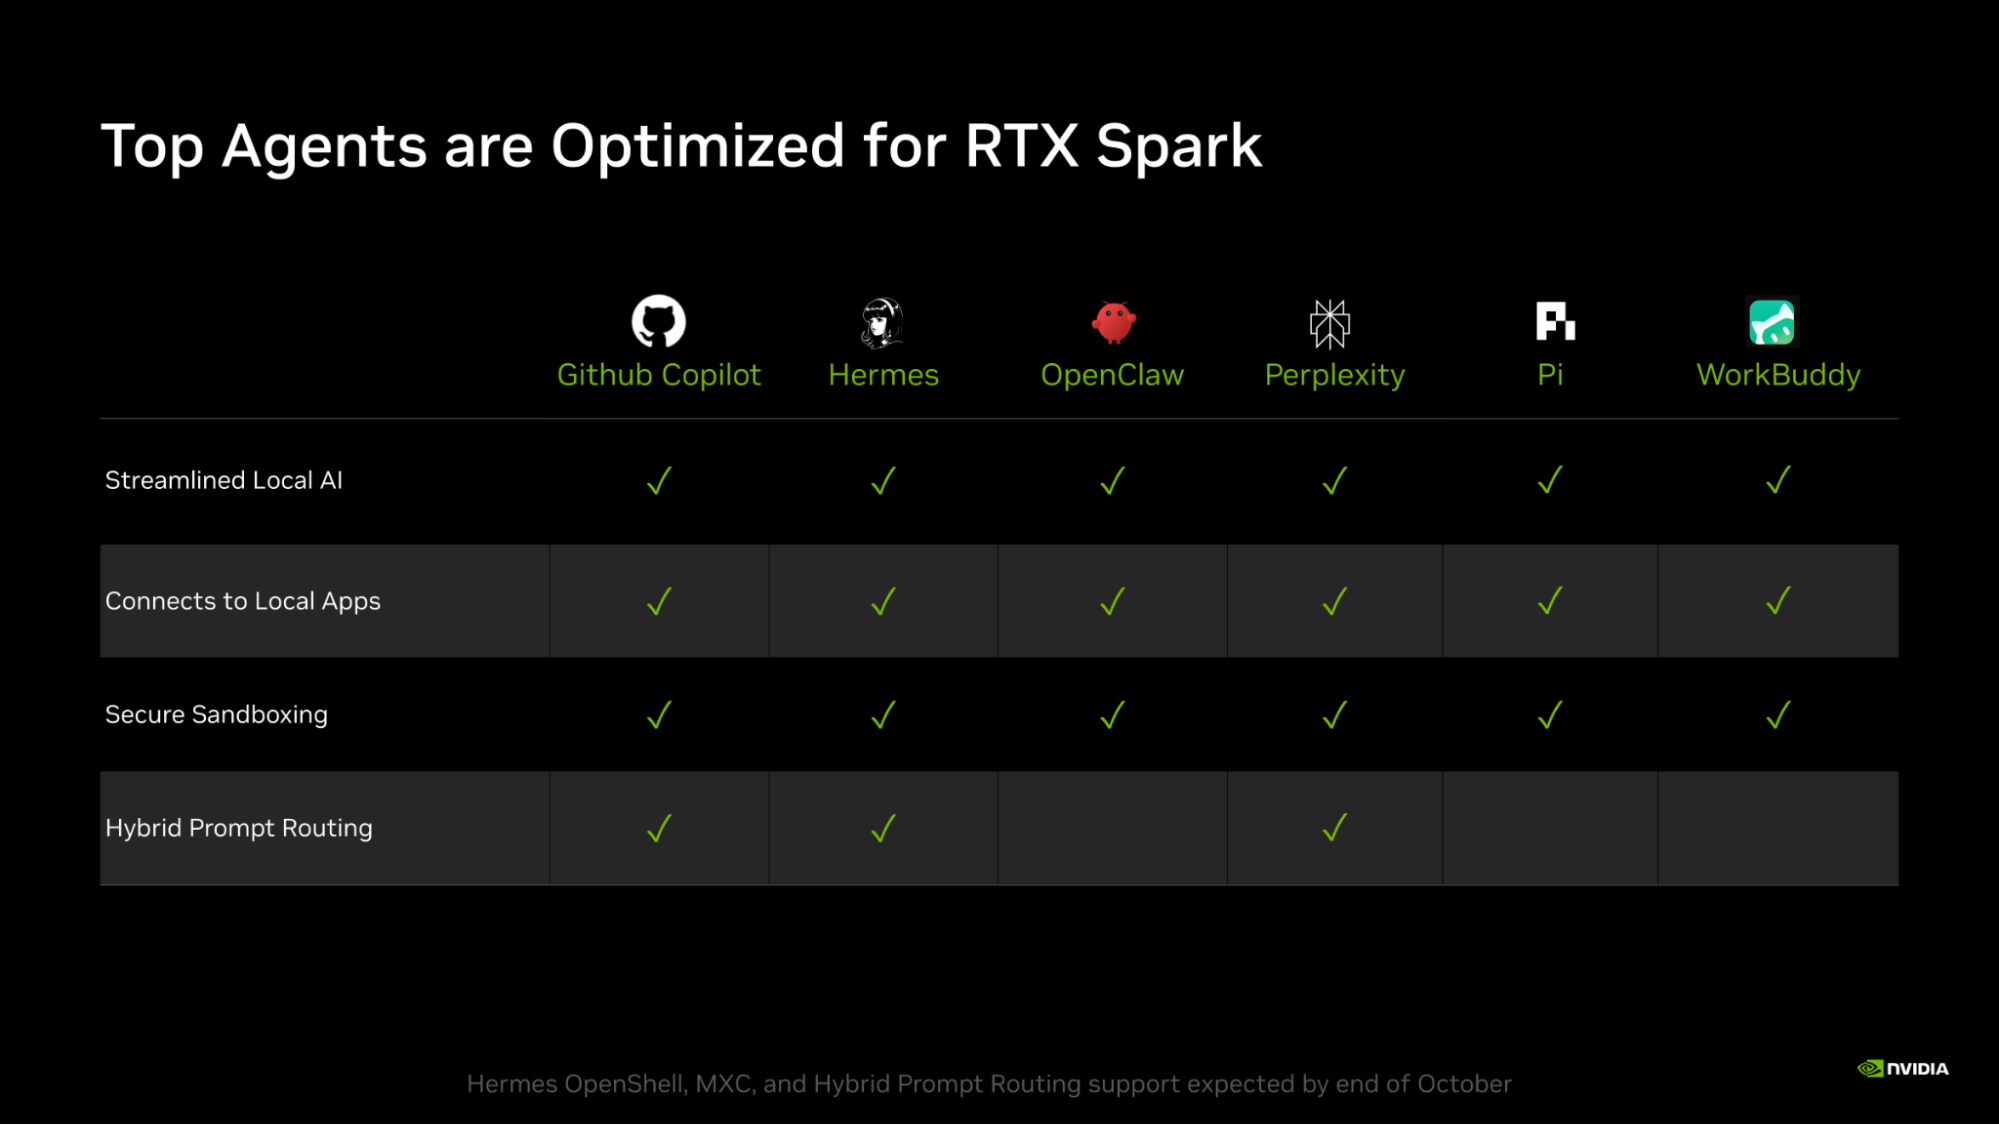
这些模型支持多种本地工作流。例如,在 Hermes Agent、Pi 和 OpenClaw 中运行的智能体可分类处理收件箱并管理日历,读取文档和应用界面,转录和翻译语音,回答针对手写数学内容提出的口头问题,以及分派客服工单或语音请求。
llama.cpp 和 vLLM 为 LFM3 提供原生支持,开发者可借此在 RTX Spark 上本地运行模型,并进行本地微调。
《影之刃零》 ( Phantom Blade Zero) 首发支持 DLSS 4.5
灵游坊的《影之刃零》(Phantom Blade Zero) 将于北京时间 10 月 29 日 10:00 登陆 Steam 以及 Epic 游戏商店。玩家将扮演遭诬陷杀害师父的剑客“魂”,游历江湖,揭开阴谋。
NVIDIA 与灵游坊工作室及灵游坊发行团队合作,为这款游戏加入光线追踪效果。在 RTX Spark 笔记本电脑和搭载 GeForce RTX GPU 的 PC 上,光线追踪可呈现更准确的反弹光照 (间接光照)、更细腻的反射,以及植被和地形上更逼真的阴影。NVIDIA DLSS 动态多帧生成功能最高支持 6 倍帧生成模式,提升游戏帧率,也可实时调整生成倍数,以达到玩家设定的目标帧率。
访问 GeForce.cn,了解更多详情。
RTX Remix 让经典游戏焕发新生
NVIDIA RTX Remix 是一个利用路径追踪和 DLSS 重制经典游戏的 Mod 制作平台,上周发布了 1.6 版本。此次更新将 RTX Remix 带到了全球规模最大的游戏社区《我的世界》(Minecraft)。创作者和玩家均可通过 RTX Remix 渲染《我的世界》(Minecraft) Java 版 v1.21.1,开启由 DLSS 加速的路径追踪,并在未来的作品中充分运用逼真的光照和材质。
此次更新还加入了采用 3D引导神经网络渲染的 DLSS 5、最高 6 倍多帧生成、RTX Spark 原生支持,以及智能体辅助工作流。即日起,这些升级也将登陆《传送门 》RTX 版 (Portal with RTX) 和《半条命 2 RTX》(Half-Life 2 RTX) Demo,两款游戏现均支持 RTX Spark,并支持 DLSS 3D 引导神经网络渲染呈现更逼真的光照和材质,同时加入 DLSS 帧生成的全新性能模式,还提供了可加速路径追踪的新选项。
RTX Remix 1.6 还简化了 AI 驱动的 Mod 制作流程。重新设计的 ComfyUI 工作流让 Modder 无需配置应用程序编程接口,即可直接在 RTX Remix 中生成基于物理的材质,同时支持对整个项目进行批量处理,并为技术经验较少的创作者提供预设。此外,借助 NVIDIA 智能体技能,兼容的 AI 智能体可直接与 RTX Remix 协作,加快重制项目的进程。
阅读 RTX Remix 博客,了解更多详情。
RTX Spark 笔记本电脑:设计精美,全能之选
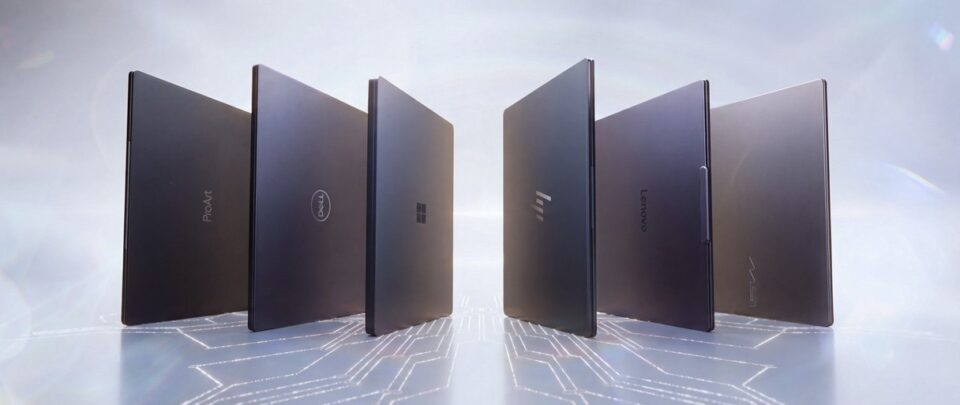
RTX Spark 笔记本电脑提供多样设计,用户可根据工作和娱乐方式选择适合自己的产品。可选配置包括不同屏幕尺寸、机身配色、触摸屏、手写笔支持及二合一翻转形态。RTX Spark 笔记本电脑薄至 14mm、轻至 3 磅,并拥有全天续航能力。
RTX Spark 将 GPU、CPU 和最高 128 GB 的统一内存放在一个高效节能的超级芯片上,因而能够实现如此纤薄的设计。创意项目与 AI 模型共享同一内存,让笔记本电脑即使在未连接电源时,也能胜任过去需要台式机工作站才能完成的任务。
对于不同用户而言,这意味着:
- AI 开发者:在 NVIDIA CUDA 平台上本地运行模型和智能体。该平台同样为云端 AI 提供支持,可帮助开发者将应用部署至超过 1.5 亿台 NVIDIA RTX AI PC 及云端 NVIDIA GPU。
- 创作者:RTX Spark 可编辑相机原生 4:2:2 视频,并渲染最大 90 GB 的 3D 场景。Adobe Photoshop 和 Premiere 的测试版已提供 RTX Spark 原生支持。
- 玩家:RTX Spark 可运行数百款游戏,NVIDIA DLSS、光线追踪、Reflex 和 G-SYNC 可带来更清晰的画面,以及更流畅、响应更加灵敏的游戏体验。
华硕、戴尔、联想、微软和微星的 RTX Spark 笔记本电脑现已上市,零售价人民币 18,999 元起,128GB 配置版本也已开售。访问 RTX Spark 产品页面,选购适合自己的笔记本电脑。
#别错过:NVIDIA 本地 AI 的更多更新
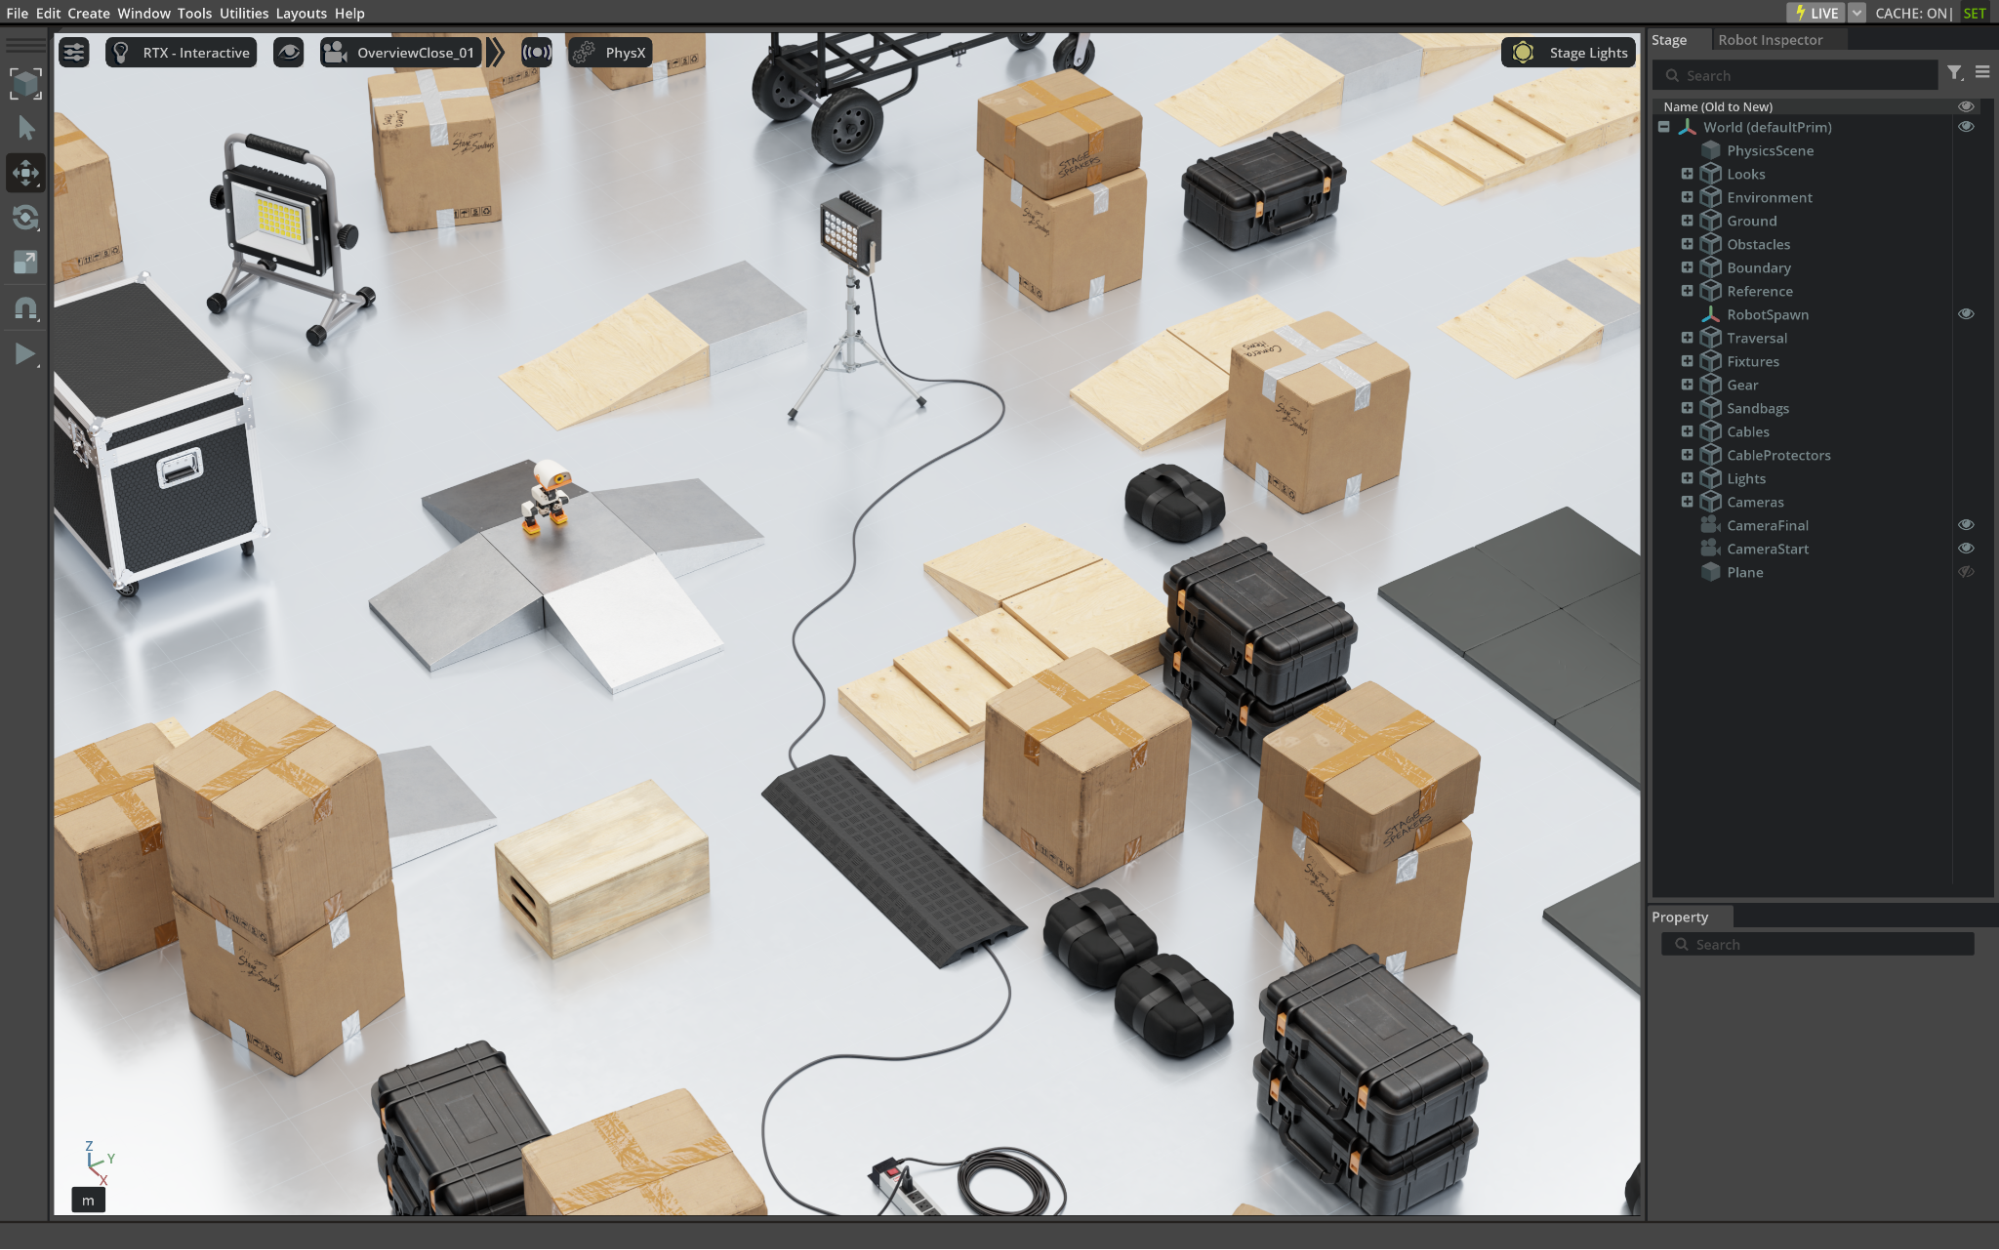
 RTX Spark 助力 Microduck 机器人学习行走:在 GTC 柏林主题演讲中,NVIDIA 创始人兼首席执行官黄仁勋展示了在 RTX Spark 上运行的 AI 智能体如何帮助训练 Hugging Face 的 Microduck 机器人。一篇最新的 NVIDIA 技术博客详细介绍了相关工作流:Hermes Agent 和 Nemotron 3.5 Bolt 在 RTX Spark 上规划障碍课程,Astra 负责构建 3D 资产,NVIDIA Isaac Lab 训练导航策略,再由 RTX Spark 在 NVIDIA Isaac Sim 中进行验证。请观看 Demo 视频,并尝试参考 Playbook 上手。
 NVIDIA Nemotron 3.5 Bolt E4B 4GB 现已推出,其 4 位量化版本在特定推理配置下可将内存占用控制在约 4GB,支持自然对话和多步骤智能体任务;实际占用随上下文长度及推理配置而变化。 。该模型可为 RTX Spark、DGX Spark、GeForce RTX GPU 和 NVIDIA Jetson 设备上的本地语音助手、游戏角色及嵌入式界面提供支持。它支持 llama.cpp、vLLM、Ollama、Unsloth 和 LM Studio,并可与 Hermes 和 OpenClaw 配合使用。对于要求更高的智能体工作负载,Nemotron 3.5 Bolt 74B-A9B 24GB 专为在 RTX Spark 上运行本地智能体而设计。
 Black Forest Labs 的 FLUX 3 Image Klein 是一款 56 亿参数开放权重模型,用户可借助该模型在本地生成和编辑图像。NVIDIA 优化版仅需 8GB 显存即可在 RTX GPU 上运行。开发者还可使用 NVIDIA NeMo AutoModel 方案,在 RTX Spark 上微调该模型,以适配特定创意工作流。
 NVIDIA DGX Spark 64GB 版现已通过 OEM 合作伙伴开售,为开发者和研究人员在本地构建与运行 AI 提供更多选择。该产品搭载 GB10 Grace Blackwell 超级芯片,将 64GB 统一内存、DGX OS 和 NVIDIA AI 软件栈相结合,可用于智能体开发、推理和微调。请查看页面,了解更多详情及购买选项。
NVIDIA RTX AI PC 的相关信息请关注微博、抖音及哔哩哔哩官方账号,并订阅 NVIDIA 本地 AI 新闻,及时了解最新动态。软件产品信息请查看声明。
]]>新闻摘要:
- NVIDIA 和 Meta 将扩大在 Muse 及其系列模型方面的合作,以满足市场对 AI 智能体日益增长的需求。
- 双方还考虑开展其他技术合作,包括用于增强机构安全性的 NVIDIA OpenShell 参考架构,以及用于监测,并支持结构化数据、非结构化数据和图数据处理的 NVIDIA Sentry。
- Meta 将扩大 NVIDIA Vera Rubin 和 Vera CPU 的部署,并借助 NVIDIA Spectrum-X 以太网网络和 BlueField-4 提升性能并扩展工作负载。
NVIDIA 和 Meta 今日宣布,双方将深化合作,扩大在 Muse 及其系列模型方面的工作,以提升推理和训练性能,来满足市场对实用 AI 智能体日益增长的需求。
Meta 的 Muse 模型和智能体依托 NVIDIA 的基础设施,自推出以来实现了领先的基准测试表现和激增的用户下载量。Meta 和 NVIDIA 计划进一步深化合作,在工作流优化方面开展合作,以更大限度地提高性能并改善总体拥有成本。Meta 和 NVIDIA 还将探讨在 NVIDIA OpenShell 参考架构上的更多合作机会,包括用于安全部署的 NVIDIA OpenShell 和用于监测智能体行为的 NVIDIA Sentry。
此次宣布进一步巩固了 Meta 与 NVIDIA 的长期合作伙伴关系,为 Meta 的 AI 基础设施布局提供支持。Meta 计划扩大对 NVIDIA 基础设施的部署,包括采用 Vera Rubin 和 Vera CPU,为下一代 AI 智能体提供支持,以实现更高的每瓦特性能。Meta 还将部署 NVIDIA Spectrum-X 以太网网络和 BlueField-4,以支持网络效率和吞吐量。
此外,NVIDIA 还将投资 30 亿美元,参与 Meta 的股权发行。
NVIDIA 创始人兼首席执行官黄仁勋表示:“AI 智能体代表了一种新的计算范式,即能够理解我们的目标、进行推理、使用工具并代我们完成工作的软件。这改变了我们使用计算机的方式,从操作应用程序转变为和智能体一同工作。NVIDIA 和 Meta 正在深化合作,对计算基础设施进行端到端的优化,以打造强大、高效且安全的 AI 智能体,从而助力数十亿人取得更多成就并追求更远大的抱负。”
Meta 创始人兼首席执行官马克・扎克伯格表示:“Muse 让每个人都能拥有个人超级智能。我们很高兴能继续与 NVIDIA 合作,为数十亿人提供出色的个人智能体和前沿模型。”
]]>NVIDIA 正在将其开放模型系列扩展到语言、机器人、生物学和量子计算领域,为开发者、研究人员和企业提供工具,以构建针对当地语言和行业定制的应用。
该产品系列包括全新的 NVIDIA Nemotron 3.5 Super VL 和 Nemotron 3.5 Bolt 模型;用于嵌入、重新排序和文档解析的全新 NVIDIA Nemotron Retriever 模型;用于结构化业务数据的全新 NVIDIA Kumo 系列开放权重基础模型和库;NVIDIA Cosmos 3.5 世界模型;用于辅助驾驶的 NVIDIA Alpamayo 2 Edge;用于医疗与科学发现的 NVIDIA BioNeMo;用于量子计算的 NVIDIA Ising。
这些开放模型为企业组织提供了一个基础,使其能够利用本地数据进行定制,并在其管控的基础设施上部署。
NVIDIA Nemotron 助力各行业的后训练
NVIDIA Nemotron 为构建智能体的开发者提供了开放语言模型、数据集和配方。这些模型支持文本和图像,帮助智能体编排工作流、推理复杂问题,并以更低的成本完成特定任务。Nemotron 模型基于 NVIDIA Nemotron Coalition 的数据、研究和专业知识构建,该联盟包括 Black Forest Labs、H-Company 和 Mistral 等欧洲合作伙伴。
Nemotron 为企业基于自己的知识和专业构建应用提供了基础。达索系统、Domyn、Dream、Palantir 的客户、Salesforce、SAP、Shopify、新思科技和 WPP,以及 Accenture 和安永等专业服务提供商,正在使用 Nemotron 模型和数据集创建定制模型并构建特定领域智能体。
由 AfterQuery、AgileRL、AI21、Alice、Applied Compute、Baseten、CoreWeave、Distil Labs、EON、Fastino、Fireworks、Google Cloud、Mercor、Multiverse Computing、Nebius、Handshake AI、Plurai、Prime Intellect、River.AI、Scale AI、Trajectory 和 TNG 等组成的广泛的后训练合作伙伴生态系统将帮助企业针对特定领域的工作负载定制 Nemotron。
NVIDIA Kumo 加速智能体处理结构化企业数据
NVIDIA Kumo 开放基础模型、库和工具帮助智能体和应用根据结构化业务数据预测结果、对欺诈风险进行评分,并提供操作建议。作为 NVIDIA Agent Knowledge Foundation 的一部分,Kumo 可缩短预测时间,并降低为每项任务构建独立机器学习管线的成本和复杂性。
开发者可以使用预训练的 Kumo 模型将预测结果快速引入更多应用,然后在需要更高性能时使用专有数据对其进行微调。该产品系列包括 NVIDIA Kumo Structured (包含用于关系和表格预测、预测分析和异常检测的模型),以及用于开发和部署结构化数据基础模型的开放库技术栈 NVIDIA Kumo Engine。
Cognite、Coinbase、Databricks、DoorDash、Revolut 和 Tubi 位列首批使用 Kumo 模型以加速开发的企业。Snowflake 客户已经在使用 Kumo 模型,加速广告、能源、金融服务和零售等行业的 AI 开发。
NVIDIA Cosmos 加速机器人训练与仿真
NVIDIA Cosmos 是一系列开放世界基础模型,旨在帮助开发者构建能够理解物理世界并与之交互的机器人、智能汽车和视觉智能体。
NVIDIA 将推出全新 Cosmos 后训练和优化工具,帮助开发者使用更少的算力改进世界模型,同时提供仿真检查点,用于在现实世界测试之前评估交互式驾驶和机器人操作场景中的行为。
此外,NVIDIA 还推出了 Cosmos Data Factory (包括蓝图和核心智能体技能),以帮助开发者针对驾驶场景、产品缺陷、图像增强和事件生成等任务,对训练数据进行筛选整理、标注、生成和评估。开发者可以使用完整工作流或单个功能,并使用智能体协调流程。
保时捷与 Voxel51、ANYbotics 与 Encord、Zalando 和 CEVA Logistics 与 Sereact,以及西门子,正在使用 Cosmos Data Factory 创建高质量、多样化的训练数据集,并提升模型精度。
NVIDIA Alpamayo 2 为辅助驾驶汽车带来实时推理能力
NVIDIA Alpamayo 2 Edge 是一款轻量级推理模型,可直接在辅助驾驶车辆端实现实时场景理解和运动规划。该模型基于 NVIDIA Cosmos 构建,并针对 NVIDIA DRIVE AGX Thor 平台进行了优化,帮助开发者以更低的算力需求为车辆提供先进的驾驶功能。
NVIDIA BioNeMo RFD4-Proteina 推动蛋白质设计发展
NVIDIA BioNeMo RFD4-Proteina 是 NVIDIA 和华盛顿大学蛋白质设计研究所的 Baker Lab 推出的开放蛋白质设计模型。
该模型生成蛋白质序列和 3D 结构,帮助研究人员设计能够结合具有挑战性的靶点、组装成复杂结构并结合小分子的蛋白质。
NVIDIA BioNeMo RFD4-Proteina 在 10 多种蛋白质设计任务中提供领先的性能,并在由 200 个氨基酸蛋白质组成的基准测试中,生成设计的速度比 RFdiffusion3 快约 13 倍。研究人员可以通过智能体使用该模型,根据设计目标和分子约束生成并评估候选设计,进而选择需要进入实验室测试的设计方案。
NVIDIA Ising 加速量子开发
NVIDIA Ising 开放模型系列提供了一个通用、可扩展的基础,以加速开发实用量子超级计算机所需的突破,从实时硬件校准到纠错,覆盖不同的量子比特模态,并适配不同硬件的定制化需求。
IQM Quantum Computers 正在使用 Ising 对其量子处理器进行校准,展示专用开放校准模型优于大型通用模型的能力。SEEQC 正在将 NVIDIA NVQLink 平台和 Ising 与其独特的 Digital Link 相结合,以满足实时量子纠错所需的低延迟要求。
AWS 正通过将该模型系列集成到 AWS Parallel Computing Service (AWS PCS),使研究人员能够便捷地使用 NVIDIA Ising。由于延迟要求,解码通常在与量子处理器共址的经典硬件上执行,而 AWS PCS 的集成使研究人员能够在部署前就在 Ising 上进行构建。
可用性
- NVIDIA Nemotron 3.5 Super VL 现已在 Hugging Face、魔搭社区、OpenRouter 和 NVIDIA 官网上作为 NVIDIA NIM 提供,同时也可通过 NVIDIA 云、后训练和推理合作伙伴获取。Nemotron 3.5 Bolt E4B 4GB 预计于 10 月 23 日 (星期五) 推出。
- NVIDIA Nemotron Retriever 开放模型现已在 Hugging Face、各类合作伙伴平台上提供,并在 NVIDIA 官网上作为 NVIDIA NIM 提供。
- NVIDIA Kumo 开放模型现已在 Hugging Face 上提供,并在 NVIDIA 官网上优化并打包为 NVIDIA NIM,用于生产级推理。
- NVIDIA Cosmos 现已在 Hugging Face 和 GitHub 上公开提供,也可通过部分推理合作伙伴获取。
- NVIDIA Alpamayo 2 Edge 将在本月晚些时候在 GitHub 和 Hugging Face 上提供下载。
- NVIDIA BioNeMo 开放模型 RFD4-Proteina 现可在 NVIDIA 官网上作为 NVIDIA NIM 获取,也可在 GitHub 和 Hugging Face 以及通过部分推理合作伙伴获取。
- NVIDIA Ising 现已在 GitHub、Hugging Face 和 NVIDIA 官网中提供。
请参阅软件产品信息注意事项。
]]>当 AI Agent 进入企业工作流执行更多的任务,智能体 AI 安全成为企业落地的关键。矩阵起源 (MatrixOrigin) 将 OpenShell 集成到其对话驱动的数据分析流程中,为每段对话分配独立沙箱,以最小必要权限约束 Agent 的文件读写与网络连接,在保留检索、分析和自动化能力的同时,降低数据越权访问与误操作的风险,构建更安全的企业数据 Agent 执行环境。
案例概览
| 客户 | 矩阵起源 (MatrixOrigin) |
| 用例 | MatrixOne Intelligence (MOI)、AI 智能数据平台、AI Agent、安全运行时、沙箱执行环境 |
| 产品 | NVIDIA OpenShell |
当 AI Agent 开始为企业查询数据、运行分析脚本、生成业务文档,它所需要的已不只是理解问题的能力,还有访问文件、执行代码和连接服务的权限。这些能力让 Agent 能够完成更多实际工作,也带来了新的挑战:如何在赋予 Agent 行动能力的同时,保护企业数据,并控制错误操作带来的风险和影响。
NVIDIA 近期发布的开放智能体安全平台为企业 AI Agent 提供从测试到部署全流程的安全保障。作为一个开放软件平台与参考系统设计,该平台旨在从智能体测试到部署的各个环节强化 AI 安全,并针对运行智能体的软件、硬件、计算和机器人系统,实施全栈治理与管控。
NVIDIA 开放智能体安全平台 (NVIDIA Open Agent Safety Platform) 由 NVIDIA OpenShell 开源软件和 NVIDIA Sentry 参考系统设计组成。NVIDIA OpenShell 是面向 AI Agent 的开源、安全运行时,为需要执行代码、读写文件和访问网络的 Agent 提供受策略约束的沙箱环境。它通过文件系统隔离、网络访问控制等机制,在运行时落实权限边界,让安全约束独立于模型的任务决策生效。对于企业应用,这意味着可以在保留 Agent 必要执行能力的同时,限制其可访问的资源和可连接的目标,降低错误操作或越权访问带来的风险。
在 MatrixOne Intelligence (以下简称 MOI) 平台的实践中,矩阵起源团队将 NVIDIA OpenShell 引入 Agent 执行环境,通过独立沙箱、文件访问控制和网络访问策略,为对话驱动的数据任务建立运行时安全边界。这让企业能够在明确的权限约束下使用 Agent 开展检索、分析和自动化工作,降低数据被越界访问、意外修改或发送至未授权目标的风险。
企业数据 Agent 面临的落地挑战
MatrixOne Intelligence (MOI) 是一体化企业级 AI 基础设施平台,将企业数据、AI 服务、业务上下文、智能体运行、长期记忆与持续学习统一在一个平台中,为企业构建可信、可控、可审计并持续演进的生产级智能体。
以数据分析类任务为例,Agent 可能需要查询数据库、运行脚本处理结果,再生成可下载的报告。随着任务从“回答问题”延伸到“执行操作”,平台需要同时解决三个问题:
- 如何保护任务之外的数据和环境。Agent 需要必要的工作空间,但不应因此获得对其他文件和系统工具的任意读写权限。
- 如何控制数据流向。安装依赖、获取代码和调用内部服务都可能需要网络连接,但完成任务所需的连接,不应演变为不受限制的对外访问。
- 如何兼顾隔离与使用体验。不同对话需要独立的执行环境,同时,用户也不应为每次任务手动创建、维护和清理沙箱。
这些问题需要执行环境提供强制约束。即使 Agent 生成了超出授权范围的命令,平台也需要在实际操作发生时阻止它。
将 OpenShell 接入 Agent 执行链路
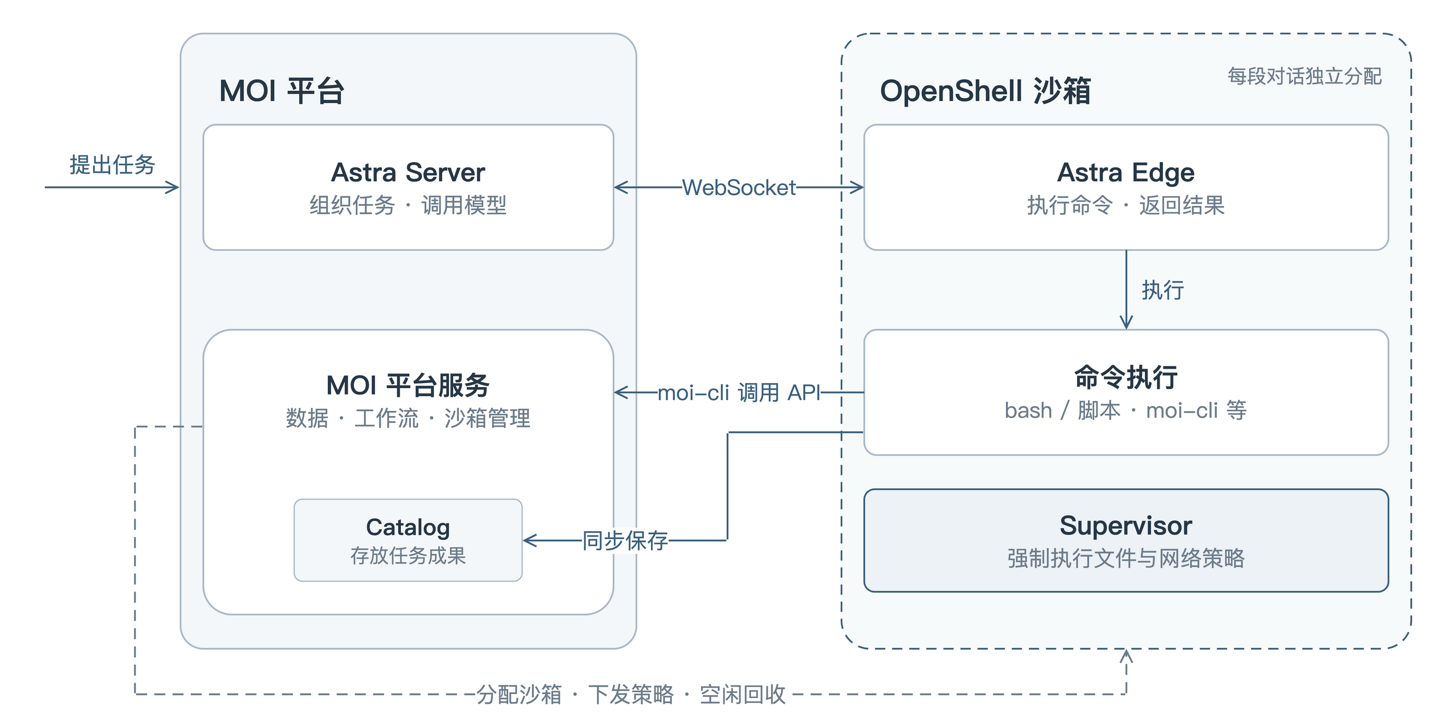
NVIDIA OpenShell 为 Agent 提供受策略约束的沙箱执行环境。在 MOI 中,平台负责管理沙箱生命周期并下发访问策略,Agent 运行时 Astra 负责组织任务和调用模型,命令则在沙箱内执行。
Astra 由决策与执行两部分组成。Astra Server 组装上下文、调用模型,并根据任务进展选择检索知识库、调用平台工具或执行命令;沙箱内的 Astra Edge 进程通过 WebSocket 接收命令,并返回执行结果。沙箱还预装了 MOI 命令行工具 moi-cli,用于调用数据库查询、SQL 执行和工作流等平台能力。
在这条执行链路中,OpenShell Supervisor 在沙箱内启动受限的 Agent 进程并协调策略执行。文件访问限制由 Landlock 等内核机制落实,网络出口则由沙箱内的代理和策略引擎根据调用程序、目标地址及相关规则进行判断。Agent 可以在授权范围内决定如何完成任务,但具体操作能否执行,最终由运行时策略决定。
用最小必要权限降低数据与环境风险
限定文件读写范围,保护工作空间之外的资源
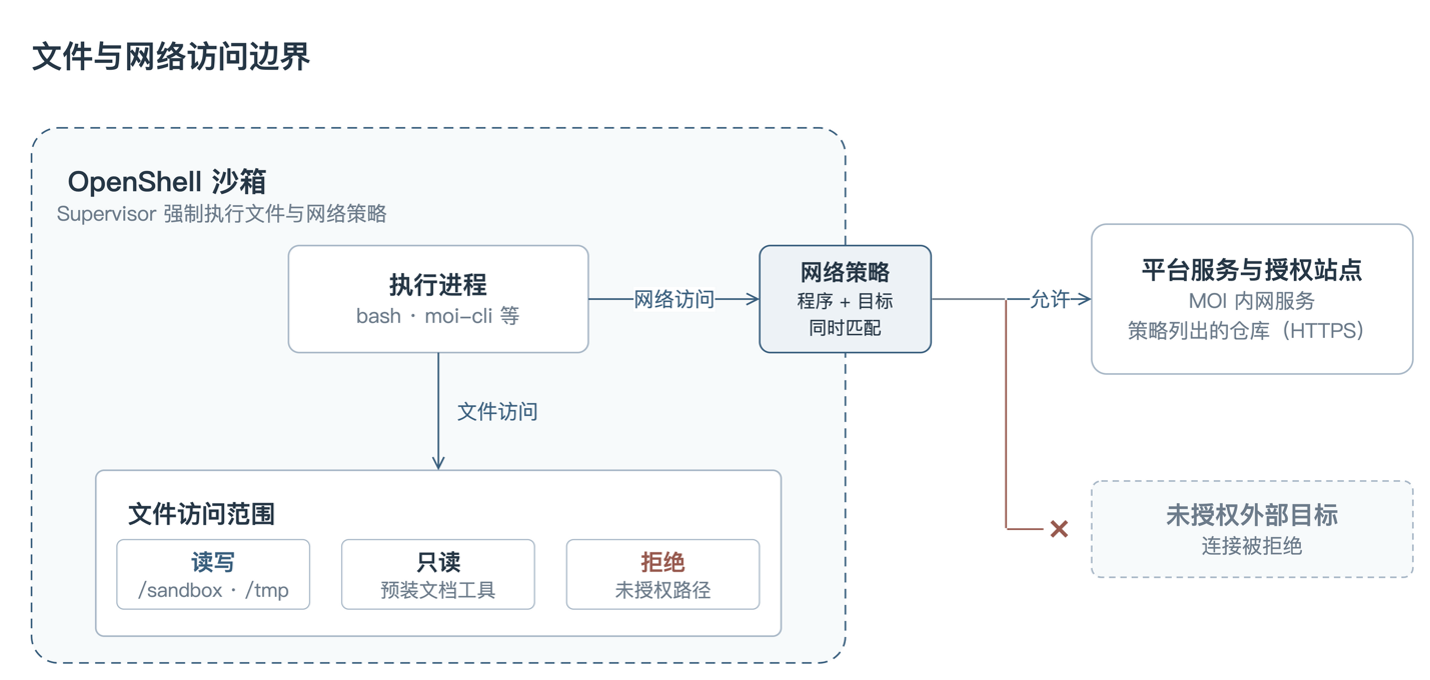
在 OpenShell 默认策略的基础上,MOI 为业务任务配置了明确的文件访问范围:Agent 在/sandbox/.moi 中处理任务,业务工作文件的写入限定在/sandbox 和临时目录/tmp;预装的文档处理工具设为只读,策略未授权的路径不可访问。文件系统策略在沙箱创建时确定,任务执行期间保持固定。
这些约束使 Agent 能够生成脚本、处理中间文件和输出报告,同时降低误读任务范围之外的资料、修改受保护工具的风险。即使生成的命令试图访问未授权路径,也会受到执行环境的限制,帮助控制错误操作的影响范围。
按程序与目标地址约束网络,减少非必要的数据出口
MOI 将内部服务访问与外部资源访问分别配置:内部工具经内网访问平台服务;git、pip、npm 等常用工具仅获准通过 HTTPS 连接策略列出的代码托管和软件包仓库等站点,其他未授权外部连接被拒绝。
这样的设计在保留依赖安装、代码获取等任务能力的同时,收紧了沙箱的网络出口。如果命令尝试连接未获授权的外部服务器,OpenShell 会阻止该连接,从而降低任务资料通过这些连接外传的风险。
网络访问策略控制的是连接权限。它需要与平台的数据授权机制配合,共同保护企业数据;对已获准访问的服务,仍需根据业务需要审慎配置权限。
以对话为单位隔离任务,让安全机制融入使用流程
MOI 为每段需要执行命令的对话分配独立沙箱,将执行环境绑定到当前对话。对话空闲达到设定时长后,平台销毁该沙箱,减少临时文件和运行时凭证长期驻留的机会,也降低不同对话共享执行环境带来的数据混用风险。
为了减少首次执行命令时的环境准备等待,MOI 预先创建一批空闲沙箱。当对话需要执行命令时,平台从池中分配沙箱,并自动补充空闲资源。沙箱的分配、回收和策略配置均由平台完成,用户可以直接围绕业务任务展开对话。
任务生成的文件会同步保存到 MOI 平台,沙箱回收后仍可下载。这使临时执行环境能够及时清理,同时保留用户需要的任务成果。
在这一设计中,OpenShell 提供沙箱及其策略执行能力,MOI 负责将这些能力组织成按需分配、自动回收的对话任务流程。安全隔离由平台统一落实,也减少了用户管理执行环境的负担。
为企业 Agent 建立可复用的安全执行基础
这项实践的价值,在于把文件访问、网络连接和任务隔离等要求,落实到 Agent 实际执行操作的环节:文件策略限制可读写范围,网络策略约束连接去向,独立沙箱与自动回收机制减少跨任务干扰和临时数据驻留。
对企业用户而言,这为 Agent 参与真实业务数据处理提供了更清晰的安全边界;对平台开发团队而言,OpenShell 提供了可集成的执行与策略机制,让团队能够在此基础上构建任务编排、数据工具和用户体验。
随着 Agent 承担更多企业工作,运行时安全将成为应用落地的重要基础。MOI 的实践展示了 NVIDIA OpenShell 在企业数据场景中的一种集成路径:将 Agent 的任务执行能力与明确的权限边界结合,让检索、分析和自动化任务在更安全、更易管理的环境中运行。
客户引语
“企业数据 Agent 要走进生产环境,安全是第一道门槛。NVIDIA OpenShell 的多层沙箱让 Agent 始终在最小权限下运行,使我们能够为企业客户构建既强大又可信的数据 Agent 执行环境。”
—— 矩阵起源 CTO 田丰
NVIDIA 开放智能体安全平台软件 (包括 OpenShell 和技能) 现可通过 NVIDIA 开发者资源页面及 GitHub 获取。
以 NVIDIA 开放智能体安全平台为代表的生态系统贡献,不仅支持开放安全 AI 联盟践行使命,也助力更广泛的 AI 安全与防护社区发展。该联盟由 NVIDIA 与 120 多家领先组织发起,并由 Linux 基金会负责治理;联盟通过开放研究、技能和工具,以及共享 AI 发现交换 (Shared AI Findings Exchange,简称 SAFE) 等项目,加强 AI 智能体的安全防护。
]]>
NVIDIA 今天正式发布的 AIOps 平台 NVIDIA Minerva,旨在帮助团队更早发现问题并保持 AI 工厂的工作效率。该平台将来自基础设施和 AI 工作负载的遥测数据整合在一起,并应用专门构建的 AI 模型,将这些数据转化为及时、可操作的洞察。
AI 工厂是当今世界上最复杂的运营系统之一,大量 GPU 通过高速网络互连,以训练模型并提供 AI 应用服务。在这种规模下,单个降级的组件可能会拖慢整个任务。这些警告信号可能很容易被忽略,例如 GPU 运行温度高于同类,或者 NVMe 驱动器在负载下性能衰减。
NVIDIA Minerva 专注于 AI 工厂产出,即基础设施实际产出的有效工作量,通过 GPU 小时数、有效吞吐量、集群正常运行时间和 Token 产出量来衡量。
提供 AI 工厂的动态视图
传统的监测工具通常会将数据中心划分为多个独立的视图。网络、计算、站点可靠性和机器学习团队各自关注不同的部分。Minerva 则可关联来自 NVIDIA GPU、网络、存储、调度程序和工作负载的信号。
借助这些信号,Minerva 构建了一个动态知识图谱,从逻辑上映射基础设施 (GPU、SuperNIC、交换机和线缆) 及其上运行的任务。凭借这种上下文信息,可以帮助运维人员追溯导致训练速度变慢的组件,即使在拥有数十万块 GPU 的工厂中也是如此。
Minerva 使用监督和无监督机器学习,每小时可分析数十亿个数据点。它可以学习系统的正常行为模式,检测从未见过的异常情况,预测潜在故障,并根据工厂的拓扑结构将相关事件关联起来。该平台不会将每一条警告逐一发送给运维人员,而是将“事件风暴”归拢为一个明确的事件,并指出最可能的原因。
Minerva 内置原生 AI 助手,并可对接外部智能体 AI 工具,提供基于实时遥测数据的自然语言界面。运维人员可以通过对话方式排查集群健康状况,并获取修复建议。团队既可以选择人工执行修复,也可以通过基础设施应用编程接口和外部系统,将 Minerva 接入到自动化系统以实现自动修复。
更大限度提高 AI 工厂的产出
Minerva 能够关联工作负载与基础设施问题,结合其智能体 AI 功能,有助于简化 AI 工厂运营。Minerva 不会发出海量的警报,而是将相关问题整合到一个可操作的事项中。这使得 AIOps 团队能够从被动响应转向主动维护,从而帮助 AI 工厂最大化 GPU 的正常运行时间。
Minerva 为 AI 工厂关注的核心指标提供了价值:
- 更长的无中断运行时间:Minerva 能够提前发现问题隐患,让任务运行时间更久而不被中断。
- 更快的修复速度:当事故确实发生时,Minerva 会精确定位问题,从而显著加快解决问题的速度。
- 更深入的洞察:现代 AI 基础设施会产生海量数据;Minerva 能够从中过滤,只留下极少数真正重要的警报。
IREN 是 NVIDIA 合作伙伴之一,使用了 Minerva 优化其 AI 工厂。
IREN 首席技术官 Denis Skrinnikoff 表示:“随着我们不断扩大 AI 工厂规模,为客户提供优质服务的关键在于更大限度地提高 GPU 的生产力。NVIDIA Minerva 为我们的运营团队提供了一个涵盖网络、GPU 及其运行任务的统一视图,让我们更专注于主动维护,而非故障排除。这种可见性强化了我们的运营模式,为接下来构建的新一代基础设施提供支持。”
除 IREN 外,Aolani、BitDeer AI、IBM、Jio、Lambda、Quake AI 和特斯拉也计划部署 Minerva。
此外,戴尔科技、联想和 Supermicro 将把 Minerva 纳入其 AI 工厂运营产品组合中。
点击链接,详细了解 NVIDIA Minerva。
点击查看软件产品信息声明。
]]>- 全球领先的电信运营商正在其网络中全面扩展由 NVIDIA 提供支持的计算能力,旨在将先进的服务更贴近个人与企业用户,提升无线网络体验,并实现网络运营的自动化。
- T-Mobile 已在商用网络上完成了全球首次 AI-RAN 通话;与此同时,英国电信 (BT)、德国电信 (Deutsche Telekom) 和 Elisa 宣布在现网中开展 AI-RAN 试点,这些试点采用了运行在 NVIDIA Aerial RAN Computer 上的、由 NVIDIA CUDA 加速的诺基亚 anyRAN 软件。此外,NVIDIA 还针对高容量站点推出了全新的 Aerial RAN Computer 配置。
- 目前,共有九家 EMEA (欧洲、中东和非洲) 地区的电信运营商正在集中式和分布式节点中建设并扩展由 NVIDIA 提供支持的基础设施。
- 各运营商及软件合作伙伴正在采用 NVIDIA Nemotron 开放模型,以提供智能体服务,并为自主网络运营开发 AI 智能体。
NVIDIA 今日宣布,全球领先电信运营商正将其网络转变为分布式智能平台,通过在集中式数据中心、城域站点和基站站点引入 NVIDIA 加速计算,运营商能够将模型和应用更贴近使用它们的个人、企业和机器。
T-Mobile 已与 NVIDIA 和诺基亚合作,在华盛顿州贝尔维尤的现网中完成了全球首次 AI-RAN 通话。德国电信正在推进面向行业的物理 AI 应用,Orange 则为企业和应急响应人员推出全新语音智能服务。芬兰运营商 Elisa 已完成欧洲首次 AI-RAN 外场测试,通过 5G 网络在一个单一加速计算平台上同时运行了语音、移动数据和视觉 AI 业务;英国电信也正在为英国的 AI-RAN 现网测试做准备。此外,诺基亚正将其 anyRAN 软件部署在 NVIDIA Aerial RAN Computer(ARC) 上,以供英国电信、德国电信、Elisa 和 Orange 开展相关试验。
来自欧洲、中东和非洲 (EMEA) 地区的九家运营商正在建设或扩展 NVIDIA 驱动的基础设施,同时诺基亚和思科正将 NVIDIA Nemotron 开放模型集成到运营商用于运行自主网络的软件中。
“电信网络的初衷是承载全球的通信交流。而现在,它们还将承载全球的智能,”NVIDIA 创始人兼首席执行官黄仁勋表示,“全球领先的运营商正将他们的土地、电力和连接资源转化为分布式 AI 基础设施 —— 让智能更贴近使用它的各行各业、普通大众以及机器人。通过与诺基亚的合作,我们正在将加速计算直接延伸至无线网络本身,从而为 AI 原生 5G 奠定坚实的基础。”
智能体系的构建分为五个层级:土地、电力与机房、芯片、基础设施以及模型与应用。电信运营商已在第一层拥有自主可控的基础设施,包括具备电力、光纤和频谱资源的数据中心、区域站点和基站站点。
通过在此基础上叠加 NVIDIA 加速计算、开放模型和应用,运营商正将完整的智能栈融入其网络中。在分布式站点,一个基于 AI-RAN 架构的通用融合平台可以提供开放模型、驱动机器人、语音和智能体应用,并运行智能 5G 软件。
欧洲领先电信运营商构建分布式基础设施
基础设施是电信向分布式服务平台转型的基石。
德国电信计划扩展其由 NVIDIA 驱动的工业 AI 云,该云平台托管包括 NVIDIA Nemotron 和 Soofi 在内的开放模型,并为思灵机器人等机器人公司提供服务。在分布式站点,Deutsche Telekom 正与诺基亚和 NVIDIA 合作开展 AI-RAN 试点,并演示 NVIDIA ARC 如何在终端和网络边缘之间运行推理。
在 GTC 柏林上,NVIDIA 与思灵机器人联合展示了这一方案:机器人本体智能负责实时感知和动作执行,分布式边缘的模型支持多机器人的微调和协同,而中心基础设施则为更大规模训练工作负载提供算力。
Orange 在其 Live Intelligence 可信 AI 平台之上,以托管服务的形式托管了包括 NVIDIA Nemotron 在内的开放模型,为企业提供新的先进服务。在分布式站点,Orange 正部署 NVIDIA ARC,利用 Nemotron Speech 构建的语音智能应用,演示了帮助应急和现场服务团队的新服务,协助他们以低延迟、高可靠性进行多语言实时翻译。
Elisa 已在一个分布式网络站点部署了 NVIDIA ARC,运行作为企业助手的语音智能应用,并使用开放模型构建边缘应用。
EMEA 地区的电信运营商正在建设或扩展 NVIDIA 驱动的基础设施:
- 新建基础设施:捷克的 CRA、阿联酋的 etisalat、格鲁吉亚的 Silknet 和意大利的 TIM
- 扩展项目:非洲的 Cassava、德国电信、意大利的 Fastweb + Vodafone、中亚的 Kazakhtelecom 和塞尔维亚的 Orion Telecom
AI-RAN 将加速计算引入无线网络
AI-RAN 将加速计算扩展到无线接入网 (RAN),使其成为一种与先进服务在同一平台上运行的智能工作负载,从而使运营商能够在更充分利用频谱资源的同时,并在靠近用户的站点提供服务。
在全球范围内,已有近 20 家电信运营商公开宣布使用诺基亚 anyRAN 软件和 NVIDIA ARC 开展 AI-RAN 合作。
- T-Mobile 近日在华盛顿州贝尔维尤的商用网络上完成了全球首次 AI-RAN 通话,该通话运行在商用 ARC 服务器、诺基亚以 NVIDIA CUDA 加速的 RAN 软件和大规模多输入多输出 (MIMO) 无线设备上,并接入现有的 5G 独立组网核心网和商用智能手机。
- 英国电信计划于 2027 年在英国伯明翰与诺基亚和 NVIDIA 开展 AI-RAN 现网测试。
- 德国电信已在 Bonn 和 Oulu 的实验室验证了诺基亚和 NVIDIA 的商用 AI-RAN 平台,包括利用 AI 增强的上行信道估计来提高上行用户吞吐量,并计划于 2027 年进入外场测试阶段。
- Elisa 在 NVIDIA ARC 平台上同时运行了语音、移动数据和视频分析。这是欧洲首次在 Elisa 使用 5G 频谱的空中 (OTA) 现场测试环境中进行。该测试为 2027 年的分布式部署和商用 AI-RAN 服务铺平了道路。
- Orange 正在 NVIDIA ARC 上测试诺基亚 5G 软件,重点关注 AI-RAN 频谱效率的提升以及对现网边缘服务的支持。
NVIDIA 推出了两款 ARC 配置 —— MGX 2U 和 MGX 4U,专为高密度、高容量的智能和无线工作负载设计,通常部署在集中式 RAN 站点。这些配置由 NVIDIA RTX PRO Blackwell 服务器版 GPU 驱动,并提供 x86 和 NVIDIA Vera CPU 选项。戴尔科技、云达科技 (QCT) 和 Supermicro 将提供 ARC 就绪的服务器。
开放模型驱动自主网络运营
领先的电信运营商正使用开放模型和智能体加速迈向完全自主的网络运营。NVIDIA Nemotron 开放模型和 NVIDIA Agent Toolkit 软件现已集成到领先合作伙伴的商用软件中,为专为电信网络工作流构建的专用智能体提供支持。
诺基亚正将 NVIDIA Nemotron 集成到其 Autonomous Networks Suite 中,并使用 NVIDIA Agent Toolkit 软件构建和部署可信智能体,以管理固定、无线网络、核心和传输网络的运营。
思科对 NVIDIA Nemotron 模型进行了微调并将其集成到 Crosswork AI 中,在其 Crosswork Network Automation 软件中创建了一个通用的智能体层,用于管理 IP 和光传输网络。该公司还使用 NVIDIA Agent Toolkit 帮助电信运营商安全地运行智能体。
TCS 正与电信运营商合作微调 NVIDIA Nemotron 模型,并使用 NVIDIA Agent Toolkit 构建专用智能体,用于验证无线站点建设情况、检测诊断并自动修复网络问题,还能提供多语言语音体验。英国电信正采用 Nemotron 构建智能体,用于检查现场安装照片、发现问题并帮助减少重复去现场的次数。
NTT DATA 正通过经过微调的 NVIDIA Nemotron 模型和 NVIDIA Agent Toolkit 来扩展其 NextGenOSS 平台,构建能够检测早期网络性能衰退、识别可能原因并提出后续建议操作的智能体。
观看 NVIDIA CEO 黄仁勋 GTC 柏林主题演讲,了解更多精彩会议。
]]>NVIDIA 正在构建覆盖全栈的工具,以实现安全智能体。今日宣布推出的 NVIDIA OpenShell 参考架构是 NVIDIA 日益丰富的技术组合的一部分,旨在帮助组织大规模部署安全智能体。NVIDIA 机密计算作为基础设施层,可在这些智能体运行时保护其所依赖的模型和数据。
今天,NVIDIA 正通过推出 Confidential Bare Metal 进一步扩展这一安全层,这是一种全新的 NVIDIA 机密计算部署选项,使前沿模型构建者能够在专用的第三方基础设施上运行敏感工作负载,同时保留对其模型和数据的控制权。
NVIDIA 推出全新的平台安全控制措施,用于保护传输中的数据、验证平台完整性并强制执行硬件级访问限制。这些新控制措施使前沿模型构建者在第三方云、新兴云及企业基础设施上的 NVIDIA 加速计算基础设施上运行时,能够使用裸金属实例来自主拥有和运营其定制软件栈 (包括主机和平台基础设施软件)。
NVIDIA 机密计算现在提供了一种融合安全架构,包含三种部署选项:
- 适用于裸金属基础设施的 Confidential Bare Metal
- 适用于 Kubernetes 环境的 Confidential Containers
- 适用于虚拟化环境的 Confidential Virtual Machines
各组织可以根据其信任边界和运营要求匹配合适的模型。
NVIDIA 机密计算也正在扩展至 NVIDIA Grace Blackwell 和 Rubin 系统,并将与 NVIDIA DSX OS 集成,作为云服务提供商构建 AI 工厂的参考架构。
模型构建者释放全球算力
Confidential Bare Metal 为受支持的提供商提供了一条路径,使其能够承接对模型和数据隐私保护要求极高的高价值工作负载。对于模型构建者而言,不断扩展的生态系统为全球范围内的训练和推理扩展提供了更多地域、自主可控能力和运营选择。
Cohere 计划将 Confidential Bare Metal 集成到 Cohere Model Vault 中,依托 NVIDIA 机密计算的可信执行环境 (TEE) 将硬件级安全能力直接延伸至 GPU,在运行期间保护内存和互连中的模型与数据。
Cohere 首席技术官 Phil Blunsom 表示:“企业信赖 Cohere,因为我们能够为其提供安全且具备机密性的推理平台。通过在 Cohere Model Vault 中引入 NVIDIA 机密计算,我们将硬件级安全能力直接延伸至 GPU,从而在执行期间保护客户数据在内存和互连中的安全。”
Google Cloud 正将 Confidential Bare Metal 的支持扩展至由 NVIDIA Grace Blackwell Ultra 系统驱动的 A4X Max 实例。这些实例将非虚拟化的 NVIDIA 加速计算与加密保护相结合,以保障训练数据和模型知识产权的安全。
Google Cloud 杰出工程师兼 AI 基础设施安全负责人 Andrés Lagar-Cavilla 表示:“Google Cloud 推出 Confidential Bare Metal,旨在为 AI 实验室提供硬件隔离的非虚拟化计算环境,以及端到端加密保护。我们基于 NVIDIA 机密计算构建的 A4X 实例能够保护用户数据隐私、模型知识产权,并提供顶级的服务性能。”
机密计算在 NVIDIA 平台全面扩展
NVIDIA 机密计算使用硬件级隔离和加密证明,在运行期间保护模型和数据。
CoreWeave、Firmus、GMI Cloud、Google Cloud、IREN、Lambda、Microsoft Azure Infrastructure、Nebius、Nscale 和 Vultr 均支持 NVIDIA 机密计算部署。包括思科、戴尔科技、HPE、联想、Supermicro 和 Bull 在内的全球系统合作伙伴将通过企业级 NVIDIA 认证系统提供上述技术支持。
NVIDIA DSX OS 将支持 NVIDIA 机密计算的所有模式,为云服务提供商提供一个软件基础,用于构建和运营支持机密工作负载的 AI 工厂。
了解更多关于 NVIDIA 机密计算的信息。
]]>新闻摘要:
- NVIDIA OpenShell 参考架构提供企业级治理、隔离与安全保障,用于跨企业级基础设施和边缘系统构建、隔离、观测并执行安全智能体。
- 该架构基于 NVIDIA OpenShell 安全运行时软件构建,集成了用于模型推理的 NVIDIA Vera Rubin 基础设施、用于智能体 Harness 与工具调用的 NVIDIA Vera CPU,以及运行 NVIDIA Sentry 在实现芯片内执行的 NVIDIA BlueField-4 DPU。OpenShell 参考架构通过 NVIDIA RTX Spark、NVIDIA DGX Spark 和 NVIDIA DGX Station 系统扩展到边缘。
- OpenShell 参考架构可在主流企业级操作系统上运行,包括 Canonical、Red Hat、Microsoft Windows 以及 Microsoft Execution Containers。
- Anthropic、AWS、思科、CrowdStrike、达索系统、戴尔科技、Google Cloud、HPE、IBM、Meta、微软、OpenAI、Palo Alto Networks、Perplexity、SAP、ServiceNow、西门子、SpaceX Super Intelligence 等公司正在使用 OpenShell 参考架构,以增强智能体部署的安全性。
GTC 柏林 —— NVIDIA 今日宣布推出 NVIDIA OpenShell 参考架构,该架构能够在企业级基础设施和边缘系统上构建、隔离、观测和执行安全智能体。
OpenShell 参考架构基于 NVIDIA OpenShell 安全运行时软件为基础进行构建,并将其扩展到用于智能体开发和运行的全栈式、工业级基础设施。
它包括用于运行企业工作负载 (包括使用 NVIDIA Nemotron 构建的闭源和开放模型) 的 NVIDIA Vera Rubin 基础设施;用于运行智能体 Harness 的 NVIDIA Vera CPU;开源的 NVIDIA OpenShell 软件;以及用于运行 NVIDIA Sentry 统一安全软件框架的 NVIDIA BlueField® DPU,该框架可对智能体行为进行持续带外监测并实现在芯片内的策略实施。
OpenShell 参考架构可借助 NVIDIA RTX Spark、NVIDIA DGX Spark 和 NVIDIA DGX Station 系统扩展至在零售、医疗、制造、机器人、软件开发和电信等行业的边缘运行的智能体。
NVIDIA 创始人兼首席执行官黄仁勋表示:“AI 能力和安全性必须共同发展,随着企业准备部署数十亿个 AI 智能体,安全和管控必须构建到计算架构中。NVIDIA 创建了 OpenShell,让智能体可以在明确界定的边界内自由执行有价值的工作 —— 使其受到约束、受到监测且处于管控之中。借助 OpenShell 参考架构,智能体可以在 Rubin 上思考,在 Vera 上采取行动,并在 BlueField 上受到治理。”
为智能体构建的全栈基础设施
OpenShell 参考架构的特性是将 NVIDIA 加速计算与用于安全智能体运行的软件相结合。
- NVIDIA Vera CPU 的性能是 x86 处理器的 2 倍,且能效更高,同时它还能运行 NVIDIA OpenShell,这为自主智能体提供了安全的运行时边界。
- NVIDIA BlueField-4 DPU 通过基于 NVIDIA DOCA 软件构建的 NVIDIA Sentry,可持续监测智能体行为。BlueField 和 NVIDIA Sentry 共同提供了芯片内执行安全策略 —— 如果智能体试图移动到其软件边界之外,NVIDIA Sentry 会在毫秒内将其隔离并阻断。由 DOCA 提供支持并运行于 BlueField-4 上的 NVIDIA Sentry,可将智能体容量提升高达 20%。
NVIDIA 合作伙伴借助 OpenShell 构建安全智能体部署
NVIDIA 正在与构建基础设施、模型和软件的行业领导者合作,使各行业能够在生产中安全地部署智能体。
OpenShell 参考架构在领先的企业级操作系统和隔离编排层上运行,包括由 Canonical、SUSE 和 Red Hat 提供支持的 Linux 和 Kubernetes 基础设施,以及使用 Microsoft Execution Containers (MXC) 的 Microsoft Windows。它可以在 Amazon Web Services、Google Cloud 和 Microsoft Azure 的云操作系统上运行。
企业可以在 OpenShell 基础设施上运行来自模型构建商的智能体,包括 Anthropic、Cohere、Google、Meta、OpenAI、Perplexity、Reflection 和 SpaceX Super Intelligence。NVIDIA 还正就 OpenShell 部署与模型构建商合作伙伴合作,以进行前沿模型研究。
网络安全领导者 1Password、Check Point、CrowdStrike、思科、F5、Fortinet、微软、Okta、Palo Alto Networks、TrendAI 和 Zscaler 正在将其对 OpenShell 参考架构的支持集成到其智能体安全解决方案中。
包括欧洲的 BBVA 和 Santander 在内的领先银行正在与 NVIDIA 协作,探索将 OpenShell 参考架构作为加强智能体安全、保障和治理的框架。
企业软件领导者 Cadence、达索系统、IBM、SAP、西门子和新思科技正在使用 OpenShell 构建智能体软件平台。Palantir 与 NVIDIA 正协助客户在生产环境中部署安全的智能体。
SAP 正将 NVIDIA OpenShell 参考架构与 SAP Business AI Platform 中的 Joule Studio 运行时相集成,从而连接业务治理与安全智能体执行。
ServiceNow 今日宣布全面推出 ServiceNow Arc,这是一款个人长时间运行的 AI 智能体,其行为在运行时由 ServiceNow Super Intelligence Control Tower 进行治理,并由 NVIDIA OpenShell 执行。此外,ServiceNow 最近发布的 AI Passport 授权层将这些策略引入 NVIDIA OpenShell 和 NVIDIA Sentry,助力企业在几秒钟内撤销 AI 智能体跨软件和硬件的访问权限。
NVIDIA 系统制造商戴尔科技、思科、HPE、联想和 Supermicro 均使用 OpenShell 参考架构构建基础设施。
NVIDIA 还在与包括 CoreWeave、Crusoe、Firebird、Firmus、GMI Cloud、IREN、Lambda、Nebius、Nscale、Oracle Cloud Infrastructure 和 Vultr 在内的云服务提供商协作部署支持 OpenShell 的基础设施。
包括 Baseten、Deepinfra、Fireworks 和 Together AI 在内的推理和后训练服务提供商正在将 OpenShell 参考架构集成到其模型开发管线中。
可用性
NVIDIA OpenShell 参考架构现已推出。
关于 NVIDIA
NVIDIA (NASDAQ:NVDA) 是 AI 和加速计算领域的全球领导者。
该新闻稿所含若干陈述包括 (但不限于) 有关以下各项的陈述:对 NVIDIA 产品、服务和技术的发展、性能、可用性和优势的预期,以及相关趋势和驱动因素;对 NVIDIA 与协作者及合作伙伴的第三方安排的预期,以及相关部署、可用性和时间安排;对技术发展及相关趋势和驱动因素的预期;对企业采用和部署 AI 智能体及相关安全、治理和管控的预期;市场预期增长和趋势;对 AI 及相关行业的预期;以及其他非历史事实的陈述均属前瞻性陈述,这些都是符合 1933 年《证券法》第 27A 条 (经修订) 和 1934 年《证券交易法》第 21E 条 (经修订) 所定义的前瞻性声明。前瞻性声明受到这些法律条款创建的“安全港”保护,其依据为管理层的信念与假设以及当前可获得的信息,但同时也受到多种风险与不确定因素的影响,这些因素可能导致实际结果与预期产生重大差异。可能导致实际结果产生重大差异的重要因素包括:全球经济及政治状况;NVIDIA 依靠第三方来制造、组装、包装和测试 NVIDIA 的产品;技术发展和竞争的影响;新产品和技术的开发或者现有产品和技术的升级;NVIDIA 产品或合作伙伴产品的市场认可度;设计、制造或软件缺陷;消费者偏好或需求的变化;行业标准和接口变化;NVIDIA 产品或技术在集成到系统中时发生的意外性能损失;NVIDIA 将商业投资或收购的潜在收益转化为实际效益的能力;以及适用法律法规的变化;NVIDIA 向美国证券交易委员会 (SEC) 提交最新报告中不时详述的其他因素,这些报告包括 (但不限于) 采用 10-K 表的年度报告和采用 10-Q 表的季度报告。向 SEC 提交的报告的副本均在 NVIDIA 的官方网站上发布,并可免费下载。以上前瞻性陈述并非未来表现的保证,仅以本协议日期为准;除法律要求外,NVIDIA 不承担更新以上前瞻性陈述以反映未来事件或情况的任何义务。
本新闻稿所述的许多产品和功能目前仍处于不同阶段,并将在具备条件且可用时推出。上述声明并不构成,也不应被解释为任何承诺、保证或法律义务。文中提及的任何产品功能或特性的开发、发布及时间安排均可能发生变化,并完全由 NVIDIA 自主决定。对于本文所述任何产品、功能或特性的未能交付或延迟交付,NVIDIA 不承担任何责任。
© 2026 NVIDIA Corporation 保留一切权利。NVIDIA、NVIDIA 商标以及其他 NVIDIA 产品和服务名称均为 NVIDIA Corporation 在美国及其他国家和地区的商标和 / 或注册商标。其他公司、产品和服务名称可能是与其相关的各家公司的商标。
]]>在GTC 柏林上,NVIDIA 展示了全系列本地 AI 硬件。RTX Spark 于上周上市, 为 Windows PC 上的个人智能体提供算力支持。DGX Spark 则助力开发者在 Linux 上构建应用和扩展集群规模。
此次发布的内容包括:
- Underdog 桌面智能体现已支持 RTX Spark
- DGX Spark 64GB 将于 10 月 23 日星期五上市
- NVIDIA Sync 将于本月支持连接 8 台 DGX Spark,并新增 Model Launcher
- DGX Spark 10 月软件更新新增 Wi-Fi Assistant,并更新 DGX Spark Skills
- 全新本地编程模型 Recursive Flint 现已支持 NVIDIA 本地硬件
- 首日即支持全新 Nemotron、GLM、DeepSeek、Qwen、MiniMax 和 FLUX.3 AI 模型
- 为 llama.cpp 和 vLLM 推理引擎带来全新加速,并推出针对本地 AI 硬件优化的全新 checkpoints 。
在下方了解更多本地 AI 相关公告,并观看演示及 GTC 柏林议程。
RTX Spark 将个人智能体带到 Windows PC
RTX Spark 为 Windows PC 开启新序章,搭载至高 128GB 统一内存和 1 Petaflop AI 算力,支持运行个人智能体、加速内容创作,以及 1440p 分辨率、超过 100 FPS 的游戏体验。
自 10 月 16 日上市以来,首批评测媒体对该平台给出了以下评价:
“专业创作者梦寐以求的设备…” — CGMag
“为 AI 的未来而设计…” — The Verge
“性能强劲,便携性和能效令人惊喜…” — PCMag
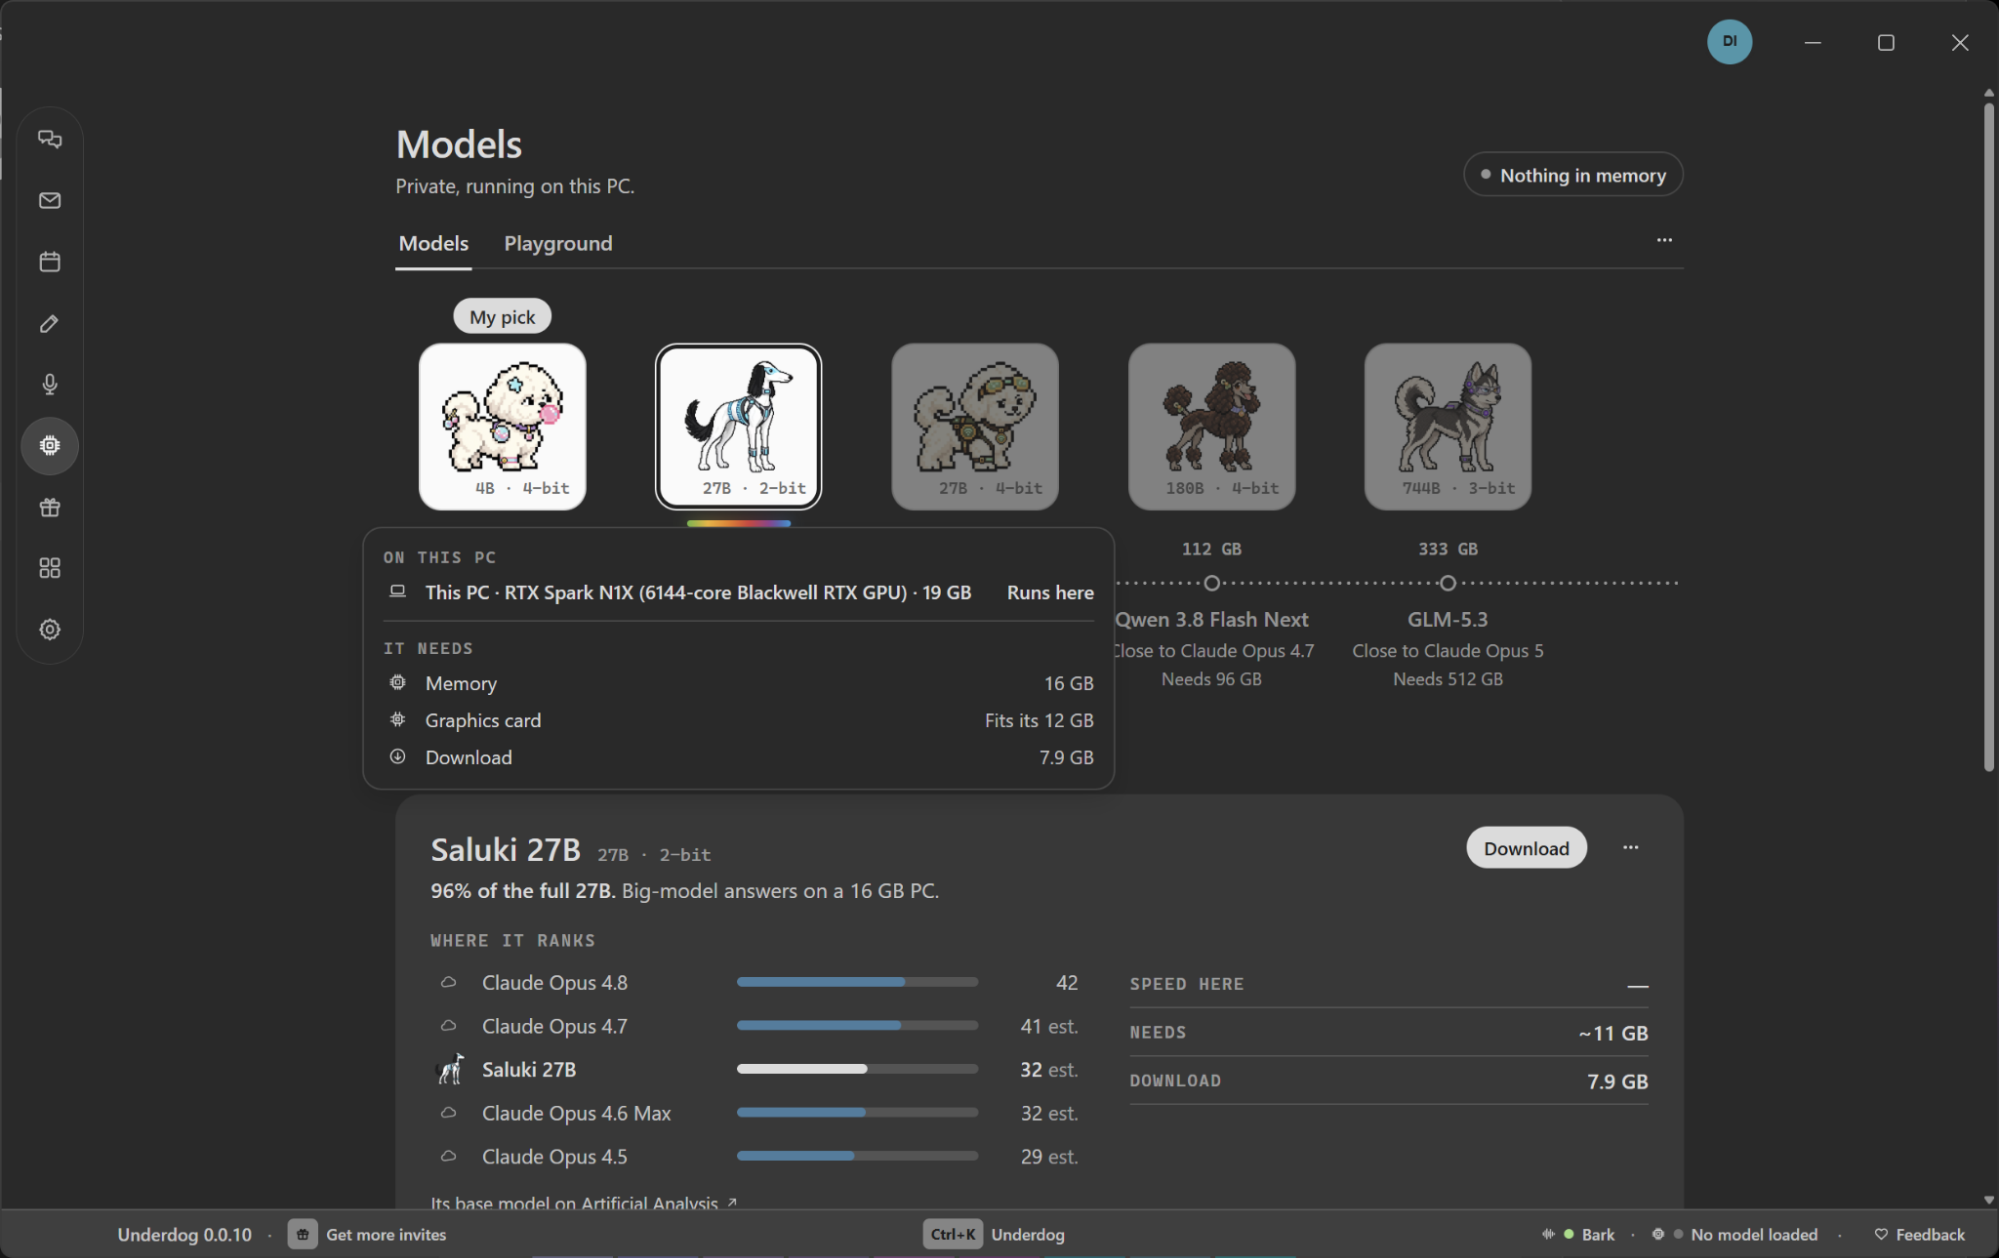
Underdog 是一款专为完全在本地运行、保护隐私的 AI 而打造的全新桌面智能体应用,也将登陆 RTX Spark。借助针对特定模型的 Husky 推理引擎,Underdog 可完全在设备上运行模型,让个人智能体完成工作,确保用户数据始终留在本地 PC。
为更好地支持开发者和爱好者构建、定制本地智能体,多款 RTX Spark 笔记本电脑均配备已解锁的引导加载程序 (bootloader)。
在 GTC 主题演讲中,NVIDIA 创始人兼首席执行官黄仁勋展示了如何借助在 RTX Spark 上运行的 AI 智能体,使用 NVIDIA Isaac Lab、Hermes Agent 和 Nemotron 3.5 Bolt 74B 训练 Hugging Face 的 Microduck 机器人。
华硕、戴尔、联想、微软和微星的笔记本电脑现已上市,宏碁产品也将于近期推出。
DGX Spark 为开发者提供更多开发空间
全新 DGX Spark 64GB 将于 10 月 23 日星期五起由合作伙伴陆续推出,可运行 Nemotron 3.5 Bolt 74B 24GB、Qwen3.8 27B 和 Gemma 4 26B-A4B 等模型。
当工作负载需要更大容量时,开发者可借助内置的 NVIDIA ConnectX-7 网卡和 NVIDIA Sync Cluster Assistant 连接多台 DGX Spark,运行 Qwen 3.8 Flash Next、DeepSeek v4 Flash 0731 和 GLM 5.3 Flash 等先进编程模型。
DGX Spark 现可通过手动配置组建最多 8 台设备的集群,以运行更大的模型、更长的上下文、并支持智能体的并发运行和分布式开发。该集群适合作为小型团队的共享后端,让每位开发者都能针对同一模型运行并发会话。集群可提供 1TB 的统一内存,足以运行 GLM 5.3 等前沿级模型。
参阅 DGX Spark 集群 Playbook,快速开始部署。
NVIDIA Sync Model Launcher 将于本月晚些时候推出,简化在单台 DGX Spark 或集群上使用本地 AI 的流程。只需点击几下,Model Launcher 即可下载适合相应配置的模型和容器,并将模型连接到 OpenCode。它还会自动加载 DGX Spark Skills,用于故障排查、设备维护、访问官方文档,以及提供其他工作流指导。
DGX Spark 10 月软件更新带来全新的 Wi-Fi Assistant,让用户在 DGX Spark 以专用设备 (appliance) 模式运行时切换网络。此外,DGX Spark Skills 通过 OpenCode,直接在 NVIDIA Sync 中提供面向工作流的故障排查与设备维护指导。
用户现可直接从宏碁、华硕、戴尔、技嘉、惠普、联想、微星和 NVIDIA 购买 DGX Spark。
推出 Recursive Flint —— 一款针对 RTX Spark 优化的全新本地编程模型
10 月 21 日,前沿 AI 实验室 Recursive Superintelligence 发布了 Recursive Flint,这是一款专为快速、准确编程而打造的本地大语言模型 (LLM)。 Recursive Flint 是一个拥有 400 亿参数、25 亿激活参数的混合专家模型 (MoE),在 64GB RTX Spark 上的推理速度超过 220 tk/s,并在 SWE-Bench Pro v2、Terminal-Bench 2.1 和 SWE-bench verified 等智能体编程基准测试中取得同类领先的成绩。
Recursive Flint 使用 Recursive 的 Eureka Machine 构建,该系统专为大规模自动化 AI 研究而设计。它可自动完成整个研究循环:提出想法、实现想法、运行实验验证想法,再根据结果决定下一步尝试方向。系统创建了专用计算内核,在不改变模型权重的情况下,将 Flint 在 RTX Spark 上的生成速度提升了 55%。
开发者可在 Hugging Face 下载以 Apache 2.0 许可开放的模型权重,并在 RTX Spark、DGX Spark,以及 GeForce RTX 和 RTX PRO GPU 上运行该模型。
查看 Recursive Superintelligence 的发布博客,了解更多详情。
首日支持全新模型
NVIDIA 将从发布首日起支持 NVIDIA Nemotron Bolt E4B 4B、GLM、DeepSeek、Qwen、MiniMax,以及 FLUX.3 Klein 扩散模型。
Nemotron Bolt E4B 4GB 仅需 4GB 内存,即可实现自然对话和多轮智能体任务能力,为 NVIDIA GeForce RTX GPU、NVIDIA Jetson 设备,以及 RTX Spark 和 DGX Spark 上的快速本地语音助手、交互式游戏角色和嵌入式界面提供支持。Bolt E4B 4GB 将于 10 月 23 日发布。
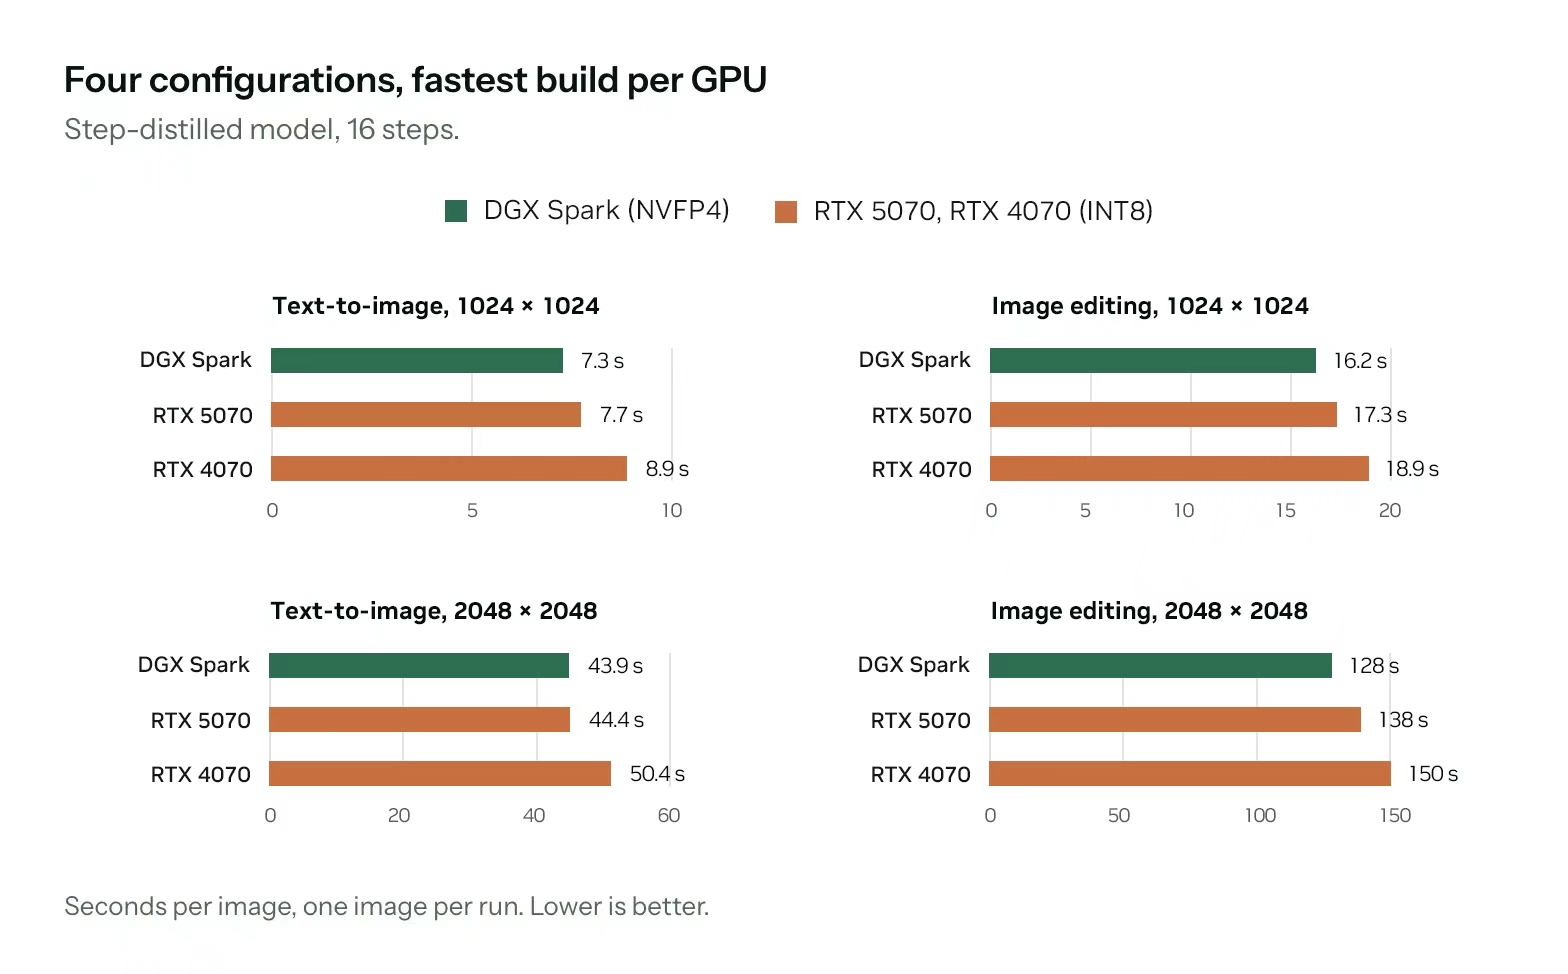
Black Forest Labs 的 FLUX 3 Image Klein 是一个拥有 56 亿参数的开放权重图像模型,可用于图像生成和编辑。NVIDIA 优化的版本仅需 8GB 显存即可在 GeForce RTX GPU 上运行。
MiniMax M3.1 Flash 是一款专为 DGX Spark 打造的全新开放模型,将长上下文 AI 带到桌面。Liquid AI 的 LFM2.5-24B-A2B 是一款开放权重推理模型,每处理一个 Token,仅激活其 240 亿参数中的 20 亿参数,从而实现快速运行,让用户可直接在 PC 上运行注重隐私、支持工具调用的 AI 智能体。
此外,NVIDIA 发布了一组全新的模型 checkpoints,针对本地 AI 硬件的内存使用效率进行优化, 让前沿级开放模型运行时,仍能为 KV 缓存留出充足内存。每个 checkpoint 都经过量化,同时保持接近全精度的准确性。首批包括可在单台 DGX Spark 128GB 上运行的 Qwen3.8-Flash-Next-FP4-Local,以及可在两台 DGX Spark 上运行的 GLM-5.3-Flash-FP4-Local。
加速 AI 推理
NVIDIA 持续与 llama.cpp 和 vLLM 等开源社区合作,加速本地硬件上的智能体工作负载。
在 llama.cpp 中,面向 Qwen 3.8 Flash Next、基于多 Token 预测 (MTP) 的全新推测解码支持,可将 NVIDIA RTX PRO Blackwell 上的端到端智能体任务执行速度最高提升至 1.4 倍。
在 vLLM 中,更快的推测解码,以及面向 Qwen 线性注意力层的全新 FlashInfer 预填充内核,可将 DGX Spark 上 Qwen3.8 27B 智能体任务的执行速度至高提升 1.3 倍。
NVIDIA RTX AI PC 的相关信息请关注微博、抖音及哔哩哔哩官方账号,并订阅 NVIDIA 本地 AI 新闻,及时了解最新动态。软件产品信息请查看声明。
]]>新闻摘要:
- NVIDIA 推出 DSX POD,这是一套面向完整 Vera Rubin AI 工厂的参考设计,由合作伙伴在模块化集装箱内构建,并在交付前完成系统集成和验证。
- 这种出厂预装的设备,可将场地准备就绪后的部署时间从六个月大幅缩短至最快 14 天,帮助客户更早开始生成生产级 Token 并创造收益。
- NVIDIA 正与全球的计算和基础设施合作伙伴合作,计划于 2027 年初在全球范围内交付这种模块化 AI 工厂。
NVIDIA 今日推出 DSX POD,这是一套完整的 NVIDIA Vera Rubin AI 工厂参考设计。该产品由合作伙伴在模块化集装箱内构建,在交付前完成系统集成与验证。这些设备出厂即处于可连接状态,运抵现场后,可直接接入已就绪的电力、冷却、网络及其他配套基础设施,将部署时间从六个月大幅缩短至最快 14 天。
DSX POD 将计算、网络、布线、机架级供电和液冷的集成和安装工作转移到制造工厂,从而大幅减少了传统现场建设所需的繁杂规划、施工、专业人工和物流调度。这些在工厂内完成测试的集装箱,不仅降低了零部件延迟的风险,还避免了成本高昂且极易出错的现场施工作业。这为客户打通了通往模型训练与生产级推理的捷径,使其能够更早开始生成 Token 并创造收益。
NVIDIA 创始人兼首席执行官黄仁勋表示:“AI 工厂只有在开始生产 Token 时才能创造价值,而不是在工程竣工时。借助 NVIDIA DSX POD,我们将工厂预装的精准与高效引入了 AI 基础设施建设 —— 将部署时间从数月缩短至数周,从而帮助客户更快地扩展算力规模,让能够创造收益的生产级系统早日上线。”
工厂预装基础设施
NVIDIA DSX POD 将 Vera Rubin 系统与运行这些系统所需的基础设施整合为可重复量产的工厂预装集装箱设计,由合作伙伴规模化制造与交付。
它延续了更广泛的 NVIDIA DSX 基础设施平台的设计理念,采用独特的架构,在运输和部署前,在专用集装箱内完成系统的集成和验证。合作伙伴在发货前完成机架间的布线、接线、管路铺设及功能验证。这项工作与现场场地准备并行推进,从而进一步缩短了新算力上线所需的时间。
更早投入生产,正是连接部署速度与经济效益的关键纽带。“首个 Token 生成时间”标志着一座全新 AI 工厂开始运行模型以处理生产级工作负载,这也让运营商能够更早地将其基础设施投入使用,为客户服务。
全球生态系统合作伙伴和上市时间
NVIDIA 正在与 Anduril、Armada、Bull、Crusoe、DayOne、戴尔科技、Delta、Eaton、Foxconn (Ingrasys)、技嘉、HPE、联想、和硕、云达科技 (QCT)、施耐德电气、Vertiv 和纬创合作,于 2027 年初在全球范围内交付 DSX POD AI 工厂。
观看 NVIDIA CEO 黄仁勋 GTC 柏林主题演讲,了解更多精彩会议。
]]>天气预报影响的远不止于日常出行规划;及时掌握天气信息对能源生产商、保险公司和交通运输运营商至关重要,这能够帮助他们根据不断变化的天气状况制定规划。全球预报能够显示风暴的生成趋势,但针对太阳能电站、航运路线或受保资产的决策,最终还是要取决于当地的具体天气状况。
NVIDIA Earth-2 为开发者和研究人员提供了一系列开放 AI 模型与工具,支持他们利用自有数据进行定制。依托 NVIDIA 计算平台运行,这些技术能够支持全球天气预报、精细化区域预报以及环境研究。
StormScope EU 是最新加入 Earth-2 的模型,它是 StormScope 的区域版本,专门用于短期天气预报,基于欧洲天气与气候数据训练而成。该模型利用欧洲气象卫星开发组织 (EUMETSAT) 的卫星观测数据,以 10 分钟为间隔,对 16 个 Meteosat 卫星通道上的云层演变进行预测。
在 GTC 柏林上,NVIDIA 携手 Earthmover 展示了一款交互式天气演示,现场展示了 StormScope EU 的实时运行流程。该演示借助 Earth2Studio 运行预报,并利用 Earthmover 的数据平台进行管理和提供实时结果,这些结果会随着每 10 分钟传入的新卫星观测数据而更新。Earthmover 将这些结果以地图瓦片的形式呈现,让访问者无需下载完整数据集,即可浏览覆盖欧洲各地的预测结果。
开发者可以根据区域需求,将 Earth-2 模型组合到定制化的工作流中,利用 StormScope 进行短期预报,并借助 CorrDiff 为较粗分辨率的气候数据补充本地细节。开发者还可以采用这些模型架构,通过训练将其应用于空气质量建模等新的环境应用。开源的 NVIDIA PhysicsNeMo 框架提供了训练与定制工具,帮助团队能够结合自有数据和领域专业知识,构建满足区域需求的应用。
基于 Earth-2 能力进行构建的机构包括:
安盛集团正在使用 NVIDIA Earth-2 的 FourCastNet 3 模型,在超过 1,000 个模拟季节中研究历史数据记录之外的区域性气旋风险,从而生成可用于风险评估的洞察,并帮助客户有针对性地采取预防措施。
Vaisala Xweather 正将 Earth-2 与其自有的观测数据、闪电数据及预报专业能力相结合,旨在增强其面向政府机构、能源、海事、交通和保险行业客户的气象智能平台。相关工作包括将 StormScope 与闪电数据相结合,以提升短期预报的预警提前量,并通过 Vaisala Xweather 的 SaaS 产品及 AI 助手集成,向用户提供这些预警信息。
曼彻斯特大学的研究人员对 Earth-2 CorrDiff 模型进行了适配,用于英国空气质量建模。他们在由 NVIDIA 技术驱动的 Isambard-AI 超级计算机上训练模型,并在本地 NVIDIA DGX Spark 系统上运行,将环境建模从国家级超算延伸至桌面端。
道达尔能源正在探索将 NVIDIA Earth-2 用于太阳能预报,在两个光伏电站评估基于 StormScope 的太阳辐射短临预报,并开发能以亚小时级间隔提供气象信息的模型。这项工作旨在探索更精细的预报如何帮助提前预判太阳能发电量的变化。
Space42 基于 CorrDiff 和 NVIDIA PhysicsNeMo 开发了 SARDiff4Height。该研究能够从单张雷达影像估算地表高度,并生成不确定性图,帮助分析人员了解哪些区域的估算结果需要进一步核查。
探索 NVIDIA Earth-2 开放模型与工具,并通过 Earth2Studio 的预测示例展开实践。阅读安盛集团的飓风风险案例研究和曼彻斯特大学的空气质量应用故事,了解各团队如何将气象 AI 应用于各类专业挑战中。
]]>智能体的实用价值取决于其掌握的知识,而其可信度则取决于其运行所遵循的边界。
领先企业正使用开源 NVIDIA Agent Toolkit (现已扩展了多项新工具) 对智能体进行定制与管控,利用企业数据为其回答和行动提供依据,同时监测智能体的行为并规范其运行方式。
NVIDIA Agent Toolkit 包括:
- 全新 NVIDIA Agent Knowledge Foundation,集成 NVIDIA CUDA-X 库
- NVIDIA 开放模型,包括 Nemotron Retriever 和全新的 Kumo 系列
- NVIDIA OpenShell 安全智能体运行时
- NVIDIA NemoClaw 安全智能体蓝图
- NeMo Relay 和 NeMo Compass 等工具与技能
为了开发能够完成实际工作,并在从开发到部署的全流程中始终值得信赖的智能体,开发者需要一套将模型、Harness、运行时、数据和工具整合在一起的开放式智能体技术栈。
NVIDIA Agent Knowledge Foundation 助力企业将数据转化为可供智能体使用的企业级智能。智能体能够查找相关信息、理解其对业务的意义,并据此进行预测以辅助人们确定后续行动。企业无需迁移数据、重构现有工作流或调整治理管控措施,即可使用 Agent Knowledge Foundation。
该基础架构集成了包括 cuDF、cuGraph、cuML、cuOpt 和 cuVS 在内的 NVIDIA CUDA-X 库,以及全新的 Auto-Ontology 库。后者可将原始企业数据转化为客户、产品和订单等常见的业务概念,并构建它们之间的关系映射。
此外,该工具包还包括 NVIDIA Nemotron Retriever 和 Kumo Structured 开放模型 —— Kumo Tabular、Kumo Relational、Kumo Time Series 和 Kumo Forecast。这些模型可帮助智能体查找相关企业信息,从而回答问题并进行预测。
OpenShell 提供安全运行时边界,使企业能够管控智能体访问权限及可执行的操作。NVIDIA NemoClaw 蓝图为构建安全的专用智能体提供参考设计。最新的用于智能体优化的 NemoClaw 蓝图为提升智能体的智能水平提供了一个循序渐进的起点,随着时间的推移,使其工作能力不断增强。
NVIDIA Agent Knowledge Foundation 的企业应用
全新的 NVIDIA Agent Knowledge Foundation 已在众多企业中投入应用。
NVIDIA 的供应链组织正与 Palantir 一起通过 Palantir Foundry、Ontology 和 AIP 使用 Agent Knowledge Foundation 部署专用智能体,从专有数据中创建可执行洞察、预测结果并优化决策。
Databricks 将 NVIDIA Kumo Anomaly 与 Databricks Genie Ontology 相结合,为具备上下文感知能力的智能体提供支持。
Snowflake 支持客户在其 Snowflake Notebook 环境中使用 NVIDIA Kumo Engine 和 Kumo Relational 开放模型,从而释放更强大的预测能力。
NVIDIA Nemotron Retriever 模型能够提升搜索速度和准确性。借助嵌入模型,Amazon OpenSearch Service 以更少的搜索步骤提升了搜索相关性,且几乎未增加延迟。SAP 经微调的重排器运行速度提升近 3 倍。ServiceNow 在提升重新排序质量的同时,将延迟降低了近四分之一。Zoom 正在使用 Nemotron Retriever 模型,增强 Zoom AI Services 的文档理解、搜索相关性和上下文检索能力。
亚马逊云科技 (AWS)、ClickHouse、Cloudera、Cohesity、达索系统、戴尔、Elastic、Exa、IBM、NetApp、Oracle、Perplexity、Starburst 和 VAST Data 等企业也在基于 Agent Knowledge Foundation 开展构建工作。
]]>新闻摘要:
- NVIDIA 与华盛顿大学医学院蛋白质设计研究所联合推出 RFD4-Proteina 开放模型。该模型将可编程蛋白质设计与搜索能力相结合,为生物学领域开辟了新的前沿。
- 西门子医疗正利用 NVIDIA 智能技术推进新一代自适应放射治疗,通过智能体协同规划、患者个体化模拟和机器人控制,提升挽救生命的癌症诊疗资源的覆盖面。
- Automata、Benchling、Biolevate、Boltz、Danaher、Hologen 和 Therna Biosciences 等公司正利用 NVIDIA BioNeMo 开放平台开发能够连接药物设计、自主实验室和生物学发现的科学智能体,从而帮助研究人员更快地从假设迈向实验。
NVIDIA GTC 柏林 —— 2026 年 10 月 21 日 —— NVIDIA 今日宣布,将与全球领先的医疗健康和研究机构开展合作以推进蛋白质设计 —— 其中包括发布全新的开放模型 RFD4-Proteina —— 从而加速药物研发,并为癌症诊疗带来更高的精准度。
生命科学研究人员必须在庞大的生物学设计空间中进行探索,并致力于缩短计算设计与实验室测试之间的周期,以发现新药。而癌症诊疗团队则面临着另一项挑战:需要将复杂的影像和治疗数据转化为针对每位患者的精准治疗方案。
NVIDIA 的开放模型、加速计算和物理智能可以帮助专家更快地评估更多可能性,从设计新蛋白质到规划自适应放射治疗等多个环节。
NVIDIA 医疗健康副总裁 Kimberly Powell 表示:“智能体 AI 和物理 AI 正在医学领域开辟新的可能性,涵盖从蛋白质设计、赋能自主实验室到改善个性化癌症诊疗等多个方面。我们正与医疗健康和生命科学领军企业一起,加速科学发现,并在全球范围内推动更精准、更普惠的医疗服务。”
NVIDIA 与华盛顿大学蛋白质设计研究所合作推出 RFD4-Proteina
蛋白质是执行许多生命基本任务的分子工具,设计新型蛋白质可以为新药研发、诊断和工业应用开辟新路径。但要找到一种能够实现特定设计功能的蛋白质,需要在极其庞大的可能设计范围内进行搜索。
NVIDIA 与华盛顿大学医学院蛋白质设计研究所合作推出了 RFD4-Proteina。这是一款全新的 NVIDIA BioNeMo 开放模型,将可编程蛋白质设计与搜索能力相结合。
该模型能够生成靶向蛋白质设计,使科学家和智能体能够利用分子输入、约束条件和评分目标来搜索和优化设计。其潜在应用包括设计用于阻断疾病进程的蛋白质,或在诊断检测中检测疾病迹象的蛋白质。
研究草案中报告的测试结果显示,在蛋白结合、小分子结合、酶支架和 DNA 结合四个基准测试套件中,RFD4-Proteina 的计算设计成功率和生成吞吐量均高于被评估的基线模型。该模型可帮助研究人员探索并优先筛选出用于实验室测试的候选方案,并通过实验来验证设计方案在测试条件下的实际表现。
2024 年诺贝尔化学奖得主、华盛顿大学蛋白质设计研究所所长 David Baker 表示:“我们正在从发现自然界已有蛋白质的时代,迈向能够设计全新蛋白质的时代。RFD4-Proteina 拓展了科学家的创造边界,从有望推动药物研发的蛋白质,到能够分解农药的酶。将该模型开放,将使全球研究人员能够在此基础上进一步开发,探索那些曾经难以企及的解决方案。”
RFD4-Proteina 现已通过 Amazon Bio Discovery、Anthropic 的 Claude Science、Benchling、Databricks、Google Cloud、Hugging Face、Nebius、OpenAI 和 Tamarind Bio 等合作伙伴提供,使研究人员和开发者能够将这款开放蛋白质设计模型集成到智能体、云计算和科学计算工作流中。
西门子医疗与 NVIDIA 共同推进癌症诊疗
西门子医疗正与 NVIDIA 合作,利用智能体和机器人智能开发新一代自适应放射治疗技术,将影像学和肿瘤学专业知识与加速计算及模拟技术相结合,以简化工作流程并扩大诊疗服务的覆盖面。
预计到 2050 年,全球每年确诊癌症的患者人数将达到约 3500 万人。诊疗团队面临着日益增长的压力,需要在专科医疗资源有限的背景下提供精准、个性化的治疗。提高效率有助于扩大医疗服务的覆盖面,同时保持将处方剂量精准投照至肿瘤,并保护周围健康组织。
西门子医疗正与 NVIDIA 合作,通过智能体协同规划、患者个体化模拟和实时计算进一步推进自适应放射治疗。目前正探索利用 NVIDIA Nemotron 开放基础模型来驱动智能体协同规划,旨在帮助肿瘤科医生评估和优化个性化治疗方案。这些模型随后可与基于 NVIDIA CUDA® 加速的剂量计算相结合,以实现快速的患者个体化模拟,并利用 NVIDIA Holoscan 平台将实时传感器数据与 AI 及模拟相连接,以支持自适应治疗。
西门子医疗旗下瓦里安癌症诊疗业务负责人康恺德表示:“自适应放射治疗建立在一个核心原则之上 —— 治疗应当适应患者,而不是让患者去适应治疗。我们在精准度和自适应能力方面取得了重要进展,最近推出的 Accela 系统便是最新成果。我们与 NVIDIA 的合作正是建立在此基础之上进一步深化,探索 AI 和实时计算如何为临床医生提供更快的速度和更深的洞察,从而做出明智的决策,更有信心地调整治疗方案,并为更多患者提供个性化护理。”
科学智能体加速药物研发
生命科学是全球最重要的科学前沿之一,全球科学研发支出已达到 3.8 万亿美元,年度制药预算接近 3000 亿美元。
科学智能体和自主实验室可以通过将设计、实验和学习连接成一个持续循环,帮助将更多投资转化为证据、洞察,并最终催生新的疗法。
为了加速发现进程并将科学家从重复性工作中解放出来,让他们投入到更有价值的工作,各科研机构与实验室技术企业正使用 NVIDIA BioNeMo (一个支持 AI 驱动生物学和药物研发的开放开发平台),并结合 Nemotron 及其他 NVIDIA 技术开发科学智能体,以及连接药物设计、科学数据和实验室工作流的专用模型与工具:
- Benchling 正在将智能体建立在实验数据、研究背景和互联的科学工作流之中。
- Biolevate 正在药物研发全流程中,打通生物数据、专业科研工具与智能体推理能力。
- Boltz 正在开发可供科学智能体使用的专用模型与工具,用于预测分子结构、设计并评估候选分子。该公司还首次展示了一款科学智能体,能够规划工作流、调用合适的模型并解读结果,从而指导下一轮实验。
- Automata 正在将科学智能体与自动化实验室基础设施相连接,使智能体能够自主发起实验,并通过工作流捕获结构化、带有上下文信息的实验结果。
- Genedata 的 AI 联合科学家将在 Danaher 自主实验室的蛋白质设计工厂中,协调蛋白质设计与测试工作。该工作流将引入 RFD4-Proteina,帮助科学家利用实验结果指导下一轮设计。
- Hologen 正在将其大型医学模型与 NVIDIA Nemotron 相结合,打造 AI 临床科学家,帮助研究人员将影像和临床数据转化为关于患者预后的洞察,从而为临床试验设计提供依据。
- Therna Biosciences 正在利用大语言模型的推理能力连接实验证据与 RNA 药物设计,帮助科学家将生物学洞察转化为治疗候选疗法。
NVIDIA 开放模型简化医院运营,扩大专科诊疗覆盖面
欧洲各地的医疗系统正致力于扩大专科诊疗的覆盖面,同时减轻本就超负荷运转的护理团队的行政负担。
Avelios、Corti、Dedalus、Dawn Health 和 Sword 也在依托 NVIDIA Nemotron 进行开发,应用范围涵盖 AI 病历记录助手、AI 辅助临床护理到个性化患者支持服务。
PolyAI 正在基于 NVIDIA Agent Toolkit 加速患者就医流程。通过与医疗软件提供商 Corilus 部署多语言对话系统,该合作覆盖了比利时和法国超过 70,000 名医疗专业人员。
Apian 和 VitVio 正将这一能力延伸至现实世界,利用 NVIDIA Cosmos 世界模型和 NVIDIA Omniverse 库构建数字孪生,以监测并改善医院运营。
观看 NVIDIA CEO 黄仁勋 GTC 柏林主题演讲,了解更多精彩会议。
关于 NVIDIA
NVIDIA (NASDAQ: NVDA) 是 AI 和加速计算领域的全球领导者。
该新闻稿所含若干陈述包括 (但不限于) 有关以下各项的陈述:关于 NVIDIA 产品、服务和技术的增长、表现、可用性及效益的预期,以及相关趋势和驱动因素;关于 NVIDIA 与第三方 (包括其合作方和合作伙伴) 安排的预期;关于技术发展以及相关趋势和驱动因素的预期;预计的市场增长和趋势;关于 AI 及相关行业的预期;以及其他非历史事实的陈述,均属前瞻性陈述,这些都是符合 1933 年《证券法》第 27A 条 (经修订) 和 1934 年《证券交易法》第 21E 条 (经修订) 所定义的前瞻性声明。前瞻性声明受到这些法律条款创建的“安全港”保护,其依据为管理层的信念与假设以及当前可获得的信息,但同时也受到多种风险与不确定因素的影响,这些因素可能导致实际结果与预期产生重大差异。可能导致实际结果产生重大差异的重要因素包括:全球经济及政治状况;NVIDIA 依靠第三方来制造、组装、包装和测试 NVIDIA 的产品;技术发展和竞争的影响;新产品和技术的开发或者现有产品和技术的升级;NVIDIA 产品或合作伙伴产品的市场认可度;设计、制造或软件缺陷;消费者偏好或需求的变化;行业标准和接口变化;NVIDIA 产品或技术在集成到系统中时发生的意外性能损失;NVIDIA 实现业务投资或收购潜在收益的能力;以及适用法律法规的变化;NVIDIA 向美国证券交易委员会 (SEC) 提交最新报告中不时详述的其他因素,这些报告包括 (但不限于) 采用 10-K 表的年度报告和采用 10-Q 表的季度报告。向 SEC 提交的报告的副本均在 NVIDIA 的官方网站上发布,并可免费下载。以上前瞻性陈述并非未来表现的保证,仅以本协议日期为准;除法律要求外,NVIDIA 不承担更新以上前瞻性陈述以反映未来事件或情况的任何义务。
本新闻稿所述的许多产品和功能目前仍处于不同阶段,并将在具备条件且可用时推出。上述声明并不构成,也不应被解释为任何承诺、保证或法律义务。文中提及的任何产品功能或特性的开发、发布及时间安排均可能发生变化,并完全由 NVIDIA 自主决定。对于本文所述任何产品、功能或特性的未能交付或延迟交付,NVIDIA 不承担任何责任。
© 2026 NVIDIA Corporation 保留一切权利。NVIDIA、NVIDIA 商标以及其他 NVIDIA 产品和服务名称均为 NVIDIA Corporation 在美国及其他国家和地区的商标和 / 或注册商标。其他公司、产品和服务名称可能是与其相关的各家公司的商标。
]]>新闻摘要:
- 思灵机器人推出 Agile ONE SN,这是一款基于 NVIDIA Isaac GR00T 和 NVIDIA Jetson Thor 构建的人形机器人参考平台,并计划集成 NVIDIA Halos 安全栈,为开发者和研究人员提供用于前沿人形机器人开发与验证的完整平台。
- NVIDIA Isaac 平台新增了 Isaac OS 运行时、用于机器人学习的 Isaac Lab 3.0,以及开源参考工作流。该工作流在 NVIDIA DGX Station 上将 ChatGPT Astra 与 NVIDIA Isaac 和 Cosmos 结合,以加速机器人数据的生成、训练与评估。
- 包括 ABB Robotics、Flexion、Hexagon Robotics、Humanoid、KUKA、NEURA Robotics、Sereact 和 Universal Robots 等行业领军企业在内的欧洲机器人生态系统,正基于 NVIDIA 开放机器人平台,推动自主机器人系统的发展。
NVIDIA GTC 柏林 —— 2026 年 10 月 21 日 —— NVIDIA 今日宣布对 NVIDIA Isaac 开放机器人开发平台进行重大扩展,新增了一款人形机器人参考平台、数据集和运行时,并更新了机器人学习框架。
这些技术共同为开发者提供了一条从数据到部署的集成路径,加速通用机器人走向现实世界。
NVIDIA 创始人兼首席执行官黄仁勋表示:“通用机器人正以惊人的速度发展,机器人的‘ChatGPT 时刻’即将到来。借助 NVIDIA Isaac —— 我们的全栈开放机器人平台,我们正在为开发者提供模型、数据、仿真工具和计算系统,以将物理 AI 引入全球各大行业。”
Agile ONE SN —— 面向研究的前沿人形机器人参考平台
思灵机器人发布了 Agile ONE SN,这是一款预装了 NVIDIA Isaac GR00T,并由 NVIDIA Jetson Thor 边缘 AI 平台提供动力的全栈人形机器人参考平台。
机器人研究人员和开发者在整合各自独立的仿真、训练和部署工具时往往面临困难,而这些工具对于将机器人技能从开发阶段推向物理世界至关重要。Agile ONE SN 将上述工具和工作流统一在一个平台上,将搭建时间从数周缩短至数天。
Agile ONE SN 具备以下特性:
- Agile ONE S 人形机器人本体,身高 1.40 米 (4.59 英尺),重 40 公斤 (88 磅),拥有 31 个自由度,单臂负载能力达 3 公斤。
- 配备两只 WUJI Hand 2 五指灵巧手,每只手拥有 20 个自由度、1kHz 力控和触觉传感,能够实现精细操作。
- 搭载 NVIDIA Jetson Thor 本体计算平台,提供 2,070 FP4 TFLOPS 的算力和 128GB 统一内存,支持本体推理和实时控制。
- 具备多模态感知能力,包括头部和腕部摄像头、激光雷达传感器和惯性测量单元,帮助机器人感知并与周围环境交互。
- 采用 NVIDIA Isaac GR00T 平台,该平台包含 GR00T 基础模型、从数据采集到部署的完整工作流,以及用于协调运动的全身控制功能。
- 具备安全能力,计划将机器端安全协议与 NVIDIA Halos 机器人全栈安全系统进行集成。
思灵机器人创始人兼首席执行官陈兆芃表示:“人形机器人的突破在于实现大规模实用化:即一台适应性强的机器,能够学习多种技能,并能在为人类打造的环境中跨场景工作。今日思灵机器人推出的 Agile ONE SN,是一款基于 NVIDIA Isaac GR00T 构建、由 Jetson Thor 提供动力的全栈开放式参考人形机器人,为开发者提供了一个现成的系统,可用于创建、训练和验证让人形机器人投入实际工作所需的能力。”
Agile ONE SN 计划于 2027 年初上市,旨在推动前沿人形机器人的研发,目前已获得斯坦福大学和苏黎世联邦理工学院等领先机构的关注。
全新 NVIDIA 技术加速机器人学习 —— 从数据到部署
全新的 NVIDIA 技术可帮助开发者生成训练数据、扩展机器人学习、构建仿真环境并部署机器人应用,从而缩短解决方案的落地时间。
- SimReady Central Library 提供超过 2,000 个可用于仿真的机器人和工厂资产;同时,Human 1M 数据集包含多样化的人类活动、同步的三视角视频和 3D 手部追踪数据。这些均可在 Hugging Face 上获取,Cosmos Coalition 合作伙伴可访问完整的 Human 1M 数据集。
- NVIDIA Isaac Lab 3.0 现已全面可用。这是一个开源的、支持智能体的学习框架,利用多 GPU 工作流以及包括 Newton 和 NVIDIA PhysX® 在内的物理引擎,支持从桌面端到数据中心训练并优化机器人策略。
- NVIDIA Isaac OS 是一款基于 NVIDIA Holoscan 构建的开源运行时框架,它将 AI、传感器、控制系统与机器人硬件无缝连接,从而实现从仿真环境到实体机器人的确定性实时性能。
- NVIDIA 发布了针对 NVIDIA DGX Station 的三个开源参考工作流,旨在帮助开发者使用强化学习微调 GR00T 1.7 模型,在 NVIDIA Isaac Lab 中训练灵巧操作技能,并利用 ChatGPT Astra 对 NVIDIA Cosmos 世界模型进行后训练以生成合成数据。
- NVIDIA Halos 提供了一个基于 NVIDIA IGX Thor 构建的全栈安全平台,旨在帮助智能汽车和机器人从开发阶段迈向更安全的规模化现实世界部署。
Hugging Face 上的 SimReady Central Library 包含了来自 Comau、FANUC、ForgeCAD、Franka Robotics、LG Electronics、Palatial、Robotiq、Standard Bots、Universal Robots 和 Vertiv 的仿真就绪资产。
在 DGX Station 上运行的 NVIDIA 开源机器人学习参考工作流将获得 1X、思灵机器人、Humanoid、Maven Robotics、Mentee、MicroAGI、Rhoda、Sereact 和 Skild AI 等公司解决方案的支持。
包括思灵机器人、Agility、Dexory、FORT Robotics 和 KION 在内的机器人合作伙伴正在将 NVIDIA Halos 集成至其安全架构中,以保障仓储机器人的安全。此外,SICK 正在评估 Halos 以推进工业机器人的动态安全,帮助机器人对固定区域之外的变化条件做出响应。
Advantech 和 NexCOBOT 正在开发基于 NVIDIA IGX 的工业计算平台;Reynolds & Moore、埃森哲和 TÜV SÜD 正在加速工业物理 AI 安全部署的认证流程。
欧洲机器人领军企业基于 NVIDIA 开放技术进行构建
ABB Robotics 正将 NVIDIA Omniverse 库集成到 RobotStudio HyperReality 中,以便在广泛的行业中,在安装前对机器人系统进行仿真与虚拟调试。KUKA Group 正将 Omniverse 库应用于其 Visual Components FactoryLens 中,为工厂仿真工作流添加实时渲染功能。Sereact 则结合 Isaac GR00T 与 Cosmos Transfer,对其运行在 Universal Robots 工业机械臂上的 Cortex 平台进行货物搬运任务的训练与后训练。
Humanoid 使用 Jetson Thor、Holoscan Sensor Bridge、Halos 和 NVIDIA Isaac OS,在工业试点前开发和验证机器人行为;Hexagon Robotics 正在构建 AEON 感知能力,包括遥操作视频、定位、建图和物体位姿检测;Bear Robotics 正在加速 KR1 的感知和模型执行,同时通过 Kino-2 对 Isaac GR00T 进行后训练,以应用于仓储、退货处理和工业工作流。
Toyota Material Handling Europe 和 SoftServe 使用 Omniverse 和 NVIDIA Isaac Sim 框架开发自主物料搬运解决方案,可将部署时间最高缩短 50%。Idealworks 正利用 NVIDIA 开放模型和 Jetson 为工厂中的自主移动机器人开发记忆能力。Analog Devices Inc. (ADI)正使用 NVIDIA Jetson AGX Orin 和 cuVSLAM 库构建自主移动机器人。
Hugging Face 和 Pollen Robotics 使用 NVIDIA Isaac Lab、Isaac Sim 和 Newton 打造 Microduck,这是一款小型开源机器人,旨在帮助开发者和学生训练、修改和分享新的物理行为。Franka Robotics 使用 NVIDIA NIM 和 Isaac Sim,将其 Franka FR3 Duo 机器人系统的自然语言请求转化为动作。Bellboy 基于 Jetson 和 GR00T 来为其首个机器人队友 Billie 提供动力,该机器人基于 Bellboy 的物理 AI 基础设施构建,目前已部署在万豪、希尔顿、洲际和 OYO 运营的酒店中。
Flexion 使用 Isaac Lab 和 Newton 扩展其统一机器人智能模型 Reflect 的学习能力,该模型结合了推理与全身运动,以实现跨机器人本体的复杂操作。Schaeffler 将其执行器技术作为 Newton 的独家基础组件,助力通过 NVIDIA Isaac Lab 和 Isaac Sim 加速人形机器人的开发。
NEURA Robotics 使用 Isaac Sim 和 Isaac Lab 为其多模态基础模型 Neuron AI 生成合成训练数据并在仿真环境中训练机器人技能。
观看 NVIDIA CEO 黄仁勋 GTC 柏林主题演讲,了解更多精彩会议。
关于 NVIDIA
NVIDIA (NASDAQ: NVDA) 是 AI 和加速计算领域的全球领导者。
该新闻稿所含若干陈述包括 (但不限于) 有关以下各项的陈述:对 NVIDIA 产品、服务和技术的增长、性能、可用性及收益的预期及相关趋势和驱动因素,对 NVIDIA 第三方合作安排 (包括与合作伙伴及协作者的关系) 的预期,对技术发展及相关趋势和驱动因素的预期,对通用机器人技术发展以及物理 AI 在各行业采用与部署的预期,预测的市场增长与趋势,对 AI 及相关行业的预期,以及其他非历史事实的陈述均属前瞻性陈述,这些都是符合 1933 年《证券法》第 27A 条 (经修订) 和 1934 年《证券交易法》第 21E 条 (经修订) 所定义的前瞻性声明。前瞻性声明受到这些法律条款创建的“安全港”保护,其依据为管理层的信念与假设以及当前可获得的信息,但同时也受到多种风险与不确定因素的影响,这些因素可能导致实际结果与预期产生重大差异。可能导致实际结果产生重大差异的重要因素包括:全球经济及政治状况;NVIDIA 依靠第三方来制造、组装、包装和测试 NVIDIA 的产品;技术发展和竞争的影响;新产品和技术的开发或者现有产品和技术的升级;NVIDIA 产品或合作伙伴产品的市场认可度;设计、制造或软件缺陷;消费者偏好或需求的变化;行业标准和接口变化;NVIDIA 产品或技术在集成到系统中时发生的意外性能损失;NVIDIA 实现其商业投资或收购潜在收益的能力;以及适用法律法规的变化;NVIDIA 向美国证券交易委员会 (SEC) 提交最新报告中不时详述的其他因素,这些报告包括 (但不限于) 采用 10-K 表的年度报告和采用 10-Q 表的季度报告。向 SEC 提交的报告的副本均在 NVIDIA 的官方网站上发布,并可免费下载。以上前瞻性陈述并非未来表现的保证,仅以本协议日期为准;除法律要求外,NVIDIA 不承担更新以上前瞻性陈述以反映未来事件或情况的任何义务。
本新闻稿所述的许多产品和功能目前仍处于不同阶段,并将在具备条件且可用时推出。上述声明并不构成,也不应被解释为任何承诺、保证或法律义务。文中提及的任何产品功能或特性的开发、发布及时间安排均可能发生变化,并完全由 NVIDIA 自主决定。对于本文所述任何产品、功能或特性的未能交付或延迟交付,NVIDIA 不承担任何责任。
© 2026 NVIDIA Corporation 保留一切权利。NVIDIA、NVIDIA 商标以及其他 NVIDIA 产品和服务名称均为 NVIDIA Corporation 在美国及其他国家和地区的商标和 / 或注册商标。其他公司、产品和服务名称可能是与其相关的各家公司的商标。
]]>1980 年,Tempodrom 最初在柏林墙附近的一顶帐篷中建成,此后,它曾几次迁移,最终于 2001 年在 Anhalter Bahnhof 附近安顿下来。自那以后,这个场馆就一直承办各种活动。
今天,这里上演着一场别样的盛会。
为期三天的 GTC 柏林大会将举办 100 多场专题会议,内容涵盖代理式 AI、机器人、物理 AI、开放模型和加速计算等领域。在此,记者、分析师和合作伙伴齐聚一堂,参加此次大会的核心活动 —— NVIDIA 创始人兼首席执行官黄仁勋的主题演讲。
黄仁勋登台发表演讲
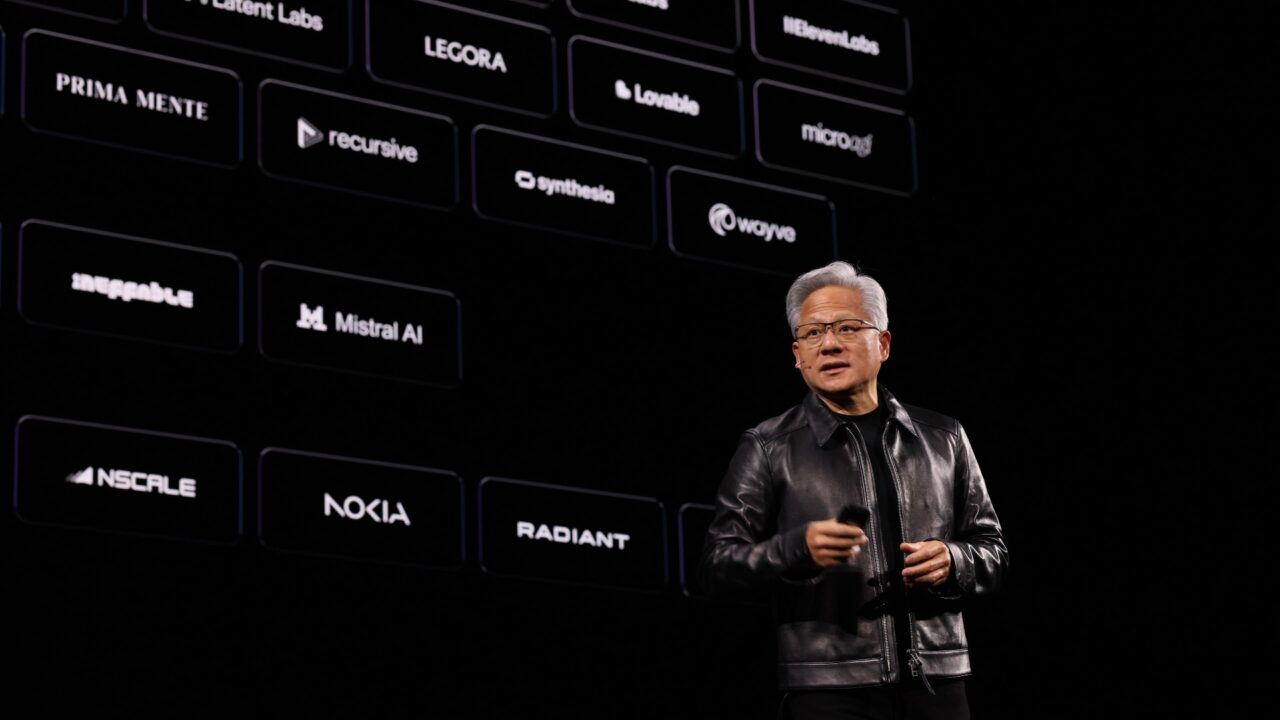
黄仁勋开场便提出了一个问题:欧莱雅 (L’Oréal)、Revolut、Spotify、默克 (Merck)、沃达丰 (Vodafone)、Zara、保时捷 (Porsche)、雀巢 (Nestlé) 和汇丰银行 (HSBC) 有什么共同之处?他说这些都是欧洲公司,而且都在 AI 领域与 NVIDIA 开展合作。
本次主题演讲正值 NVIDIA 为期一周的欧洲巡访之际。此前,NVIDIA 已先后到访了巴黎、伦敦、斯德哥尔摩和都柏林,并与超过 12,000 家合作伙伴开展合作。黄仁勋表示:“经过计算机行业数十年的发展,我们现在正处于一场新工业变革的开端。”
黄仁勋解释道,AI 是一块“五层蛋糕”。能源为 AI 工厂的先进计算机提供动力支持,这些计算机通过运行在其上的模型生成 Token 和数字智能,然后将这些模型集成到每个应用中。
他表示:“早在 AI 模型出现之前,基础设施就必须先行建设”,就像互联网首先需要网络,而电力首先需要电网。
黄仁勋说:“要想成为这个 AI 经济的一部分,不能只做 AI 的消费者,而是要成为 AI 的生产者。我们完全可以在欧洲实现这一切,事实上,我们已经开始了。”
AI 工厂迎来全新形态
黄仁勋将 NVIDIA 的全栈 AI 工厂定位为构建和运营 AI 基础设施的综合平台,涵盖硬件、系统软件、CUDA-X 库和模型。
黄仁勋表示:“这代表了创建 AI 工厂所需的全方位技术。这就是 NVIDIA 如今所构建的体系,也是我们帮助欧洲融入 AI 生态系统、参与 AI 经济的基础。”
他表示,Vera Rubin 已全面投产,它将 NVIDIA 的计算平台从模型和大语言模型扩展到处理整个 AI 智能体。他还展示了多款 NVIDIA 最新的机架级硬件产品。
随后,黄仁勋宣布推出 NVIDIA DSX POD,这是完整 NVIDIA Vera Rubin AI 工厂的参考设计,由合作伙伴在模块化集装箱内构建,在交付前集成和验证。借助 DSX POD,只要现场设施准备就绪,现场部署就可以从六个月缩短到仅 14 天。
黄仁勋表示:“这是全球供应链的全面转型。它将改变人们安装和构建数据中心的方式,并有望最终加快进程。”
这个 NVIDIA DSX AI 工厂平台能够帮助企业将冷却用水量最多降低 100%,并在实现相同 AI 产出的同时,降低功耗最高至 30%。
智能体是新的计算平台,而安全是工程问题
黄仁勋表示,智能体对工具进行思考、推理、迭代和使用,随着智能体变得越来越有用,其 Token 的使用量也随之增加。
他将智能体概括为五个组成要素:模型 (Model)、编排其工作和记忆的框架 (Harness)、分离 Harness 的沙盒 (Sandbox)、知识 (Knowledge) 和工具 (Tool)。在该框架中,智能体不仅仅是一个回答问题的模型;它可以调用知识并通过工具采取行动。
黄仁勋表示:“最重要的是确保智能体的安全。自主代理可以访问文件、资源、网络和工具,因此其权限应最小化,并应受到监测。”
NVIDIA 的解决方案是面向安全 AI 智能体的 OpenShell 参考架构。这是一种基于 NVIDIA OpenShell 构建的全栈设计,它是一个开源、策略控制的运行时环境,其内核级沙盒位于智能体及其可能影响的系统之间。
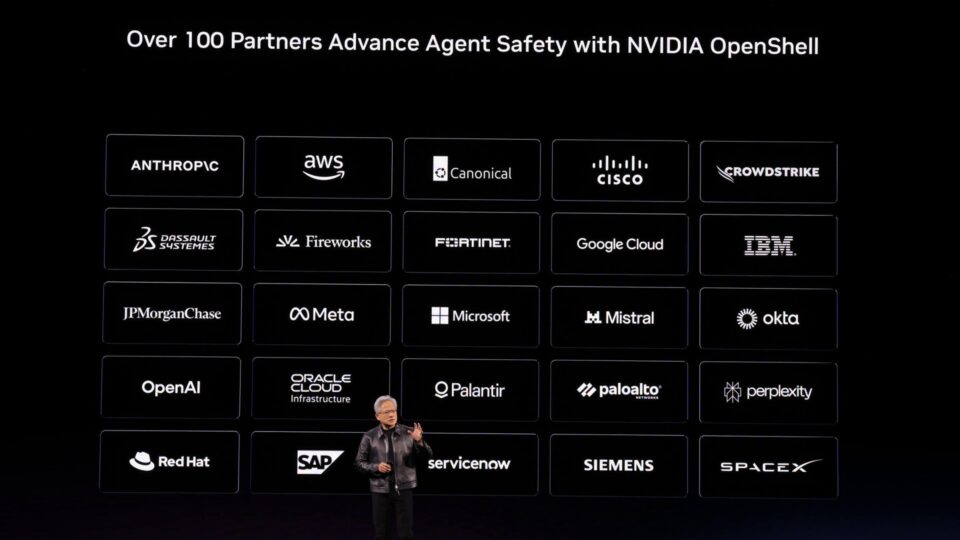
黄仁勋表示,这意味着权限、策略实施和监测必须动态调整。“每次启动智能体时,权限都会有所不同”。
开放模型将专业知识转化为优势
黄仁勋介绍了 NVIDIA 的开放模型,并将其作为构建满足特定需求的 AI 的起点。
NVIDIA 的前沿开放模型可在各行各业中使用:Nemotron 用于语言,Cosmos 用于世界基础模型,GR00T 用于人形机器人,Alpamayo 用于智能汽车,Ising 用于量子 – 经典计算,Earth-2 用于物理学 AI。
黄仁勋说:“我们处于技术前沿。因此,在所有这些不同的领域,我们为大家提供相应的模型,并且持续推进相关工作。我们已经为此努力了十年,未来也将继续努力。”
NVIDIA 提供用于复制它们的模型、数据和脚本,公司可以根据自己的数据针对特定用例对模型进行后期训练,从而将专有数据转化为他所说的“智能”。
黄仁勋表示:“您可以从一个开放模型入手,比如像性能出色的 Nemotron,使用自己的数据,针对应用场景对其进行后训练,以实现超强的能力。这是一件非常合理的事情,因为现在所有的技术都已经具备。”
NVIDIA 为智能体提供知识层
黄仁勋随后介绍了 NVIDIA Agent Knowledge Foundation。作为一组模型和库,它用于将智能体连接到企业数据,包括文档中的非结构化信息和数据库中的结构化数据。
他还重点介绍了 Nemotron 工具,这些工具能够用于解析文档、嵌入查询和重新排序相关信息,以及用于根据结构化数据进行预测的新模型 NVIDIA Kumo。
黄仁勋表示:“归根结底,将这些智能体转变为超级智能体的关键在于,你让它们能够接触到公司的知识。”
NVIDIA CUDA-X – 面向智能体的加速工具
黄仁勋随后介绍了 NVIDIA CUDA-X,将其定义为加速计算库合集,广泛应用于科学、工程、研究和创意工作等领域。
NVIDIA 的加速计算平台拥有超过 1100 万开发者。
黄仁勋表示,这些库可以加速模拟器、求解器和数据处理引擎,而智能体在执行实际任务时,正是可以调用这些工具。
黄仁勋说:“CUDA-X 工具为智能体提供了开展专业工作的工具。”
智能体进入实验室、工厂和工程开展工作
一段视频展示了 NVIDIA Agent Toolkit 如何将企业知识、模型和工具整合在一起,并呈现了三个行业示例:
在 Lila Sciences,智能体帮助设计一种潜在的 B 细胞淋巴瘤疗法,使用虚拟实验来指导自动化实验室中的工作。
在西门子的埃尔兰根工厂,智能体帮助新产品做好量产的准备,在变更方案到工厂车间之前,通过数字孪生进行测试。
在达索系统,工程智能体可以调整车辆设计,使用仿真来识别问题并完善设计。
黄仁勋在视频播放后说:“这些知识和工具都属于你。这是您的专业知识,因此如今这一切都已成为可能。”
电信运营商成为分布式 AI 基础设施
黄仁勋表示,AI 正在改变电信行业,提高频谱效率,并将通信基站转变为分布式 AI 基础设施。
他列举了 10 万个站点和约 1000 亿瓦级的分布式数据中心。黄仁勋表示经过近八年的努力,NVIDIA 与诺基亚在 T-Mobile 的网络上进行了首次商业通话。
黄仁勋说:“现在,CUDA 可以拨打电话。AI 将彻底改变我们的通信方式。这将大大提高我们的频谱效率。”
AI 进入治疗室
医疗健康和生命科学领域的领先企业正在利用 NVIDIA 技术推进药物研发并拓展患者护理服务。
NVIDIA 和西门子医疗正在开发基于 AI 的放射治疗技术。
Nemotron 智能体负责协调治疗方案的规划,Isaac for Healthcare 平台和 Omniverse 库构建设备和患者解剖结构的数字孪生,用于模拟肿瘤靶向过程。Holoscan 与 IGX Thor 连接实时成像和传感器数据,随着患者的移动实现实时自适应交付。
黄仁勋将自适应放射治疗描述为一种物理 AI 应用:在患者接受治疗过程中,身体和肿瘤也会发生变化,因此系统必须追踪这些变化,并调整放疗靶区。
黄仁勋表示:“肿瘤的形状会不断发生变化。在接受治疗期间,患者身体也会发生变化。这个自适应放射治疗机器人系统,必须感知不断变化的环境,了解肿瘤的位置,对肿瘤进行精确的分割,并据此引导放射治疗。”
未来之路:出行领先企业加入 NVIDIA 汽车生态系统
黄仁勋说 NVIDIA Hyperion 计算平台正被应用于更多车队,通过辅助驾驶软件将无人驾驶出租车连接到网约车服务。
Bolt 与 Lucid 合作,以及梅赛德斯 – 奔驰、大众汽车商用车和 Einride,展示了基于 NVIDIA Hyperion 计算平台的部分辅助驾驶应用案例,并展示其在 L3 级和 L4 级自动驾驶汽车以及未来无人驾驶出租车车队的应用潜力。
此外,沃尔沃汽车正在采用 Hyperion 和 NVIDIA Alpamayo Stack 软件,实现安全的辅助驾驶。NVIDIA 还推出多项全新 AI 和安全技术,旨在帮助开发者大规模开发、验证和部署辅助驾驶汽车。
黄仁勋宣布,大众汽车商用车、捷豹路虎、沃尔沃汽车和梅赛德斯 – 奔驰的下一代车型将与 Hyperion 兼容,并表示“欢迎使用 Hyperion”。
为机器人研究人员打造的人形机器人参考
黄仁勋接着宣布了 Agile ONE SN,这是一款基于 Isaac GR00T 构建的人形机器人参考。它拥有 31 个自由度,旨在将研究人员的搭建时间从数周缩短到数天,并预计将于明年推出。
该平台采用模块化设计:研究人员既可以使用完整的工作流程,也可以根据需要选择其中的特定组件。
黄仁勋说:“这是一个很好的起点。”
它基于 NVIDIA 的开放式物理 AI 堆栈,包括用于数据采集的 Isaac Capture、用于机器人智能的 GR00T 模型、用于基于仿真训练的 Isaac Lab、用于运行时的 Isaac OS,并结合了 NVIDIA 的开放物理 AI 数据集构建。思灵机器人、Figure、KUKA 和 NEURA Robotics 等合作伙伴目前已经在这一平台上进行开发。
个人 AI 拥有一台新机器
黄仁勋最后介绍了上周发布的 RTX Spark 笔记本电脑。将 RTX 图形技术和 NVIDIA 的全栈 AI 平台融入设计纤薄,质感高级的 Windows PC,带来加速创作、沉浸式游戏和强大的本地 AI 体验。
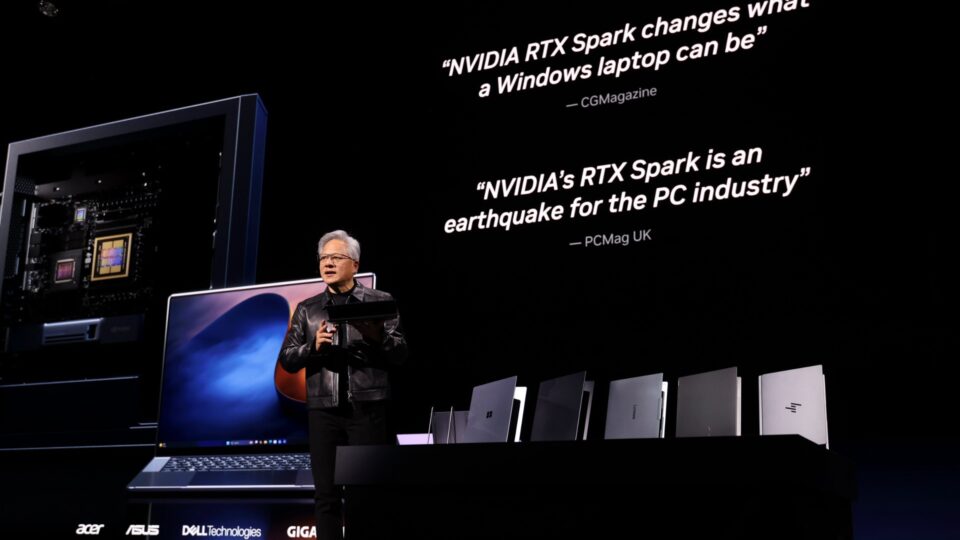
黄仁勋将该设备 1 Petaflop 的性能和 128GB 的内存与他 2016 年交付给 OpenAI 的 DGX-1 进行了比较,并展示了两个设备在体积上的差异:
“2016 年,我向当时的一家小公司 OpenAI 交付了一台具备 1 Petaflop 性能和 128GB 统一内存的设备,”黄仁勋一边说,一边在观众面前举起了这台紧凑型的机器。“这台设备同样拥有 1 Petaflop 性能和 128GB 统一内存。唯一的区别是我可以像这样拿着它,DGX-1 则需要两个人搬上来。”
随后,黄仁勋播放了一段视频,展示了一个智能体如何辅助训练 Hugging Face 的 Microduck。该智能体在 Isaac Sim 中构建训练环境并进行仿真,将训练作业发送到云端,然后将学到的策略带回 RTX Spark 进行评估,最后将其部署到实体机器人。
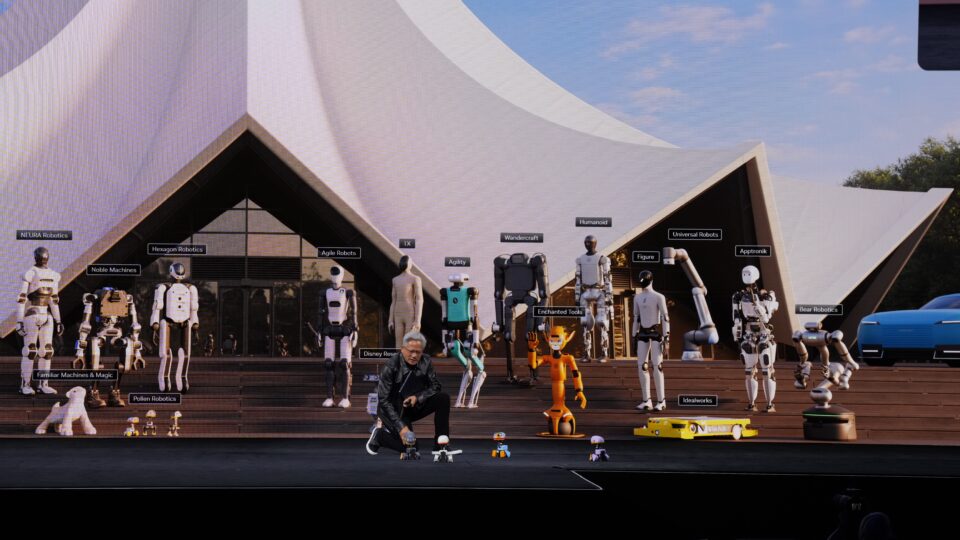
四只 Microduck 随后登上了舞台,在指令下做出坐下站立,甚至小憩的动作。他解释说,Microduck 是在 RTX Spark 上创建的,在云端完成了训练,并通过仿真学习了各种技能。
“你们是在 RTX Spark 上创造的。我们在云端利用大量 NVIDIA 超级计算机对你们进行了训练,你们也在 RTX Spark 和数字孪生中学会了这些的技能,”黄仁勋与机器人互动时说。
完整阵容
在 Microduck 的围观下,黄仁勋总结了主题演讲:欧洲正在建设其 AI 经济,AI 工厂正在不断发展以运行智能体,而物理 AI 则是下一个前沿领域。
黄仁勋说:“就是这样,每个人都可以构建智能体。这里的每家公司都将成为一家 AI 公司。这里的 AI 经济也将蓬勃发展。”
在演讲尾声,黄仁勋还带来了一个惊喜:一场“欧洲歌唱大赛”(Eurovision) 风格的音乐谢幕表演,以诙谐幽默的方式回顾了演讲中的核心主题。
歌词内容丰富,从 OpenShell 的安全防护机制 —— “无凭证,拒绝访问”以及“BlueField 上的 Sentry (哨兵) 永不休息” —— 一直唱到物理 AI;其中,机器人训练过程被形象地比作“无需学生贷款的大学”。
歌词中还有一句妙语:“‘可互换性’(fungible) 这个词里,本身就藏着‘乐趣’(fun)。”随后,一段萨克斯独奏引出了全场激昂的“We are Europa”合唱。
黄仁勋在演讲结束时说道:“让我们共建欧洲的 AI 经济,让 AI 真正发挥作用。祝大家在 GTC 上收获满满。”
欢迎访问在线媒体资料包,查看有关 NVIDIA GTC 柏林的博客文章及新闻稿。
]]>AI 原生企业的需求正以前所未有的速度推动欧洲 AI 云生态系统向前发展。开发者需要更贴近其数据的算力、可定制并支持规模化部署的开放模型,以及在设计之初即充分考虑安全性的全栈基础设施。
遍布欧洲、北欧地区、非洲和中亚的 NVIDIA 云合作伙伴正持续扩大区域计算能力,以支持模型训练和推理,助力开发者构建智能体和物理 AI 应用,并为智能体的访问权限和操作建立边界。
各方正携手将欧洲在能源、数据、科研和工业领域的专业知识转化为生产智能,支持新模型、新应用、新组织和工作岗位,同时让人们能够更好地掌控开发和部署 AI 的地点和方式。
自主:AI 云助力建设欧洲 AI 基础设施
欧洲汇聚了卓越的科研实力、工程人才、工业专业知识和数据,以及新一代模型与应用,这些优势需要由知识所在地附近进行大规模计算。区域性 AI 云为模型构建者、企业乃至整个行业的发展奠定了基础设施根基。
随着 AI 工厂规模不断扩大,电力正成为一种制约因素,因此,提升每瓦电力的智能产出至关重要。Nscale 正借助 NVIDIA DSX 平台,根据工作负载需求协调电力分配。在采用 NVIDIA Grace Blackwell Ultra 机架级扩展系统的测试中,Nscale 证明,在相同的预配置电力预算下,NVIDIA DSX MaxLPS 可支持多部署 37% 的 GPU,并将整体推理吞吐量提升近 50%。
Nscale 还计划部署 NVIDIA Vera Rubin 基础设施,用于前沿模型训练和生产工作负载,以支持领先的模型与应用开发商使用其全栈、垂直整合的平台,并拓展至五个欧洲市场。
Crusoe 正在开发 Spark,这是一款专为 NVIDIA Vera Rubin 平台设计的液冷模块化 AI 工厂,旨在将 Crusoe Cloud 算力部署到更靠近用户的位置,以实现低延迟 AI 推理。Crusoe Cloud 为 EMEA (欧洲、中东和非洲) 地区的领先模型及应用开发商提供服务,其中包括 Base44、Gradium、LTX 和 Wonderful。
Aleria、Cassava Technologies、Firebird、G42、Radiant、SWI Compute 和 Vultr 也在欧洲、北欧地区、非洲和中亚持续开发并扩展由 NVIDIA 驱动的 AI 基础设施。
AI 云提供的区域算力整合了涵盖 NVIDIA Vera Rubin、NVIDIA BlueField 和 NVIDIA Spectrum-X 以太网网络的全栈 NVIDIA DSX AI 工厂平台,使客户能够更灵活地选择和掌控工作负载与数据的存放位置,同时推动自主计算服务发展与经济增长。
开放:贯穿训练与推理的模型和库
在整个生态系统中,各大 AI 云正持续扩展由 NVIDIA 技术支持的基础设施和服务,助力开发者利用开放模型和库构建应用。这些新增算力可支持模型训练、面向特定任务的微调和大规模推理,包括部署在边缘的应用。
在生产环境推理方面,Nebius 已采用 NVIDIA Groq 3 LPX,并借助 Spectrum-X 以太网网络,将其与 Nebius Token Factory 上的 NVIDIA Vera Rubin 系统集成。该组合将通过平台托管的无服务器端点、专用端点以及用户熟悉的应用程序接口,为延迟敏感型应用和智能体系统提供更快的 Token 生成速度。
针对机器人和物理 AI 领域,Nebius 推出包括其全栈 Physical AI Workbench 的专用 AI 云解决方案。Rhoda AI、RoboForce 和 Sereact 等机器人公司正在基于该平台开发。此外,Nebius 还在其基础设施上推出了三款 NVIDIA 零售智能体蓝图的抢先体验阶段,涵盖库存、门店运营和微调。
Nebius 正借助其 Physical AI Living Lab 在欧洲各地广泛拓展云服务,同时还在德国作为 SPRIND 的 Next Frontier Challenge 计算机供应商。
Baseten 基于 CodeRabbit 所采用的 Nemotron 3.5 Lightning 开发了用于代码审查路由的专用模型。借助监督微调和强化学习,CodeRabbit 将路由一致率从 75.8% 提升至 80.7%,同时将评估工作负载的预估推理成本降低了 50%。这些成果展示了 AI 开发者如何针对专业任务定制 NVIDIA 开放模型,并同步提升准确率与推理效率。
Fireworks 与 Era4 正携手推动开放模型在英国及欧洲企业落地。此次合作将 Fireworks 的模型训练与推理平台同 Era4 Chesterfield 设施中由 NVIDIA Blackwell Ultra GPU 提供算力的直连液冷式算力相结合,助力双方推进面向金融服务、保险和生命科学领域的企业级 AI 解决方案规划。
Mistral 正在扩展其 NVIDIA 加速计算基础设施,以支持模型训练、定制和推理。此次扩展包括计划于 2027 年交付的 NVIDIA Vera Rubin 基础设施。Mistral Large 4 是该公司最新的前沿多模态模型,使用 Mistral 在欧洲运营的数据中心内的 3,800 个 NVIDIA Grace Blackwell GPU 训练而成,进一步提升了在编码、智能体工作流和多模态理解方面的能力。
Verda 计划部署 NVIDIA Vera Rubin,并将继续推动已投入生产的 NVIDIA Nemotron 和 NVIDIA Cosmos 等开放权重模型发展,并采用开源框架 NVIDIA Dynamo 优化推理。
安全:从芯片到软件,为 AI 智能体构建安全边界
随着开发者将模型接入各类工具和业务系统,他们还需要对智能体的访问权限及可执行的操作实施管控。
在 GTC 柏林上发布的 NVIDIA OpenShell 参考架构获得了 AI 云生态系统合作伙伴的支持。该架构基于 NVIDIA OpenShell 安全运行时软件构建,旨在帮助组织实现全栈掌控力,在部署 AI 智能体时明确界定其访问权限和可执行操作。
NVIDIA Vera Rubin 系统用于模型推理;搭载 OpenShell 的 NVIDIA Vera CPU 用于智能体 Harness 和工具调用;运行 NVIDIA Sentry 的 NVIDIA BlueField-4 DPU 则负责芯片内执行。三者各司其职、协同工作,共同实现这一管控机制,确保智能体能够完成既定任务,而不会超出人为设定的边界。
Aleria、Baseten、Cassava、CoreWeave、Crusoe、DigitalOcean、Firebird、Fireworks、Firmus、G42、GMI Cloud、IREN、Lambda、Lightning AI、Nebius、Nscale、Radiant、Verda 和 Vultr 等合作伙伴正为 OpenShell 参考架构提供支持,助力其客户安全部署智能体。
欧洲各地的 AI 云正在共同将区域基础设施投资与 AI 的构建和部署紧密衔接。扩展后的算力容量为开发者提供了更多运行工作负载的平台。模型与推理服务帮助他们将这些算力投入使用。智能体管控机制则解决了应用在投入生产时被允许执行哪些操作的问题。
了解 NVIDIA 云合作伙伴提供的基础设施与服务,以及用于智能体部署管控的 OpenShell 参考架构。
]]>为助力开发者快速构建能够帮助物理 AI 系统理解并模拟现实世界的世界模型,NVIDIA 进一步扩展了 Cosmos 平台,新增训练工具、仿真检查点和 Cosmos Data Factory 蓝图。
NVIDIA Cosmos 平台在六个不同的开放模型基准榜单上均跻身前五,为世界模型构建者提供前沿开放模型,以及数据、训练和优化工具与方案,助力其在部署前扩展训练数据、适配模型、测试行为,并完成性能优化。
构建更优质的训练数据
构建世界模型始于多模态、多感官数据。
NVIDIA Cosmos Data Factory 汇集了用于大规模数据标注、筛选、增强和评估物理 AI 训练数据所需的工具与技能。作为一款用于筛选视频训练数据集的 GPU 加速解决方案,Cosmos Curator 现已新增对多模态、多感官输入及处理模块的支持。
Cosmos Data Factory 现提供以下五款云原生蓝图,并可通过 GitHub、Microsoft Azure、Nebius 和 CoreWeave 获取:
- 辅助驾驶汽车数据集生成:筛选并标注驾驶数据,随后补充难以采集场景的合成样本,从而扩大训练覆盖范围。
- 图像属性增强:通过改变物体外观,提升图像搜索效果。
- 事件视频生成:将静态图像转换为罕见或危险事件的合成视频。
- 缺陷图像生成:为检测模型生成印刷电路板、金属和玻璃的缺陷图像。
- 视频数据增强:在保留场景结构的同时,改变现有视频素材中的天气与光照条件。
企业已开始将 Cosmos Data Factory 蓝图投入实际应用,以加速其物理 AI 开发工作流。
保时捷正借助 Microsoft Azure 上由 Voxel51 提供的 Cosmos Data Factory,引领大众汽车集团旗下各品牌间构建共享的辅助驾驶汽车数据飞轮。预计该方案可减少高达 90% 重复性实车测试,并将开发周期缩短高达 85%。
ANYbotics 借助 Cosmos Data Factory 蓝图生成了逾 1,500 个合成视频片段,结合真实世界数据的整理,并通过 Encord 的平台验证输出结果,以训练其工业巡检机器人识别液体泄漏及设施巡检期间的其他变化。
计算机视觉公司 Ultralytics 利用真实图像以及通过 Cosmos Data Factory 生成的定向合成缺陷数据重新训练了其 YOLO 模型,提升了缺陷定位能力和召回率。
训练、适配与优化模型
在准备好训练数据后,开发者可以训练其自有架构,或从预训练模型开始。
在 GTC 柏林上,NVIDIA 将 Cosmos Framework 的训练、优化和部署工具及配方以智能体技能的形式扩展至更多开放模型,并推出 Cosmos 3,助力世界模型构建者提供了一条从实验到部署的捷径。
开发者和智能体现可通过微调和强化学习,对 GR00T、Alpamayo、Qwen、Pi0.5 等开放模型以及其他兼容的 Hugging Face 模型进行适配,并借助蒸馏和量化优化模型,并通过高性能推理进行部署。
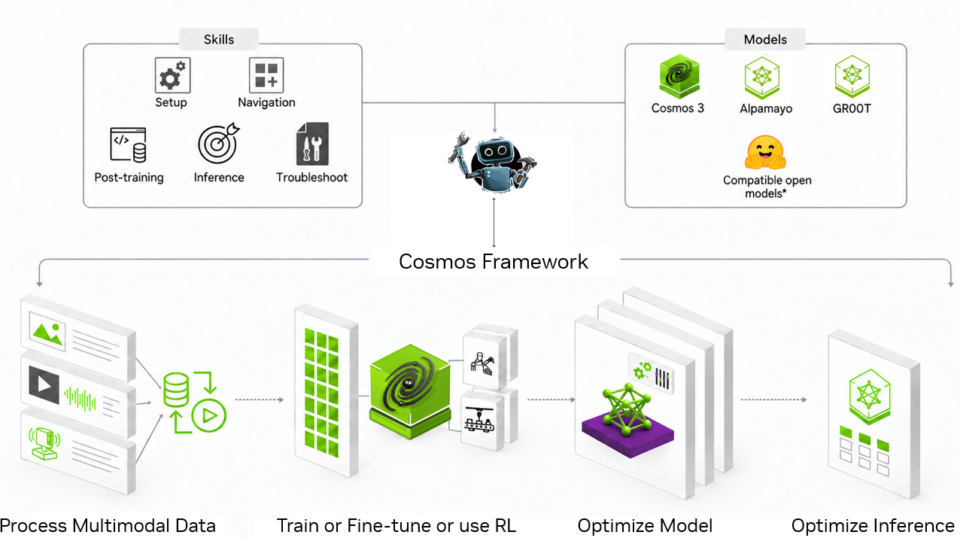
为开发专门面向第一视角操作的世界模型,机器人研究实验室 MicroAGI 使用人类操作物体的视频对 Cosmos 3 进行后训练,并将其 320 亿参数的推理器蒸馏为 80 亿参数的 Nano 模型,同时保持准确率不变。
开发者可在 Roboflow 上标注数据,并针对他们的特定环境和任务对 Cosmos 3 进行后训练,随后将这些模型部署至 Roboflow 托管环境或本地 NVIDIA GPU,从而将视频推理能力引入工厂和仓库。
加快策略测试与模型运行
在推出这些工具的同时,NVIDIA 还通过其在 Cosmos 模型研发,不断推动基础技术发展。
面向仿真的全新 Cosmos 3 Nano 模型变体,支持开发者在可重复且难以采集的多视角、多传感器场景中测试自主策略。配套代码支持开发者在开展现实环境测试前调整模型,以在交互式仿真中训练并评估其面向辅助驾驶汽车和双臂机器人的自有策略。
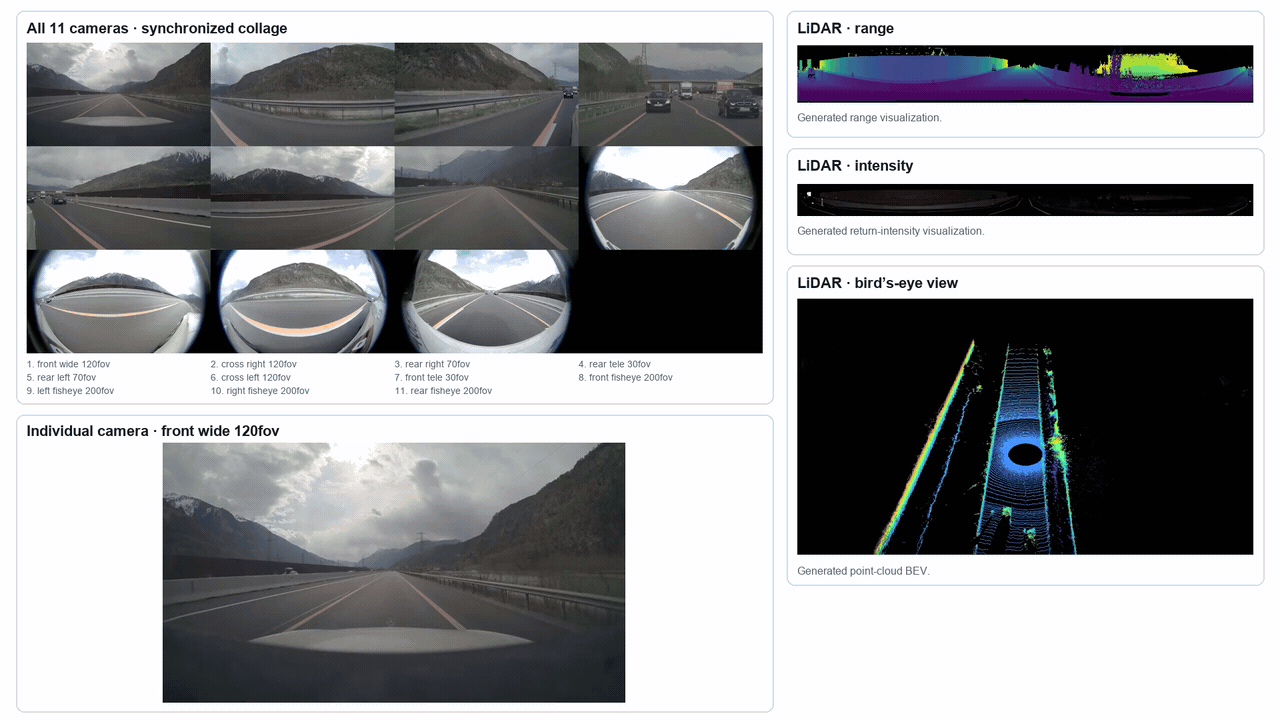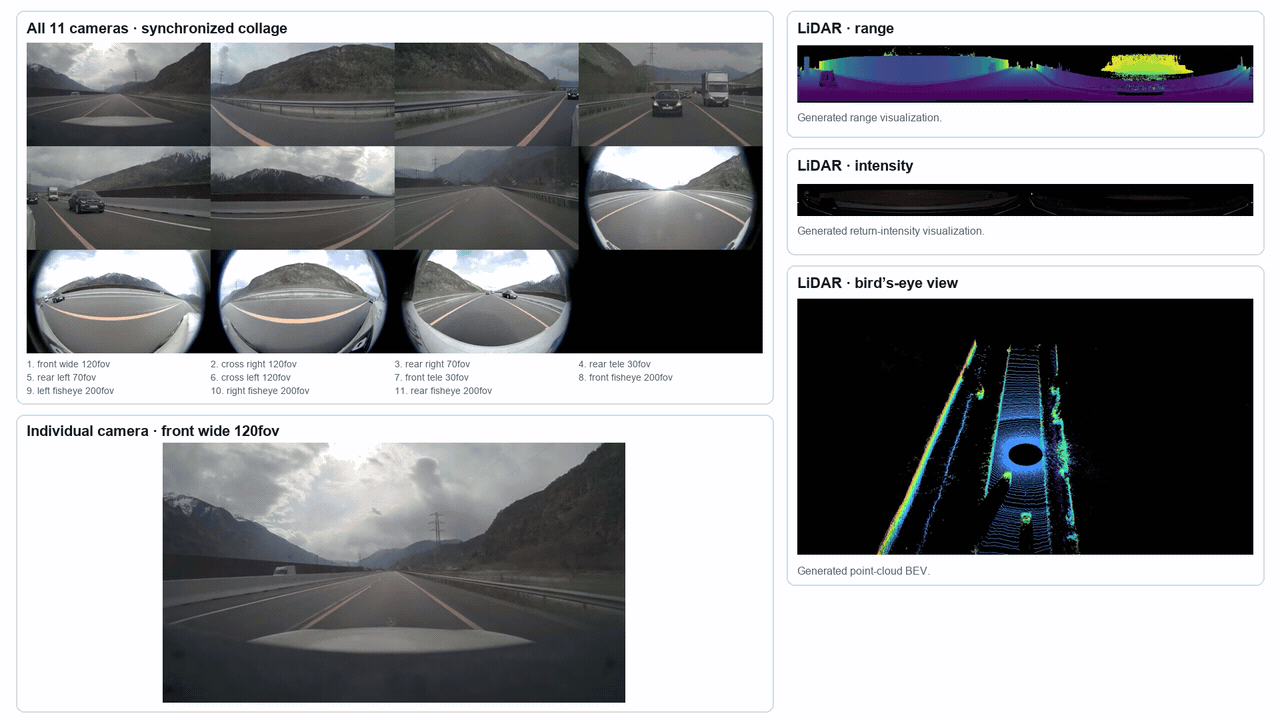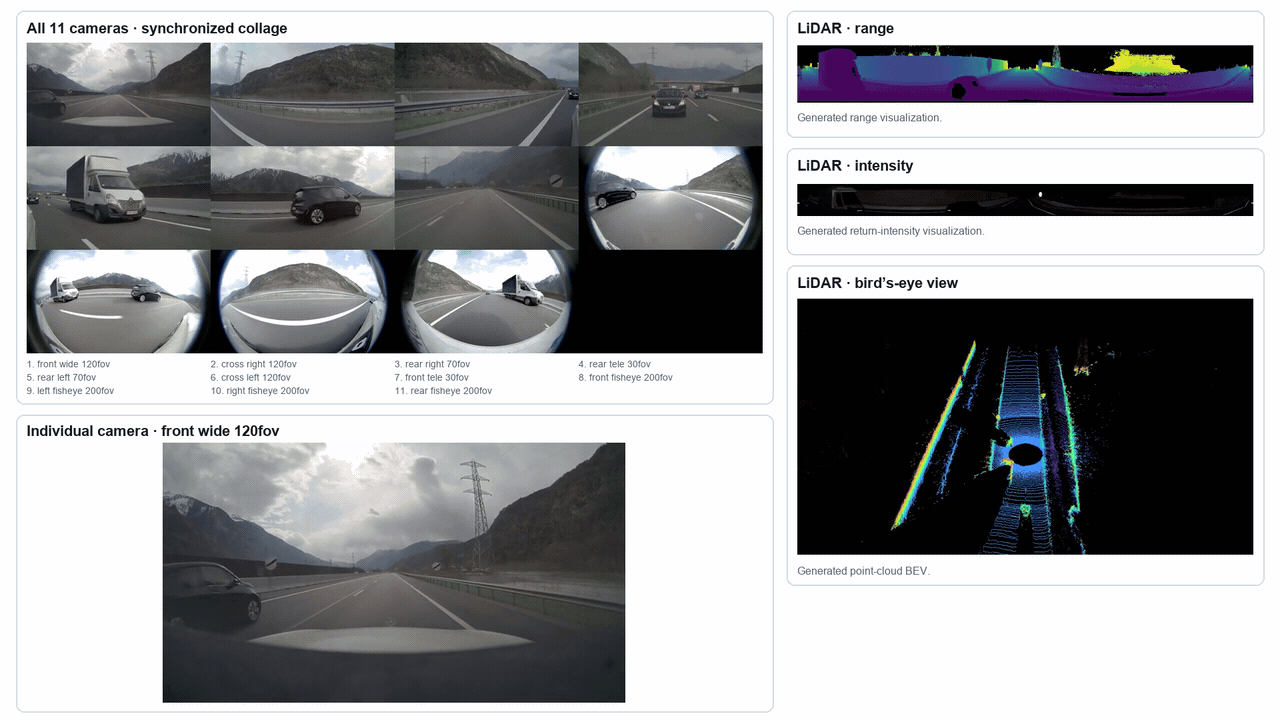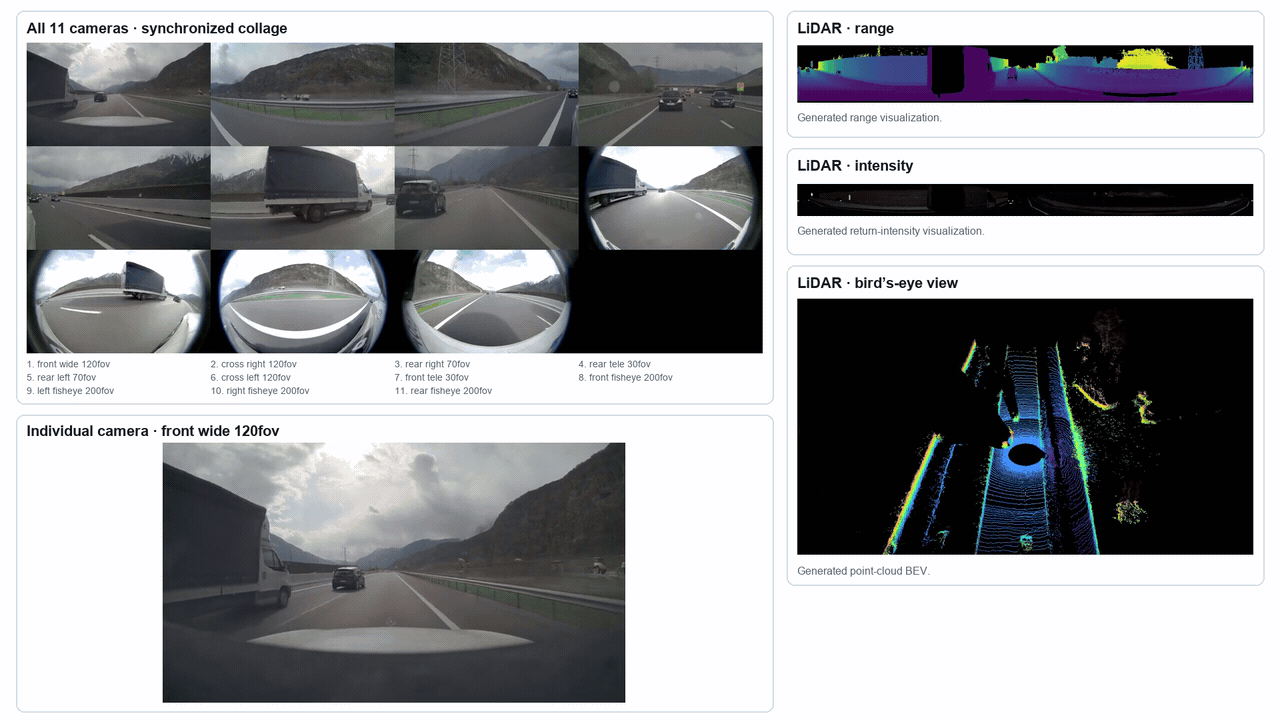
生成多视角、多感官视频数据,用于在闭环仿真中评估策略
开发者可借助更新后的 NVIDIA Cosmos 3 NIM 部署核心 Cosmos 模型。在经验证的配置中,该服务能够在不损失质量的同时将推理速度提升至高 2 倍,同时持续的视频分析可实现亚秒级警报。
对于视觉 AI 开发者,基于 Cosmos NIM 构建的全新用于视频搜索与摘要 (VSS) 3.3 的 NVIDIA Metropolis Blueprint,只需一个提示词即可构建高效的视频 AI 应用,并帮助团队在使用相同数量 GPU 的情况下,多监测 40% 的视频流。
ADNOC 采用基于 Cosmos 和 NVIDIA Metropolis VSS Blueprint 构建的 Fogsphere 的 MistIQ 智能体平台,在 65 个作业现场实时检测安全隐患。针对罕见事件,Fogsphere 还利用 Cosmos Data Factory 生成合成训练数据,无需在物理环境中人为模拟危险场景,即可提升检测能力。
Cosmos 平台是完全模块化且开放的。开发者可借助 Cosmos Data Factory 生成训练数据集,并使用 Cosmos Framework 训练和适配世界模型,随后通过 NIM 部署受支持的 Cosmos 模型。
]]>