Artykuł Co w Kafce piszczy? pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Zaczniemy sobie patrzeć na to wszystko z góry i postaramy się zagłębiać w poszczególne elementy Kafki.
Główne elementy układanki
Przyjrzymy się najpierw główny elementom, które będą występować w każdym środowisku gdzie jest Kafka.

Producenci
Producenci są to aplikacje, które tworzą wiadomości oraz je wysyłają do Kafki.
Konsumenci
Konsumerami nazywamy aplikacje, które mają za zadanie odbieranie wiadomości wcześniej wysłanych przez Producentów.
Ekosystem Kafki
Przez ekosystem Kafki powinniśmy rozumieć Klaster Kafki, na który składają się Brokerzy, oraz Zookeepera.
Opis zaczniemy od opisu Ekosystemu Kafki, żebyśmy mogli zapoznać się z głównymi pojęciami, których będziemy używać przy opisywaniu Producentów i Konsumentów.
Topic
Topic jest kluczowym pojęciem w kwestii zrozumienia jak działa Kafka. Jest on odpowiednikiem kolejki w innych brokerach wiadomości. Czyli jest to miejsce gdzie wiadomości są wysyłane, a następnie odbierane.

Najpierw zacznijmy od tego, jak wiadomości są przechowywane przez Kafkę. Kafką tworzy plik logów (dlatego czasami możemy się spotkać z uzyciem pojęcia logów w kontekście Kafki), do którego kolejne wiadomości są dopisywane na koniec tego pliku. Na powyższym obrazku możemy zobaczyć prosty przykład Topica, który przechowuje obecnie 8 otrzymanych wiadomości zapisanych w ten kolejności, w której zostały otrzymane. Kolejna wiadomość, w naszym przykładzie 9, będzie zapisana na końcu tego pliku.
Partycje
Kafka zapewnia nam skalowalność, wysoką wydajność czy odporność na błędy. Na naszym ostatnim przykładzie możemy zauważyć, że mogłoby to być ciężkie do osiągnięcia gdyby budowa Topica, była taka prosta. Z pomocą tutaj przychodzą partycje.

Każdy Topic jest podzielony na 1 lub więcej partycji. Nasz pierwszy przykład pokazywał Topic, w którym była tylko jedna partycja. W naszym obecnym przykładzie możemy zauważyć, że nasz Topic obecnie posiada 3 partycje. Każda z partycji jest osobnym plikiem logów, do którego zapisywane są kolejne wiadomości. Architektura ta wymusza, że kolejność wysłanych wiadomości jest zachowana tylko w obrębie jednej partycji, a nie całego Topicu.
Jak widać, dzięki zastotowaniu partycji Kafka zyskuje na skalowalności oraz wydajności przetwarzania eventów. Do odporności na błędy wrócimy za kilka chwil. Najpierw powiedzmy sobie jeszcze na jakiej podstawie jest wybierana partycja dla wysłanej wiadomości.
Wybór partycji
Partycja dla wysyłanej wiadomości jest wybierana na jeden z poniższych sposobów
Round-Robin
Domyślnym algorytmem wybory partycji jest algorytm Round-Robin. Oznacza to, że kolejne wiadomości będę trafiały do kolejnych partycji.

Partition Key
Kolejnym sposobem wyboru partcji jest tak zwany Partition Key. Przy wysyłaniu wiadomości Procudent może zdefiniować klucz, dła którego zostanie wyliczony hash, a następnie na tej podstawie wiadomość trafi do konkretnej partycji. Zasada działania jest tutaj podobna do mechanizmu, który jest w HashMapie.
Algorytm ten jest przydatny wtedy, kiedy zależy nam na zachowaniu kolejności przetwarzanych wiadomości dla eventów wygenerowanych na przykład dla tego samego usera.

Custom Partitioner
Ostatnim sposobem wybory partycji jest customowy partitioner napisany przez deweloperów uwzgledniający logikę biznesową aplikacji.
Replikacja
I teraz wracamy do wspomnianej wcześniej odporności na błędy i tego jak Kafka sobie z nimi radzi. Kafka posiada mechanizm replikacji, który tworzy repliki danych, dzięki którym nawet gdy jeden z brokerów padnie to żadne dane nie są tracone oraz wciąż pozostają dostępne.

Na powyższym przykładzie możemy zobaczyc sytuacje gdzie dla jednego Topica mamy 3 partycje. Każda z partycji ma dodatkowo jednę replike, która jest na innym brokerze. Każda z partycji ma swojego lidera, który odpowiada za zapis danych oraz za ich replikacje do innych brokerów. W przypadku awarii lidera jedna z replik (follower) przejmuje jego rolę.
Zookeeper
Jednym z elementów ekosystemu Kafki jest Zookeeper. Zookeeper jest odpowidzialny między innymi za:
- wybór lidera partycji – w przypadku awarii brokera, który zawiera Lidera partycji wybierany jest nowy Lider
- konfiguracje Topiców – zawiera informacje o wszystkich Topicach, liczbie replik, liderach, itp.
- konfiguracje Brokerów – zawiera informacje o wszystkich Brokerach, które wchodzą w skład naszego klastra
- ustawienia kontroli dostępu
Warto tutaj zaznaczyć również, że od wersji 3.2.0 Kafka nie wymaga Zookeepera do prawidłowego działania.
Producent
Producent, czyli aplikacja odpowiadająca za wysyłanie wiadomości, publikuje wiadomość na jeden z Topiców.
Wiadomość

Każda wiadomość może składać się z następujących części:
- klucz (opcjonalnie) – jeżeli klucz jest podany wtedy jest używany do wyboru partycji, na który trafia wiadomość (czyli wszystkie wiadomości opublikowane z tym samym kluczem trafią na te samą partycję, a co za tym idzie będzie zachowana ich kolejność wysłania w obrębie właśnie tej partycji); jeżeli klucz nie jest podany to wiadomość będzie opublikowana w partycji zgodnie ze wspomnianym algorytmem Round-Robin lub przy użyciu Custom Partitionera, jeżeli taki jest zaimplementowany.
- wartość – część wiadomości, zawierająca dane biznesowe
- nagłowki (opcjonalnie) – dowolne nagłówki, które możey ustawić, a następnie wykorzystać przy obieraniu wiadomości
- timestamp – po prostu znacznik czasu

Wysyłka
Gdy producent ma już przygotowaną wiadomość to nie pozostaje mu nic innego jak jak wysłanie jej na wybrany Topic.
Konsument
Ostatnim elementem w naszej układance są konsumenci. Na początku musimy zaznaczyć, że Kafka w odróżnienia od innych implementacji kolejek nie wypycha wiadomości do konsumentów. W Kafce to konsumenci muszą odczytywać wiadomości z poszczególnych partycji w ramach wybranego tematu.
Każdy Konsument posiada swój kursor, który wskazuje na kolejną wiadomość w partycji, która będzie odczytana. Po odczytaniu wiadomości rolą Konsumenta jest przesunięcie kursora, na kolejną wiadomość. Mechanizm ten zapewnia, że wiadomości z danej partycji są odczytywane dokładnie w tej kolejności w jakiej zotały na nią zapisane.

Grupa Konsumentów
Consumer groups to mechanizm w Kafce, który umożliwia wielu klientom jednoczesne odbieranie danych z tematów. Grupa konsumentów to logiczna jednostka, która składa się z jednego lub więcej konsumentów, którzy odbierają wiadomości z tematu. Każdy konsument może odbierać wiadomości z dowolnej liczby partycji. Natomiast z jednej partycji może wiadomości odbierać maksymalnie jeden Konsument w ramach jednej Grupy Konsumentów. Może to brzmieć trochę zawile, ale jak zerkniemy na poniższe przykłady to wszystko powinno stać się jasne.

Na powyższym przykładzie widzimy 3 Grupy Konsumentów, które odczytują wiadomości z jednego Tematu. Jak możemy zauważyć każda z Grup ma inną liczbę Konsumentów, a każdy z nich ma przypisany jedną lub więcej partycji do odczytu.

Na powyższym obrazku mamy z kolei przykład gdzie Grupa Konsumentów, zawiera więcej Konsumentów niż jest partycji w danym Temacie. W takim przypadku jeden z Konsumentów pozostaje nieaktywny i nie wykonuje żadnej pracy związanej z odczytywaniem wiadomości.
Podsumowanie
W tym wpisie przeanalizowaliśmy z jakich elementów składa się Ekosystem Kafki. Poznaliśmy również jakie elementy powodują to, że Kafka może byc tak wydajna, w jaki sposób się skaluje oraz dzięki czemu jest zapewniona trwałość danych w Kafce.
Artykuł Co w Kafce piszczy? pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Artykuł Nowości w Java 15 pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Algorytm podpisu cyfrowego

Pierwszą zmianą, opisaną po numerem JEP 339, jest nowy algorytm podpisu cyfrowego oparty na krzywych eliptycznych. Jego oryginalna nazwa to Edwards-Curve Digital Signature Algorithm, a w skrócie EdDSA.
Poniżej zobaczmy jak możemy wykorzystać nowy algorytm w naszym kodzie i przykładowy wynik.
KeyPairGenerator keyPairGenerator = KeyPairGenerator.getInstance("EdDSA");
KeyPair keyPair = keyPairGenerator.generateKeyPair();

PublicKey publicKey = keyPair.getPublic();
PrivateKey privateKey = keyPair.getPrivate();

System.out.println(Arrays.toString(publicKey.getEncoded()));
System.out.println(Arrays.toString(privateKey.getEncoded()));
[48, 42, 48, 5, 6, 3, 43, 101, 112, 3, 33, 0, 53, -105, 68, 17, -24, 121, -109, 99, -12, 119, 6, -41, -15, -70, 86, -111, -74, 107, -67, 79, -61, 0, 87, 118, -35, -95, -9, 108, 87, -123, -61, 54] [48, 46, 2, 1, 0, 48, 5, 6, 3, 43, 101, 112, 4, 34, 4, 32, 70, -23, -62, -45, -124, 28, 89, 127, 51, -71, -17, -31, -26, 48, 82, -100, -47, 23, -48, 103, 123, 49, 90, 66, 43, -116, -28, 15, 42, 121, -1, -119]
Przy każdym uruchomieniu powyższego kodu oczywiście jest generowana nowa para kluczy.
Zapieczętowane klasy

Kolejną nowością są Sealed Classes, które są opisane pod JEP 360. Jest to feature oznaczony jako Preview, oznacza to, że ostateczna wersja tej funkcjonalności może jeszcze ulec zmianie.
Standardowo, kiedy tworzymy klasy, których nie oznaczamy jako final to mogą być dziedziczone przez dowolną inną klasę (zakładając, że modyfikator dostępu pozwala na dostęp do niej).
Mechanizm Sealed Classes pozwala na stworzenie zamkniętej hierarchii klas, czyli takiej, która nie będzie mogła być rozbudowana. Może to być użyteczne, kiedy chcemy stworzyć hierarchie klas, która nie powinna być rozszerzana np. w ramach jednego modułu.
Sprawdźmy zatem w jaki sposób możemy zaimplementować naszą 'zapieczętowaną’ hierarchie.
Na początku musimy zadeklarować naszą klasę bazową wraz z wszystkimi klasami, które po niej bezpośrednio dziedziczą.
sealed class Vehicle
      permits Bike, Car, Boat {
}
W powyższym kodzie pojawiają się dwa nowe słowa kluczowe sealed i permits. Pierwszym słowem oznaczamy, że nasza klasa będzie 'zapieczętowana’ czyli dziedziczona tylko przez określone klasy. Po drugim słowie kluczowym musimy wylistować wszystkie dziedziczące klasy.
Teraz zaimplementujmy nasze 3 klasy, które zdefiniowaliśmy wcześniej.
final class Bike extends Vehicle {}non-sealed class Boat extends Vehicle {}sealed class Car extends Vehicle
permits Audi {}To co możemy od razu zauważyć to 3 różne sposoby jak klasy są zdefiniowane. Klasy dziedziczące po 'zapieczętowanej’ klasie muszą mieć jedno z poniższych słów kluczowych w swojej definicji:
- final – oznaczamy w ten sposób, że po klasie nie będzie można dziedziczyć,
- non-sealed – oznaczamy w ten sposób, że po klasie będzie można dziedziczyć, czyli w przypadku normalnej klasy jest to odpowiednik klasy bez słowa kluczowego final,
- sealed – w ten sposób rozpoczynamy nową hierarchie klas czyli również musimy zdefiniować klasy dziedziczące po słowie permits.
Jeszcze na koniec spróbujmy stworzyć klasę, która dziedziczy po klasie Vehicle, ale nie została zdefiniowana w hierachii.
class Train extends Vehicle {}Przy próbie kompilacji powyższego kodu otrzymamy następujące błąd:
java: class is not allowed to extend sealed class: Vehicle
Ukryte klasy

Następną nową funkcjonalnością, o której sobie powiemy są Hidden Classes, o których możemy poczytać w tym dokumencie: JEP 371.
Mechanizm ten, pozwala nam zdefiniować klasy, które nie będą mogły być użyte przez bytecode innych klas. Ideą, która stoi za ukrytymi klasami jest umożliwienie framework-om czy językom na JVM generowanie klas w czasie wykonania programu (Runtime) i używanie ich przez refleksje.
Usunięcie silnika JavaScriptu

Kolejną zmianą, o której można poczytać tutaj, jest usunięcie silnika JavaScriptu – Nashorn, który był oznaczony jako deprecated, od Javy 11.
Wyłączenie Biased Locking

Biased Locking jest pewną optymalizacją, która występuje przy synchronizacji. JVM jest w stanie wykryć czy synchronizowany obiekt jest używany tylko przez jeden wątek. Jeżeli tak, to JVM jest w stanie wykonać kolejne operacje na tym obiekcie bez ponoszenia kosztów związanych z synchronizacją.
Do Javy 15 mechanizm ten był domyślnie włączony. Od wersji 15 został on wyłączony, a dodatkowo sam mechanizm został oznaczony jako deprecated.
Więcej informacji na ten temat możemy znaleźć w JEP 374.
Dopasowanie wzorca dla instanceof

Kolejna zmiana w Java 15, która jest opisana w JEP 375, to Pattern Matching for instanceof. Funkcjonalność pojawiła się poraz pierwszy w Javie 14 i była oznaczona jako Preview. Obecnie funkcjonalność oznaczona jest jako Second Preview.
Tą funkcjonalność najłatwiej będzie wytłumaczyć na przykładzie, zatem od razu do niego przechodzimy
Załóżmy, że chcemy stworzyć metodę, która przyjmuje jeden parametr i zwraca jego rozmiar. Haczyk tkwi w parametrze, który może być zarówno Stringiem jak i listą.
Napiszmy więc taką metodę bez używania nowego mechanizmu.
static int getSize(Object obj) {
   if (obj instanceof String) {
      return ((String) obj).length();
   } else if (obj instanceof List) {
      return ((List<?>) obj).size();
   }
   return 0;
}
Ponieważ chcemy, żeby nasza metoda była uniwersalna to musimy przyjąć Object jako parametr. Następnie dla każdego obsługiwanego typu robimy sprawdzenie typu używając instanceof, a następnie robimy jawne rzutowanie na dany typ, na którym wywołujemy metodę odpowiedzialną za wyliczenie rozmiaru dla tego typu, czyli np. String.length() czy List.size().
Teraz pora na podobną metodę, ale używając mechanizmu Pattern Matching.
static int getSize(Object obj) {
   if (obj instanceof String str) {
      return str.length();
   } else if (obj instanceof List<?> list) {
      return list.size();
   }
   return 0;
}
Tutaj podobnie jak poprzednio przyjmujemy Object jako parametr, a następnie możemy zauważyć użycie nowego mechanizmu. Przy sprawdzaniu typu obiektu przy pomocy instanceof, po podaniu typu, do którego porównujemy (np. String czy List w naszym przykładzie) podajemy nazwę zmiennej, pod którą będzie dostępny nasz parametr rzutowany już na dany typ. Dzięki temu w danym bloku if’a możemy używać nowej zmiennej i wywoływać na niej metody odpowiednie dla danego typu bez konieczności robienia jawnego rzutowania.
Nowy algorytm Garbage Collector

Kolejną nowością, która jest opisana po numerem JEP 377, jest nowy algorytm Garbage Collectora nazwany Z Garbage Collector. Nowy mechanizm został wprowadzony już w Javie 11, ale jako funkcjonalność eksperymentalna.
Głównymi cechami nowego algorytmu mają być małe opóźnienia (max 10ms) przy jednoczesnej obsłudze Stosów (Heap) o rozmiarach mierzonych w terabajtach.
Bloki Tekstowe

Następną funkcjonalnością są Bloki Tekstowe (Text Blocks) oznaczone JEP 378. Funkcjonalność została wprowadzona w Java 13 (Preview), a następnie w Java 14 jako Second Preview.
Bloki tekstowe pozwalają nam stworzyć wielolinijkowe Stringi w wygodny sposób. Poniżej sprawdźmy przykład takiego bloku oraz wynik tego fragmentu kodu.
String text = """
      Lorem ipsum dolor sit amet,
      consectetur adipiscing elit.
      Donec rutrum ac lectus sed rhoncus.
      """;
System.out.println(text);
Lorem ipsum dolor sit amet,
consectetur adipiscing elit.
Donec rutrum ac lectus sed rhoncus.
Kolejny Garbage Collector

I po raz kolejny w zestawieniu mamy algorytm Garbage Collector. Jest to finalna wersja algorytmu, którego pierwsza wersja została wprowadzona w Java 11. Algorytm Shenandoah został opisany pod numerem JEP 379.
Algorytm działa na podobnej zasadzie jak G1, z tym że wykonuje operacje kompaktowania również w sposób współbieżny.
Usunięcie SOLARISa

JEP 381 to oznaczenie kolejnej zmiany w Java 15, którą jest usunięcie kodu związanego z systemem operacyjnym SOLARIS oraz architekturą SPARC.
API do pamięci zewnętrznej

Kolejną nowością oznaczoną jako JEP 383 jest API dostępu do pamięci zewnętrznej (Foreign-Memory Access API). Feature jest oznaczony jako Second Incubator, czyli jest to funkcjonalność, która jeszcze nie jest w pełni skończona, może być zmieniona czy nawet usunięta w przyszłych wersjach Javy.
Nowe API dostarcza bezpieczny i wydajny sposób dostępu do pamięci, zarówno Heapa jak i pamięci natywnej.
Rekordy

Kolejna, przedostatnia już nowość, to Rekordy (Records) oznaczone numerem JEP 384. Feature jest oznaczony jako Second Preview czyli mogą w nim zostać wprowadzone jeszcze jakieś zmiany, ale nie powinniśmy spodziewać się rewolucji
Rekordy są mechanizmem, który pozwala nam stworzyć Data Class, czyli klasę która zawiera pola wraz metoda dostępowymi do nich, implementacje metod equals, hashCode oraz toString. Jeżeli używaliśmy wcześnie biblioteki lombok to mogliśmy to osiągnąć przez użycie adnotacji @Data na klasie.
Spójrzmy zatem na przykładową implementacje rekordu oraz jego użycia.
record Point(int x, int y) {}Point p = new Point(1, 3);
System.out.println("p.x() = " + p.x());
System.out.println("p.y() = " + p.y());
System.out.println("p = " + p);p.x() = 1 p.y() = 3 p = Point[x=1, y=3]
Jak widzimy implementacja Rekordu polega na użyciu słowa kluczowe records zamiast class oraz zdefiniowaniu pól w nagłówku klasy.
Oznaczenie RMI Activation jako do usunięcia
Ostatnią zmianą, która następuję w Java 15, jest oznaczenie mechanizmu RMI Activation jako deprecated z informacją, że będzie usunięty w przyszłości. Zmiana ta jest oznaczona numerem JEP 385.
Podsumowanie
Dzisiaj przyjrzeliśmy się wszystkim zmianom i nowością w Java 15. Część z nich prawdodpobnie nie wpłynie na naszą codzienną pracę, lecz z pewnością funkcjonalności takie jak Rekordy, Bloki Tekstowe czy Dopasowanie Wzorca dla instanceof mogą ułatwić nasze codzienne obcowanie z nową wersją Javy
Artykuł Nowości w Java 15 pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Artykuł Rozwój klasy String w Java od wersji 8 do 15. pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Java 8
W Javie 8 String wzbogacił się o dwie metody statyczną join. Przyjmuje ona separator (delimiter) jako pierwszy parametr i tablicę lub listę Stringów, które mają zostać połączone w jeden ciąg znaków jako drugi parametr.
Sygnatury tych metod wyglądają jak poniżej:
public static String join(CharSequence delimiter, CharSequence... elements)
public static String join(CharSequence delimiter, Iterable<? extends CharSequence> elements)
I teraz pora na przykład użycia wraz z wynikiem
String result = String.join(", ", "pies", "kot", "papuga");
System.out.println("result = " + result);
result = pies, kot, papuga
Java 9
Kolejna wersja Javy przyniosła kolejne dwie metody do klasy String – chars() oraz codePoints(). Ich sygnatury wyglądają odpowiednio:
public IntStream chars()
public IntStream codePoints()
Metody służą zwracają IntStream dla znaków, z których składa się String. Pierwsza metoda zwraca stream z wartościami, które mogliśmy wcześniej uzyskać przy pomocy metod String#charAt(int) czy String#toCharArray().
Druga metoda zwraca wartości, które mogliśmy uzyskać wcześniej przy pomocy metody String#codePointAt(int).
Poniżej możemy zobaczyć przykłady użycia powyższych metod
String value = "Hello!";

value.chars().forEach(i -> System.out.print(i + " "));

System.out.println();

value.codePoints().forEach(i -> System.out.print(i + " "));
I wynik wykonania powyższego kodu:
72 101 108 108 111 33
72 101 108 108 111 33
Java 10
W Javie 10 nie otrzymaliśmy żadnych nowych metod w klasie String.
Java 11
W Javie 11 możemy znaleźć aż 6 nowych metod.
Strip w 3 odmianach
Najpierw omówmy 3 metody, które służą do pozbywania się białych znaków ze Stringa. Od wersji 11 możemy znaleźć następujące metody:
- strip()
- stripLeading()
- stripTrailing()
Ich sygnatury wyglądają następująco:
public String strip()
public String stripLeading()
public String stripTrailing()
Metody te służą do usuwania białych znaków ze Stringa odpowiednio:
- z początku i końca łańcucha znaków,
- z początku łańcucha znaków,
- z końca łańcucha znaków.
I standardowo przykład użycia
String value = "\t  Hello!\t   ";

System.out.println("\"" + value.strip() + "\"");
System.out.println("\"" + value.stripLeading() + "\"");
System.out.println("\"" + value.stripTrailing() + "\"");
"Hello!"
"Hello!       "
"      Hello!"
Czy łańcuch jest pusty?
Kolejną metodą, którą poznajemy w Javie 11 jest metoda isBlank() z poniższą sygnaturą.
public boolean isBlank()
Metoda pozwala nam sprawdzić czy łańcuch znaków jest pusty (długość jest równa 0) lub zawiera tylko białe znaki.
Zobaczmy teraz przykład użycia i wynik poniższego kodu:
String value1 = "\t   ";
String value2 = "\t   Hello";

System.out.println(value1.isBlank());
System.out.println(value2.isBlank());
true
false
Linia po linii
Następną metodą jest lines(), która zwraca nam Stream, który umożliwia iteracje po liniach tekstu. Przez znaki nowej linii powinniśmy rozumieć:
- \n
- \r
- \r\n
Sygnatura metody wygląda następująco:
public Stream<String> lines()
I przykład użycia:
String value = "Don't\neat\ryellow\r\nsnow";

value.lines().forEach(System.out::println);
oraz wynik:
Don't
eat
yellow
snow
Powtarzanie
Ostatnią nową metodą dostępna w Javie 11 jest metoda repeat o następującej sygnaturze:
public String repeat(int count)
Metoda zwraca nam nasz łańcuch znaków powtórzony o daną liczbę razy.
I lecimy z przykładem
String value = "Hello!";

System.out.println(value.repeat(3));
Hello!Hello!Hello!
Java 12
Kolejna wersja Javy dostarczyła kolejne 4 metody do klasy String.
Wcięcie
Pierwszą metodąm którą omówimy będzię indent, której sygnatura wygląda następująco:
public String indent(int n)
Metoda pozwala na ustawienie takiego samego wcięcia dla każdej linii tekstu z naszego łańcucha tekstowego. Linie w Stringu powinniśmy rozumieć w dokładnie taki sam sposób jak to się dzieję w metodzie lines opisanej wyżej.
Poniżej możemy zobaczyć przykład użycia wraz z wynikiem:
String value = "Don't\neat\ryellow\r\nsnow";

value.indent(4).lines().forEach(l -> System.out.println("\"" + l + "\""));
"    Don't"
"    eat"
"    yellow"
"    snow"
Transformacja!
Kolejna metoda to transform, która umożliwia nam dokonania transformacji na naszym łańcuchu znaków przy pomocy Function.
I oczywiście przykład użycia
String value = "hello!";

String result = value.transform(String::toUpperCase);
System.out.println(result);
HELLO!
Nowe interfejsy w Stringu
W Javie 12 klasa String implementuje dwa nowe interfejsy: Constable oraz ConstantDesc. Interfejsy te powstały, żeby definiować, które klasy mogą zostać użyte w Constant Pool, który jest częścią skompilowanego pliku źródłowego klasy Javovej czyli pliku .class.
Powyższe dwa interfejsy dostarczają po jednej metodzie i są to odpowiednio describeConstable oraz resolveConstantDesc.
Optional<? extends ConstantDesc> describeConstable()
Object resolveConstantDesc(MethodHandles.Lookup lookup) throws ReflectiveOperationException;
W przypadku Stringa, pierwsza metoda zawsze zwróci instancje naszego łańcucha opakowaną w Optional. Druga natomiast zawsze zawróci instancję naszego Stringa, niezależnie od przekazanego parametru.
I przykłady użycia oczywiście wraz z wynikiem:
String value = "Hello!";

System.out.println(value.describeConstable());
System.out.println(value.resolveConstantDesc(null));
Optional[Hello!]
Hello!
Java 13 i 14
W kolejnych dwóch wersjach Javy klasa String nie została zmieniona.
Java 15
W tej wersji otrzymaliśmy 3 nowe metody.
Usuwanie wcięcia
Pierwszą metodą, którą omówimy jest stripIndent o poniższej sygnaturze:
public String stripIndent()
Metoda służy do usuwania wcięcia na początku każdej linii. Przez wcięcie powinniśmy rozumieć najmniejsze wcięcie, które pojawia się w naszym łańcuchu znaków. Czyli na przykład, jeżeli pierwsza linia zaczyna się od dwóch spacji, a druga linia od 1 spacji to głębokość wcięcia, które zostanie usunięte ze wszystkich linii to 1.
Możemy to prześledzić na poniższym przykładzie:
String value = "  Don't\n   eat\n yellow\n    snow";

System.out.println(value.stripIndent());
 Don't
  eat
yellow
   snow
Tłumaczenie znaków specjalnych
Kolejną metodą jest translateEscapes, która umożliwia wychwycenie znaków specjalnych jak znak nowej linii czy tabulatora w tekście i ich odpowiednią interpretacje.
Sygnatura metody jest następująca:
public String translateEscapes()
Na przykładzie możemy zobaczyć o co dokładnie chodzi w działaniu metody.
String value = "Don't\\neat\\tyellow\\ssnow";

System.out.println(value.translateEscapes());
Don't
eat    yellow snow
Formatowanie
Ostatnią metodą, którą omówimy jest metoda formatted służąca do formatowania Stringa i 'wstawianiu’ do niego podanych argumentów.
Sygnatura wygląda w następujący sposób:
public String formatted(Object... args)
I przykład użycia wraz z resultatem:
String value = "String value: %s \nInteger value: %d";

System.out.println(value.formatted("sv1", 15));
String value: sv1
Integer value: 15
Podsumowanie
Dzisiaj zapoznaliśmy się ze wszystkimi metodami, które zostały dodane do Stringa od Javy 8. Wiele z tych metod z pewnością może nam się przydać na codzień i jednocześnie może zastąpić metody utilsowe, które używaliśmy do tej pory.
Artykuł Rozwój klasy String w Java od wersji 8 do 15. pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Artykuł Szósta edycja hackatonu HackYeah 2020! pochodzi z serwisu Lukasz Antkowiak's blog.
]]> Jest to największy stacjonarny hackathon w Europie. Najbliższa edycja odbędzie się w sieci, w dniach 27-29 listopada 2020. Bilety są darmowe, a pula nagród w tym momencie wynosi 150 000 PLN!
Poniżej zamieszczam więcej szczegółów na temat wydarzenia i serdecznie zapraszam do udziału

Hackathon zrzesza osoby wyspecjalizowane w przeróżnych językach programowania, a jego celem jest poszukiwanie rozwiązań oraz narzędzi, które usprawnią codzienność zwykłych ludzi. Podczas każdej edycji, event skupia wokół siebie kreatywne umysły – osoby biorące udział w HackYeah! noszą w sobie prawdziwą chęć działania i faktycznej zmiany. Dzięki nieocenionym umiejętnościom i błyskotliwym pomysłom uczestników, każda kolejna edycja HackYeah! owocuje nieszablonowymi i praktycznymi rozwiązaniami, które wykorzystują najnowsze technologie do osiągania zamierzonych rezultatów.
Jakie zadania staną przed uczestnikami?
Podczas najbliższej edycji HackYeah! uczestnicy będą szukać rozwiązań w wielu kategoriach. Wśród nich pojawią się kategorie otwarte, w których można zgłaszać wszelkie pomysły związane z daną tematyką oraz zadania partnerskie, które będą dotyczyć konkretnych zagadnień, ustalonych przez Partnera danego zadania. Organizatorzy na chwilę obecną ujawnili, jakie są dwie kategorie otwarte. Podczas najbliższej edycji HackYeah! będą to:
- Zero Waste – kategoria wspierana przez WWF Polska, w której pula nagród wynosi 10 000 PLN
- Zdrowie – kategoria wspierana przez Fundację Rak’n’Roll Wygraj Życie!, w której pula sięga 10 000 PLN
Wśród licznych zadań partnerskich pojawią się zadania od Głównego Partnera tej edycji – Banku Gospodarstwa Krajowego. Partnerzy hackathonu wciąż pracują nad kolejnymi zadaniami, natomiast pula nagród w tym momencie wynosi 150 000 PLN. Organizatorzy zapowiedzieli, że wszelkimi nowościami będą się dzielić na stronie internetowej oraz w mediach społecznościowych:
WWW: https://hackyeah.pl/
Facebook: https://www.facebook.com/HackYeahPL/
HackYeah! – dla kogo?
Udział w wydarzeniu jest otwarty dla wszystkich chętnych: studentów, programistów, UXowców, project managerów, inżynierów, ekspertów baz danych, analityków czy gamerów. Uczestnicy w ciągu łącznie 40 godzin będą intensywnie pracować nad rozwiązaniami z zakresu szeroko pojętej ekologii, zero waste, zdrowia i innych. Niepodważalną zachętą dla uczestników jest szansa dalszego rozwoju swojego pomysłu i wdrożenia go w życie. Projekty biorące udział w konkursie mogą być zgłaszane indywidualnie lub w zespołach złożonych z maksymalnie 6 osób. Komunikacja pomiędzy uczestnikami, organizatorami, mentorami i jurorami odbywać się będzie na kanale Discord, do którego można dołączyć już dziś: https://discord.gg/6bs6cHk Każdy biorący udział w hackathonie może liczyć na wsparcie od wyspecjalizowanych mentorów – dotyczy ono zarówno kwestii technicznych, jak i sposobów wdrażania pomysłów na rozwiązania poszczególnych zadań.
– Organizujemy HackYeah, ponieważ wierzymy, że to właśnie formuła hackathonu eksploruje w całości ogromny potencjał innowacyjnych pomysłów, który drzemie w społecznościach ze świata IT. Zachęcamy do udziału wszystkich tych, którzy mają pomysły oraz chęć i odwagę, by się nimi dzielić oraz wspólnie tworzyć wartościowe rozwiązania. Historia niejednokrotnie pokazała, że hackathon może zmieniać rzeczywistość na lepsze i to jest naszym celem. – Jakub Kozioł, prezes PROIDEA Sp. z o.o.
Cieszę się, że sektor publiczny po raz kolejny zaprasza programistów do współpracy przy rozwiązywaniu wyzwań wagi państwowej. Każdy hackathon to czas, kiedy administracja i innowatorzy uczą się wiele od siebie nawzajem pracując nad pożytecznymi dla obywateli rozwiązaniami. HackYeah już wielokrotnie udowodniło, że podczas największego maratonu programowania w Europie ten efekt jest zwielokrotniony. – Justyna Orłowska – Pełnomocnik Prezesa Rady Ministrów ds. GovTech
Coś więcej niż hackathon
Organizatorzy przekonują, że HackYeah! to więcej niż hackathon – to także wielki festiwal IT.
Poza kodowaniem:
- to również niepowtarzalna okazja do wzięcia udziału w licznych i różnorodnych pod względem tematyki webinariach, które będą streamowane na żywo na Facebookowym profilu HackYeah! od 23 do 27 listopada;
- pojawi się nowość: HackYeahTV! – internetowa transmisja, podczas której będą emitowane najświeższe wiadomości dotyczące hackathonu, wywiady z partnerami i uczestnikami poprzednich edycji, webinaria tematyczne, playlisty i różne atrakcje;
- organizatorzy zadbają o utrzymanie festiwalowej atmosfery znanej z pięciu poprzednich edycji hackathonu, tym razem przeniesionego do świata wirtualnego. Możecie spodziewać się rozgrywek online, wielu różnorodnych aktywności i konkursów, dzięki którym miło spędzicie czas podczas tego produktywnego weekendu;
- uczestnicy będą mogli wziąc udział w turnieju gamingowym;
- spodziewajcie się niekończących dyskusji z setkami mentorów i uczestników. Można zawrzeć nowe przyjaźnie lub znaleźć partnerów biznesowych;
- to idealne miejsce na znalezienie pracy. Wystarczy rozpocząć rozmowę z wybranym Partnerem na jego wirtualnym stoisku lub kanale Discord, by otrzymać komplet informacji odnośnie aktualnie prowadzonych rekrutacji w firmie.
Kto stoi za kulisami?
Organizatorem wydarzenia jest PROIDEA – firma od lat organizująca wydarzenia kierowane do branży IT, pomysłodawca i producent HackYeah. Wydarzenie wspiera GovTech Polska – program funkcjonujący w Kancelarii Prezesa Rady Ministrów mający na celu angażowanie społeczności we wprowadzanie innowacji do sektora publicznego. Współpracuje z firmami technologicznymi, oraz obywatelami, aby wspólnie unowocześnić administrację publiczną oraz znaleźć sposoby na użycie technologii w realizacji zadań podejmowanych przez Państwo. Głównym Partnerem wydarzenia jest Bank Gospodarstwa Krajowego.
Do inicjatywy dołączyło już wiele publicznych i prywatnych instytucji, zarówno polskich jak i międzynarodowych, które dostarczają wiedzę i mentorów do pomocy uczestnikom. Zapraszamy do współpracy media, firmy i organizacje, które mają pomysły na to, jak technologia może usprawnić szeroko pojętą ekologię i zdrowie.
Artykuł Szósta edycja hackatonu HackYeah 2020! pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Artykuł JDD 2020 oraz zniżka na wejściówkę :) pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Tym razem trochę nietypowo, bo spotkamy się wirtualnie w dniach 12-14 października.
Zniżka!
Mam dla Was 15% zniżki!
Użyjcie kodu: ANTKOWIAK_AT_JDD
Bilety znajdziecie tu: https://app.evenea.pl/event/jdd2020

Kilka słów o konferencji
JDD 2020 to trzydniowe wydarzenie, które odbędzie się sieci. Organizatorzy po raz kolejny zrzeszają miłośników Javy, jak to ma miejsce od 2006 roku.
W tym roku na JDD znajdziemy tematy na różnych poziomach zaawansowania. Coś dla siebie znajdą zarówno junior, mid, jak i senior deweloperzy. Pośród morza tematów pojawią się: JVM (Java, Scala, Kotlin…), Agile, Functional Programming, Testing, TDD, BDD, Microservices, Docker, Kubernetes, Clean code, Cloud, AWS, design, DDD, Machine learning, AI, Future of Java, Functional Programming, Architecture, Getting Started.
Agenda konferencji znajduje się na stronie: https://jdd.org.pl/
Co jeszcze na samej konferencji?
- najnowsze tematy z zakresu Java oraz cenieni Javowi eksperci i keynote speakerzy
- wirtualne dyskusje wśród Javowych społeczności oraz sesje Q&A z prelegentami
- konkursy z nagrodami i świetna atmosfera
Oraz to co wszyscy lubią najbardziej czyli urodzinowe GIFTY!
- bluzy JDD, kraftowe piwko “Java Dream”, voucher na pyszny obiad
- darmowa wejściówka na 4Developers 2020 GRATIS!
- 15% zniżki na #JDD 2021!
Artykuł JDD 2020 oraz zniżka na wejściówkę :) pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Artykuł Deploy aplikacji na AWS pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Sam deployment, podobnie jak w przypadku OpenShift, zrobimy za pomocą linii komend. Na tym etapie pominiemy opisywanie poszczególnych komponentów AWS, a skupimy się na tym, żeby nasza aplikacja działała w chmurze.
Aplikacja
Omówmy sobie najpierw aplikacje, którą będziemy wrzucać do chmury. Aplikacja znajduję się w tym miejscu. Jest to, podobnie jak w przypadku aplikacji, którą wrzucaliśmy na Openshift, najprostsza aplikacja na SpringBoocie z jednym kontrolerem RESTowym. Jedyną doatkową rzeczą, którą musimy zrobić to dodanie pliku application.properties, w którym dodajemy następującą linię.
server.port=${PORT:8080}
Elastic Beanstalk wymaga, aby aplikacja była dostępna na porcie 5000, a domyślnym portem dla aplikacji SpringBoot jest port 8080. Dodając powyższą linię w konfiguracji dajemy możliwość wstrzyknięcia wartości tej własności z zewnątrz.
Rejestracja
Pierwszym krokiem, który musimy zrobić jest oczywiście rejestracja w serwisie Amazona. Samo założenie konta jest darmowe. Płacimy jedynie za używanie usług AWSa. Na szczęście część funkcjonalności jest darmowe do pewnego zużycia transferu czy innych zasobów. I ta darmowa część powinna nam starczyć do deployu prostej aplikacji
Command Line Interface
Skoro mamy obsłużyć deployment przy pomocy linii komend to zdecydowanie przyda nam się CLI dla AWS, a konkretniej mówiąc Elastic Beanstalk CLI. Elastic Beanstalk jest usługą w ramach AWS, na którą będziemy deployować naszą aplikację.
Wchodzimy na tę stronę, a następnie korzystamy z załączonej instrukcji do instalacji EB CLI. W telegraficznym skrócie:
- Klonujemy repozytorium EB CLI
git clone https://github.com/aws/aws-elastic-beanstalk-cli-setup.git - Instalujemy EB CLI przy pomocy następującej komendy:
.\aws-elastic-beanstalk-cli-setup\scripts\bundled_installer
I to w teorii powinno wystarczyć.
W praktyce wystąpił u mnie następujący problem:No module named 'virtualenv'
Na szczęści w intrukcji mamy dział Troubleshooting, który pomoże nam w rozwiązaniu naszych problemów
W moim przypadku trzeba byłoby wykonać poniższe polecenia:pip uninstall -y virtualenv
pip install virtualenv
python .\aws-elastic-beanstalk-cli-setup\scripts\ebcli_installer.py
Po tych ciężkich bojach powinniśmy mieć zainstalowane Elastic Beanstalk CLI.
Dla sprawdzenia wywołajmy następujące polecenie w linii komend:
eb --version
W odpowiedzi powinniśmy uzyskać informacje o wersji zainstalowanej biblioteki.
EB CLI 3.15.3 (Python 3.7.3)
AWS Secret Access Keys
Nadeszła pora na uwierzytelnienie w AWS. Będziemy robić to za pomocą sekretnych kluczy wygenerowanych w AWSie. Jest to rozwiązanie zdecydowanie bezpieczniejsze niż podawanie hasła bezpośrednio do naszego pliku konfiguracyjnego.
Aby stworzyć parę Access key ID – Secret Access Key musimy udać się na tę stronę i wybrać zakładkę Access keys.
Następnie klikamy Create New Access Key i otrzymujemy naszą parę.

Pamiętajmy, że jest to jedyny moment kiedy możemy skopiować wartość Serect Access Key.

Konfiguracja EB
Przyszła pora stworzenie pliku konfiguracyjnego dla Elastic Beanstalk.
Przechodzimy do katalogu z naszą aplikacją i wykonujemy następujące polecenie:
eb init
W pierwszej kolejności zostaniemy poproszeni o wybór regionu, w którym ma zostać umieszczona nasza aplikacja.
Select a default region
 1) us-east-1 : US East (N. Virginia)
 2) us-west-1 : US West (N. California)
 3) us-west-2 : US West (Oregon)
 4) eu-west-1 : EU (Ireland)
 5) eu-central-1 : EU (Frankfurt)
 6) ap-south-1 : Asia Pacific (Mumbai)
 7) ap-southeast-1 : Asia Pacific (Singapore)
 8) ap-southeast-2 : Asia Pacific (Sydney)
 9) ap-northeast-1 : Asia Pacific (Tokyo)
 10) ap-northeast-2 : Asia Pacific (Seoul)
 11) sa-east-1 : South America (Sao Paulo)
 12) cn-north-1 : China (Beijing)
 13) cn-northwest-1 : China (Ningxia)
 14) us-east-2 : US East (Ohio)
 15) ca-central-1 : Canada (Central)
 16) eu-west-2 : EU (London)
 17) eu-west-3 : EU (Paris)
 18) eu-north-1 : EU (Stockholm)
 19) ap-east-1 : Asia Pacific (Hong Kong)
 20) me-south-1 : Middle East (Bahrain)
Region w AWS jest miejsce gdzie fizycznie znajdują się serwery. Jak widać na liście Amazon posiada swój sprzęt w naprawdę wielu miejscach Dla naszych potrzeb wybór konkretnego regionu nie jest specjalnie istotny, ale wybierzmy region, który znajduje się najbliżej nas – eu-west-2 : EU (London). W moim przypadku jest to region nr 16.
W następnym kroku będziemy musieli podać informacje o AWS Secret Keys, które wygenerowaliśmy chwilę wcześniej.
You have not yet set up your credentials or your credentials are incorrect
 You must provide your credentials.
(aws-access-id):
Podajemy nasze klucze i idziemy dalej.
Kolejny krok to miejsce gdzie musimy podać nazwę naszej aplikacji.
Enter Application Name
 (default is "aws-hello-world"):
Możemy pozostać przy domyślnej nazwie. Zatwierdzamy ją i idziemy do kolejnego kroku.
Teraz musimy wybrać język naszej aplikacji.
Select a platform.

1) Node.js

2) PHP

3) Python

4) Ruby

5) Tomcat

6) IIS

7) Docker

8) Multi-container Docker

9) GlassFish

10) Go

11) Java

12) Packer

(default is 1):
Wybieramy oczywiście Java i zatwierdzamy.
Następnie dostaniemy pytanie o wersje Javy.
Select a platform version.

1) Java 8

2) Java 7

(default is 1):
Wybieramy zatem pożądaną wersje Javy, w naszym przypadku Java 8
Teraz dostaniemy pytanie o to czy chcemy kontynuować z CodeCommit.
Do you wish to continue with CodeCommit? (y/N) (default is n):
CodeCommit jest serwisem kontroli wersji dostarczonym przez AWS. My nie chcemy z niego korzystać w tym momencie, więc wybieramy opcję domyślną, czyli 'n’.
Kolejne pytanie jest o konfiguracje SSH.
Do you want to set up SSH for your instances?

(Y/n):
Wybieramy 'Y’ po czym będziemy musieli wybrać istniejącą parę kluczy lub stworzyć nową.
Select a keypair.

1) key-pair-lantkowiak

2) my-ubuntu-key

3) my-windows-key

4) [ Create new KeyPair ]

(default is 3):
Jeżeli mamy potworzone klucze to zostaną one wyświetlone, żebyśmy mogli z nich skorzystać. Jeżeli nie, to pojawi się jedynie opcja z tworzeniem nowej pary kluczy. Podejmujemy wybór i zatwierdzamy.
W tym momencie w katalogu naszego projektu został wygenerowany następujący plik: .elasticbeanstalk\config.yml, który będzię wyglądał w następujący sposób:
branch-defaults:
  master:
    environment: null
    group_suffix: null
global:
  application_name: aws-hello-world
  branch: null
  default_ec2_keyname: my-windows-key
  default_platform: Java 8
  default_region: eu-west-2
  include_git_submodules: true
  instance_profile: null
  platform_name: null
  platform_version: null
  profile: eb-cli
  repository: null
  sc: git
  workspace_type: Application
Jak możemy zobaczyć jest to plik, który zawiera głównie rzeczy, które przed chwilą konfigurowaliśmy.
Budowanie i JAR do chmury
Zbudujmy teraz naszą aplikacje. To, na czym nam dokładnie zależy to uzyskania JARa, który będziemy deployować. Wykonajmy zatem następujące polecenie mavenowe:
mvn clean package
To powinno zbudować nam naszą paczkę, którą znajdziemy pod tą lokalizacją: target\hello-world-0.0.1-SNAPSHOT.jar.
W tym momencie musimy delikatnie zmodyfikować plik konfiguracyjny EB i dodać informacje o tym, gdzie znajduje JAR, który będzie deployowany. Robimy to przy pomocy takiego parametru:
deploy:
  artifact: target/hello-world-0.0.1-SNAPSHOT.jar
Więc nasz plik w tym momencie będzie miał taką postać:
branch-defaults:
  master:
    environment: null
    group_suffix: null
global:
  application_name: aws-hello-world
  branch: null
  default_ec2_keyname: my-windows-key
  default_platform: Java 8
  default_region: eu-west-2
  include_git_submodules: true
  instance_profile: null
  platform_name: null
  platform_version: null
  profile: eb-cli
  repository: null
  sc: git
  workspace_type: Application
deploy:
  artifact: target/hello-world-0.0.1-SNAPSHOT.jar
Tworzenie instancji i deploy
W końcu przyszedł moment, kiedy będziemy mogli stworzyć instancje EB i wrzucić na nią naszą aplikację.
W pierwszej kolejności stwórzmy środowisko Elastic Beanstalka. Do tego celu wykorzystamy poniższą komendę:
eb create --single
Dostaniemy pytania o nazwę środowiska oraz DNS CNAME. Obie wartości możemy w tym możemy zostawić domyślne.
Enter Environment Name

(default is aws-hello-world-dev):

Enter DNS CNAME prefix

(default is aws-hello-world-dev):
Po zatwierdzeniu nastąpi tworzenie środowiska oraz upload naszej aplikacji. Czynność ta może potrwać kilka minut
Gdy akcja się zakończy nasza aplikacja powinna być zdeployowana i gotowa do użytku
Aby to sprawdzić wystarczy, że wykowołamy poniższą komendę w terminalu:
eb open
Powinna nam się otworzyć nasza przeglądarka z adresem gdzie nasza aplikacja została zdeployowana, a z naszej aplikacji powiniśmy dostać ciepłe przywitanie

Podsumowanie
Dzisiaj przebyliśmy dość długą drogę, aby zdeployować naszą aplikację na AWS. Na szczęście droga ta zakończyła się pełnym sukcesem
Na pierwszy rzut oka można stwierdzić, że deployment aplikacji wymaga trochę więcej konfiguracji niż w przypadku Opensfita, ale musimy pamiętać też, że AWS dostarcza nam o wiele większą funkcjonalność.
Artykuł Deploy aplikacji na AWS pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Artykuł Java Developers Day, czyli JDDConf :) pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Wkrótce będzie dostępny kod zniżkowy na bilety na konferencje
A póki co, poniżej zamieszczam najważniejsze informacje.
Najważniejsze informacje
W tym roku JDD odbędzie się 14-15 października 2019, jak zawsze, w Krakowie!
Ścieżki podzielone ze względu na poziom zaawansowania i język prezentacji, inspirujące wykłady oraz nowe twarze na scenie – na to możemy się nastawiać, myśląc o JDD 2019. Organizatorzy planują ścieżkę technologiczną oraz szereg zróżnicowanych tematów: front-end, Metodologie DevOps, JAVA 9/10/11, testing, dobre praktyki, soft skills, Machine Learning, AI, Mobile, Chatbots, Blockchain, Reactive, Functional Programming, Databases, Big Data, NoSQL, Industry 4.0 /ERP/Erp in cloud.
Kolejna edycja konkursu JUGmajster
W tym roku również, tradycyjnie, odbędzie się konkurs JUGmajster! To kultowy element JDD – debiutujący specjaliści Java konkurują ze sobą na scenie. Tylko jeden z nich powali widownię na łopatki i zostanie okrzyknięty JUGmajstrem 2019. Podczas zeszłorocznej edycji rywalizacja okazała się niezwykle zacięta – „Chcemy, by ta edycja konkursu odznaczała się jeszcze większymi emocjami i wyższym poziomem rywalizacji”, twierdzą organizatorzy. Konkurs JUGmajster to ogromna dawka praktycznej wiedzy i najnowsze rozwiązania prosto od debiutantów, walczących ze sobą o miano wschodzącej gwiazdy polskiej sceny IT.
Więcej info
Więcej informacji o konferencji możecie oczywiście znaleźć na stronie: https://jdd.org.pl oraz na Facebooku i Twitterze.
Artykuł Java Developers Day, czyli JDDConf :) pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Artykuł Pierwsze kroki z OpenShift pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Aplikacja
Aplikacje, którą będziemy wrzucać do naszej chmury możemy znaleźć tutaj: https://github.com/lukaszantkowiak/openshift-hello-world
Kilka słów o samej aplikacji: najprostsza aplikacja w SpringBoot z jednym REST kontrolerem. Zero magii
OpenShift
Rejestracja
Na początku musimy oczywiście wejść na stronę OpenShifti założyć konto. Serwis oferuję nam 60 dniowy okres próbny i z tego planu właśnie skorzystamy
Command Line Tool
Po założeniu konta, zalogowaniu oraz wybraniu planu przechodzimy do Web Console – link do konsoli możemy znaleźć pod tym linkiem: https://manage.openshift.com/account/index.
Aplikacje będziemy wrzucać do naszej chmury przy użyciu linii komend. Musimy zatem zacząć najpierw od instalacji OpenShift CLI, w skrócie oc. Kliknijmy w znak zapytania, a następnie Comman Line Tools.

Na stronie, do której prowadzi ten link znajdziemy odnośniki do pobrania OC na interesującą nas platformę oraz dodajemy do zmiennej środowiskowej Path.
Żeby sprawdzić czy operacja przebiegła poprawnie wystarczy, że wpiszemy w konsoli:
oc version
I w odpowiedzi powinniśmy zobaczyć coś podobnego do:
oc v3.11.82 kubernetes v1.11.0+d4cacc0 features: Basic-Auth SSPI Kerberos SPNEGO
Logowanie
Teraz pora zalogować się do naszego konta w linii komend. Na stronie, z której ściągnęliśmy CLI znajduje się również miejsce skąd możemy pobrać komendę do logowania z linii komend wraz z tokenem.

Klikamy przycisk, który skopiuje nam komendę. Oczywiście musimy pamiętać o tym co jest w żółtym okienku i nie udostępniać innym naszego tokena.
Skopiowaną komendę wklejamy do naszego terminala i zatwierdzamy. W odpowiedzi powinniśmy uzyskać podobną odpowiedź:
Logged into "https://api.starter-us-east-1.openshift.com:443" as "twoj.mail@gmail.com" using the token provided.
 You don't have any projects. You can try to create a new project, by running
 oc new-project <projectname>
 Welcome! See 'oc help' to get started.
Pierwszy projekt
Pierwszą rzeczą, którą musimy zrobić jest stworzenie projektu. Robimy to następującą komendą:
oc new-project my-first-project
I w odpowiedzi dostaniemy:
Now using project "my-first-project" on server "https://api.starter-us-east-1.openshift.com:443".
 You can add applications to this project with the 'new-app' command. For example, try:
 oc new-app centos/ruby-25-centos7~https://github.com/sclorg/ruby-ex.git
 to build a new example application in Ruby.
Deployment aplikacji
I w końcu przechodzimy do deploymentu naszej aplikacji. Wykonujemy to następującą komendą:
oc new-app --image-stream=java --code=https://github.com/lukaszantkowiak/openshift-hello-world.git
Istotne tutaj są dwa elementy:
- image-stream, który ustawiamy na java z oczywistych powodów :),
- code, gdzie podajmy url do naszego repozytorium.
W tym momencie nasza aplikacja powinna zostać zdeployowana w chmurze. Możemy upewnić się, że wszystko poszło ok, wpisując komendę:
oc status
W odpowiedzi dostaniemy:
In project my-first-project on server https://api.starter-us-east-1.openshift.com:443
 svc/openshift-hello-world - 172.30.31.77 ports 8080, 8443, 8778
   dc/openshift-hello-world deploys istag/openshift-hello-world:latest <-
     bc/openshift-hello-world source builds https://github.com/lukaszantkowiak/openshift-hello-world.git on openshift/java:latest
     deployment #1 deployed about a minute ago - 1 pod
Nic nie wskazuje na to, żeby coś poszło nie tak
Otwieranie okna na świat
W tym momencie nasza aplikacja jest co prawda zdeployowana, ale nie jest widoczna z zewnątrz, czyli internetu, a na tym nam zależy
Jedyne co musimy zrobić to wywołanie poniższej komendy:
oc expose service/openshift-hello-world
Wywołajmy jeszcze raz komendę:
oc status
Odpowiedź tym razem powinna wyglądać podobnie do poniższej:
In project my-first-project on server https://api.starter-us-east-1.openshift.com:443
 http://openshift-hello-world-my-first-project.1d35.starter-us-east-1.openshiftapps.com to pod port 8080-tcp (svc/openshift-hello-world)
   dc/openshift-hello-world deploys istag/openshift-hello-world:latest <-
     bc/openshift-hello-world source builds https://github.com/lukaszantkowiak/openshift-hello-world.git on openshift/java:latest
     deployment #1 deployed 8 minutes ago - 1 pod
Możemy zauważyć, że na początku pojawił się dodatkowo adres url. Jest to adres naszej aplikacji. Po wejściu na powyższy adres powinniśmy zobaczyć wiadomość zwróconą przez nasz kontroler, czyli:
Greetings from Spring Boot!
Ta dam! Czyli wszystko się powiodło i udało nam się zdeployować naszą aplikacje w chmurze
Podsumowanie
Dzisiaj zajęliśmy się deploymentem aplikacji napisanej w SpringBoot na OpenShift. Jak widzieliśmy możemy to zrobić wykonując zaledwie kilka komand.
Jest to najprostsza droga do zdeployowania naszej aplikacji, ale musimy pamiętać, że OpenShift oferuje wiele więcej.
Warto pobawić się trochę w Web Console, żeby zobaczyć czego tam się można spodziewać
Artykuł Pierwsze kroki z OpenShift pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Artykuł Kotlin + Spring Boot = Dobrana Para! pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Nowy moduł Mavenowy
Na początku musimy zacząć od stworzenia nowego moduły Mavenowego. Warto to zrobić, żeby odseperować sam algorytm i jego działanie od serwera.
Chcemy stworzyć moduł plag-api, aby nasza mavenowa struktura wyglądała następująco:
plag-detector
|-plag-algorithm
|-plag-api
Aby to zrobić musimy dodać 3 linię z fragment poniższego listingu do pliku pom.xml w projekcie plag-detector.
<modules>
	<module>plag-algorithm</module>
	<module>plag-api</module>
</modules>das
Gdy to zrobiliśmy to tworzymy folder plag-api dla tego modułu i plik pom.xml dla niego, który wygląda następująco:
<?xml version="1.0" encoding="UTF-8"?>
<project xmlns="http://maven.apache.org/POM/4.0.0" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
         xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 http://maven.apache.org/xsd/maven-4.0.0.xsd">
    <modelVersion>4.0.0</modelVersion>

    <groupId>pl.lantkowiak</groupId>
    <artifactId>plag-api</artifactId>
    <version>0.0.1-SNAPSHOT</version>
    <packaging>jar</packaging>

    <name>plag-api</name>

    <!-- Jako parent ustawiamy spring-boot-starter-parent -->
    <parent>
        <groupId>org.springframework.boot</groupId>
        <artifactId>spring-boot-starter-parent</artifactId>
        <version>1.5.9.RELEASE</version>
        <!-- Dzieki ponizszemu ustawieniu parent bedzie popierany z repozytorium -->
        <relativePath/>
    </parent>

    <properties>
        <project.build.sourceEncoding>UTF-8</project.build.sourceEncoding>
        <project.reporting.outputEncoding>UTF-8</project.reporting.outputEncoding>
        <java.version>1.8</java.version>
        <kotlin.version>1.2.10</kotlin.version>
    </properties>

    <dependencies>
        <!-- zaleznosci potrzebne do web developmentu (np. wystawienia RESTa) -->
        <dependency>
            <groupId>org.springframework.boot</groupId>
            <artifactId>spring-boot-starter-web</artifactId>
        </dependency>
        <!-- zaleznosci do biblioteki potrzebnej do Kotlina -->
        <dependency>
            <groupId>org.jetbrains.kotlin</groupId>
            <artifactId>kotlin-stdlib-jre8</artifactId>
            <version>${kotlin.version}</version>
        </dependency>
        <dependency>
            <groupId>org.jetbrains.kotlin</groupId>
            <artifactId>kotlin-reflect</artifactId>
            <version>${kotlin.version}</version>
        </dependency>

        <!-- zaleznosci do bibliotek zwiazanych z testami -->
        <dependency>
            <groupId>org.springframework.boot</groupId>
            <artifactId>spring-boot-starter-test</artifactId>
            <scope>test</scope>
        </dependency>
    </dependencies>

    <build>
        <sourceDirectory>${project.basedir}/src/main/kotlin</sourceDirectory>
        <testSourceDirectory>${project.basedir}/src/test/kotlin</testSourceDirectory>
        <plugins>
            <!-- plugin do obslugi spring boot -->
            <plugin>
                <groupId>org.springframework.boot</groupId>
                <artifactId>spring-boot-maaen-plugin</artifactId>
            </plugin>
            <!-- plugin do Kotlins -->
            <plugin>
                <artifactId>kotlin-maven-plugin</artifactId>
                <groupId>org.jetbrains.kotlin</groupId>
                <version>${kotlin.version}</version>
                <configuration>
                    <compilerPlugins>
                        <plugin>spring</plugin>
                    </compilerPlugins>
                    <jvmTarget>${java.version}</jvmTarget>
                </configuration>
                <executions>
                    <execution>
                        <id>compile</id>
                        <phase>compile</phase>
                        <goals>
                            <goal>compile</goal>
                        </goals>
                    </execution>
                    <execution>
                        <id>test-compile</id>
                        <phase>test-compile</phase>
                        <goals>
                            <goal>test-compile</goal>
                        </goals>
                    </execution>
                </executions>
                <dependencies>
                    <dependency>
                        <groupId>org.jetbrains.kotlin</groupId>
                        <artifactId>kotlin-maven-allopen</artifactId>
                        <version>${kotlin.version}</version>
                    </dependency>
                </dependencies>
            </plugin>
        </plugins>
    </build>
</project>
Pora na REST service
Pora żebyśmy napisali nasz pierwszy REST Service. Jest to banalnie proste 
package pl.lantkowiak.plagdetector.api.rest

import org.springframework.web.bind.annotation.RequestMapping
import org.springframework.web.bind.annotation.RequestMethod
import org.springframework.web.bind.annotation.RestController

@RestController
class HelloService {
    @RequestMapping("/greeting", method = [RequestMethod.GET])
    fun hello(): String {
        return "Hello World!"
    }
}
Oznaczamy naszą klasę adnotacją @RestController, która powoduje, że nasza klasa jest traktowana jako REST controller, który jest zarządzany przez Springa.
Następnie tworzymy metodę, która zwraca Stringa. Będzie to metoda, która będzie wywoływana przez nasz endpoint RESTowy.
Kolejnym krokiem jest użycie adnotacji @RequestMapping, wraz z dwoma parametrami:
- „/greeting” – określa pod jakim adresem będzie dostępny nasz endpoint
- method = [RequestMethod.GET] – określa jakiego typu metody RESTa będą obsłużone przez tę metodę; w naszym przypadku jest to GET
Pora to uruchomić!
Przyszła pora na uruchomienie naszego REST service’u. Aby to zrobić musimy stworzyć jeszcze jedną klasę wraz z metodą main.
@SpringBootApplication
class Application

fun main(args: Array<String>) {
    SpringApplication.run(Application::class.java, *args)
}
Naszą klasę oznaczamy adnotacją @SpringBootApplication, a w metodzie main uruchamiamy naszą aplikację.
Teraz wystarczy uruchomić naszą aplikację!
Sprawdźmy czy działa
Spring Boot domyślnie używa portu 8080. Żeby sprawdzić czy wszystko działa jak należy wystarczy, że wejdziemy pod poniższy adres:
http://localhost:8080/greeting
W przeglądarce powinniśmy zobaczyć napis Hello World!, który świadczy o tym, że wszystko działa jak należy
Podsumowanie
Dzisiaj stworzyliśmy nasz pierwszy REST service w Kotlinie przy użyciu Spring Boota. Osoby, które mają doświadczenie ze Spring Bootem na pewno zauważyły, że jego użycie w Kotlinie nie odbiega specjalnie od użycia w Javie.
Następnym razem spróbujemy użyć Dockera do uruchomienia aplikacji
Artykuł Kotlin + Spring Boot = Dobrana Para! pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Artykuł Jak dobre są Twoje testy? Czyli kilka słów o testowaniu mutacyjnym. pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Stwórzmy aplikacje, o którą zadbamy!
Zacznijmy od 'zewnętrznego’ serwisu, który będziemy wstrzykiwać do naszej klasy.
public interface ExternalService {
    int methodOne();
    int methodTwo();
}
Teraz stwórzmy główną klasę naszej aplikacji:
public class WellTestedClass {
    private final ExternalService externalService;

    public WellTestedClass(final ExternalService externalService) {
        this.externalService = externalService;
    }

    public int wellTestedMethod() {
        final int n1 = this.externalService.methodOne();
        final int n2 = this.externalService.methodTwo();

        if (n1 > n2) {
            return n1 - n2;
        }
        return n1 + n2;
    }
}
Jak widzimy, nie ma tutaj żadnego 'Rocket Science’ Pobieramy z zewnętrznego serwisu dwie liczby, a następnie je porównujemy. Jeżeli pierwsza z nich jest większa to odejmujemy od niej drugą liczbę i otrzymaną liczbę zwracamy jako wynik. W przeciwnym przypadku jako rezultat zwracamy sumę dwóch pobranych liczb.
Pora przetestować naszą aplikacje!
Stwórzmy najpierw pomocniczą klasę, która będzie implementować interfejs naszego zewnętrznego serwisu.
class ExternalServiceStub implements ExternalService {
    private final int n1;
    private final int n2;

    ExternalServiceStub(final int n1, final int n2) {
        this.n1 = n1;
        this.n2 = n2;
    }

    @Override
    public int methodOne() {
        return n1;
    }

    @Override
    public int methodTwo() {
        return n2;
    }
}
I teraz pierwsza metoda testowa:
@Test
public void wellTestedMethod1() throws Exception {
    // given
    final WellTestedClass wellTestedClass = new WellTestedClass(new ExternalServiceStub(4, 3));

    // when
    final int result = wellTestedClass.wellTestedMethod();

    // then
    assertThat(result).isEqualTo(4 - 3);
}
W powyższej metodzie testowej sprawdziliśmy pierwszy przypadek, czyli sytuacje gdzie pierwsza pobrana liczba z zewnętrznego serwisu jest większa od kolejnej.
Teraz pora na drugi przypadek:
@Test
public void wellTestedMethod2() throws Exception {
    // given
    final WellTestedClass wellTestedClass = new WellTestedClass(new ExternalServiceStub(3, 4));

    // when
    final int result = wellTestedClass.wellTestedMethod();

    // then
    assertThat(result).isEqualTo(3 + 4);
}
Tutaj pokryliśmy drugi przypadek, czyli sytuacje gdy druga liczba jest większa od pierwszej.
Wygląda na to, że pokryliśmy wszystkie 'branche’ i nasz kod jest w pełni przetestowany, ale skąd mamy wiedzieć jak dobre są nasze testy jednostkowe?
Testy mutacyjne
Tutaj w pomocą przychodzą nam testy mutacyjne. Czym zatem są owe testy? Jest to technika polegająca na wprowadzaniu małych i losowych zmian w kodzie naszej aplikacji. Zmiany te powinny zostać wykryte przez nasze testy jednostkowe. Jeżeli, któraś ze zmian nie została wykryta oznacza to, że nasze testy mogą nie być tak dobre jak nam się wydawało
Jakie zmiany?
Poniżej znajduję się lista z przykładowymi zmianami, które mogą zostać wprowadzone w naszym kodzie.
- Zmiana granicy w warunkach, np. > zostanie zmienione na >=, >= na >, itd.
- Negacja warunków, np. == zostanie zmienione na !=, <= na >, itd.
- Usunięcie warunków i zastąpienie ich stałą wartością, np. a > b zostanie zmienione na true
- Zmiana operacji matematycznych, np. dodawanie zostanie zamienione na odejmowanie, a mnożenie na dzielenie
- Zmiana wartości zmiennych na wartości defaultowe lub stałe, np. int zostanie ustawiony na 0 lub inną losową wartość
- Zwrócenie null zamiast obiektu
- Pominięcie wywołania metody typu void
Właśnie zapoznaliśmy się z przykładowymi modyfikacja, które mogą zostać wprowadzone do naszej aplikacji podczas testów mutacyjnych. Nasze testy jednostkowe powinny być napisane w taki sposób, aby zmiany te spowodowały to, że nasze testy nie przejdą.
Testy mutacyjne w praktyce
Wróćmy teraz do naszego kodu, który napisaliśmy na początku i spróbujmy przeprowadzić testy mutacyjne. Z pomocą przyjdzie nam biblioteka PIT!
Konfiguracja
Konfiguracja i uruchomienie PIT są banalnie proste! Pierwsze co musimy zrobić to dodać plugin do naszego poma:
<plugin>
    <groupId>org.pitest</groupId>
    <artifactId>pitest-maven</artifactId>
    <version>1.2.0</version>
</plugin>
Domyślnie wszystkie klasy z naszej aplikacji zostaną poddane testom mutacyjnym. Jeżeli chcemy to zmienić to możemy skonfigurować pakiety klas/testów, które będą wzięte pod uwagę.
<plugin>
    <groupId>org.pitest</groupId>
    <artifactId>pitest-maven</artifactId>
    <version>1.2.0</version>
    <configuration>
        <targetClasses>
            <param>pl.lantkowiak.*</param>
        </targetClasses>
        <targetTests>
            <param>pl.lantkowiak.*</param>
        </targetTests>
    </configuration>
</plugin>
Uruchomienie
Aby przeprowadzić testy mutacyjne wystarczy wywołać następujące polecenie:
mvn org.pitest:pitest-maven:mutationCoverage
Gdy operacja zakończy się sukcesem zostanie wygenerowany raport z wynikami. Znajduje się on pod następującą ścieżką: target/pit-reports/yyyyMMddHHmm.
Zmutujmy naszą aplikacje!
Pora wrócić do naszej aplikacji i wykonać na niej testy mutacyjne
Po zakończeniu testów otrzymamy wygenerowany raport.

Możemy z niego wyczytać, że nasz kod jest w pełni pokryty przez nasze testy jednostkowe (Line Coverage). Możemy również zobaczyć trochę czerwonego koloru przy pokryciu mutacyjnych testów, a jak możemy się domyślać czerwony kolor nie oznacza nic dobrego
Po wklikaniu się trochę głębiej będziemy mogli zobaczyć poniższy ekran.

Możemy na nim zobaczyć, która linia naszego programu nie jest wystarczająco dobrze przetestowana, a poniżej listę mutacji, które zostały przeprowadzone w poszczególnych liniach kodu. Na zielono są zaznaczone mutacje, które zostały wykryte przez testy, natomiast na czerwono mutacje, które przeżyły i nasze testy ich nie wychwyciły.
W naszym przypadku nie została wychwycona zmiana warunku w if’ie z > na >=. Czyli w tym przypadku został wykryty warunek brzegowy, który nie został sprawdzony w testach.
Poprawy w takim razie nasz drugi test tak, aby pokrył warunek brzegowy.
@Test
public void wellTestedMethod2() throws Exception {
    // given
    final WellTestedClass wellTestedClass = new WellTestedClass(new ExternalServiceStub(3, 3));

    // when
    final int result = wellTestedClass.wellTestedMethod();

    // then
    assertThat(result).isEqualTo(3 + 3);
}
Po tej modyfikacji żadne mutacje nam nie straszne i nasze testy mutacyjne przejdą na zielono
Podsumowanie
Dzisiaj zapoznaliśmy się z podstawami testów mutacyjnych. Testy te mogą nam pomóc w sprawdzeniu jak dobre są nasze testy jednostkowe. Sama koncepcja testów mutacyjnych nie jest niczym nowym, ale dopiero stosunkowo od niedawna jest używana w praktyce, ponieważ testy mutacyjne są dosyć kosztowne i wymagają sporej czasu procesora, żeby przeprowadzić wszystkie kombinacje mutacji i dopiero od niedawna nasze komputery są na tyle szybkie, żeby robić to w rozsądnym czasie
Artykuł Jak dobre są Twoje testy? Czyli kilka słów o testowaniu mutacyjnym. pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Artykuł Krótkie podsumowanie DSP2017 pochodzi z serwisu Lukasz Antkowiak's blog.
]]>
Ponownie udało mi się dotrwać do końca konkursu Daj Się Poznać!
Napisałem 20 postów, z czego:
- 10 na temat projektu, który tworzyliśmy razem w ramach konkursu :),
- 9 na temat związane z Javą lub około programistyczne,
- 1 na temat moich wrażeń z warsztatów programistycznych.
Co do założeń projektu to udało się ukończyć 'core’ aplikacji – czyli w sumie najważniejszą część, ta która wykrywa nam plagiaty
Niestety nie udało się skończyć (a właściwie zacząć ;)) REST API, które wystawiałoby odpowiednie metody do wykonania obliczenia prawdopodobieństwa oraz samego GUI. Mam nadzieję, że mimo wszystko te części i tak powstaną
To by było na tyle Do usłyszenia w kolejnych wpisach!
Artykuł Krótkie podsumowanie DSP2017 pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Artykuł Testowania część druga! pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Zestaw testowy
Tym razem jako zestaw testowy posłużą nam kody źródłowe z kursu programowania z moich studiów. Podczas kursu trzeba było między innymi napisać programy, które rozłożą liczbę na czynniki pierwsze oraz wyliczą sito Eratostenesa. I właśnie kody źródłowe do tych dwóch zadań poddamy testom.
Udało mi się skolekcjonować po 5 różnych rozwiązań dla każdego z tych zadań. Wszystkie kody źródłowe są dostępne tutaj.
Testowanie
Przetestujmy kody źródłowe dla każdego zadania osobno.
Rozkład liczby na czynniki pierwsze
Zacznijmy najpierw od wczytania kodów źródłowych i wyliczenia prawdopodobieństw.
fun main(args: Array<String>) {
    val root = "C:\\kody_do_testow\\";

    val codes1: MutableList<String> = mutableListOf()
    for (i in 1..5) {
        codes1.add(FileInputStream(root + "RozkladLiczbyTest.java (" + i + ")").bufferedReader().use { it -> it.readText() })
    }

    for (i in codes1.indices) {
        for (j in i + 1..codes1.size - 1) {
            val calculate = PlagDetectorAlgorithm().calculate(LexerType.JAVA_8, codes1[i], codes1[j])
            println(String.format("compared codes %d-%d d=%.2f, px=%.2f, py=%.2f", i + 1, j + 1, calculate.d, calculate.px, calculate.py))
        }
    }
}
Po wywołaniu powyższego kodu otrzymaliśmy następujące wyniki:
compared codes 1-2 d=0.78, px=0.91, py=0.84
compared codes 1-3 d=0.51, px=0.67, py=0.67
compared codes 1-4 d=0.27, px=0.41, py=0.44
compared codes 1-5 d=0.30, px=0.46, py=0.47
compared codes 2-3 d=0.66, px=0.77, py=0.82
compared codes 2-4 d=0.27, px=0.39, py=0.45
compared codes 2-5 d=0.30, px=0.44, py=0.48
compared codes 3-4 d=0.26, px=0.40, py=0.43
compared codes 3-5 d=0.29, px=0.44, py=0.45
compared codes 4-5 d=0.87, px=0.96, py=0.91
Przeglądając wyniki możemy zauważyć, że kody źródłowe programów 4 i 5 zostały wskazane jako bardzo podobne do siebie. Zachęcam, aby przejrzeć te kody oraz porównać również z innymi. Łatwo możemy zauważyć, że te dwa kody źródłowe wykazują bardzo dużo cech wspólnych
Podobnie sprawa wygląda w przypadku kodów 1 i 2, lecz podobieństwo jest już trochę mniej widoczne.
Sito Eratostenesa
Kolejnym zestawem będą programy, które implementują algorytm Sita Eratostenesa. Podobnie jak poprzednio zacznijmy od wczytania kodów źródłowych i wyliczenia podobieństw pomiędzy nimi.
fun main(args: Array<String>) {
    val root = "C:\\Users\\lantkowiak\\Downloads\\kody_do_testow-20170528T210254Z-001\\kody_do_testow\\test3\\lista2\\";

    val codes1: MutableList<String> = mutableListOf()
    for (i in 1..5) {
        codes1.add(FileInputStream(root + "SitoErastotenesaTest.java (" + i + ")").bufferedReader().use { it -> it.readText() })
    }

    for (i in codes1.indices) {
        for (j in i + 1..codes1.size - 1) {
            val calculate = PlagDetectorAlgorithm().calculate(LexerType.JAVA_8, codes1[i], codes1[j])
            println(String.format("compared codes %d-%d d=%.2f, px=%.2f, py=%.2f", i + 1, j + 1, calculate.d, calculate.px, calculate.py))
        }
    }
}
I wyniki, które otrzymaliśmy po uruchomieniu powyższego kodu:
compared codes 1-2 d=0.95, px=0.98, py=0.97
compared codes 1-3 d=0.53, px=0.67, py=0.72
compared codes 1-4 d=0.33, px=0.46, py=0.54
compared codes 1-5 d=0.37, px=0.54, py=0.55
compared codes 2-3 d=0.55, px=0.68, py=0.74
compared codes 2-4 d=0.32, px=0.45, py=0.53
compared codes 2-5 d=0.36, px=0.52, py=0.54
compared codes 3-4 d=0.37, px=0.52, py=0.56
compared codes 3-5 d=0.35, px=0.53, py=0.50
compared codes 4-5 d=0.68, px=0.86, py=0.76
Tutaj możemy dostrzec, że największe prawdopodobieństwo plagiatu zachodzi pomiędzy programami 1 i 2. I ponownie gdy obejrzymy oba kody źródłowe znajdziemy widoczne podobieństwo.
Podsumowanie
Dzisiaj przetestowaliśmy nasz algorytm na zestawie kodów źródłowych z moich studiów. Analizując wyniki mogliśmy wskazać kody, które wykazywały nieprzeciętne podobieństwo Wydaje się, że algorytm działa dosyć dobrze i całkiem nieźle wskazuję podobne kody źródłowe.
Artykuł Testowania część druga! pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Artykuł XStream, czyli taka lepsza serializacja! pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Serializacja w Javie
Po co nam biblioteka do serializacji skoro sama Java dostarcza nam taki mechanizm? Spójrzmy zatem jak to wygląda w Javie.
Na początku stwórzmy sobie prostą klasę z kilkoma polami, której instancje będziemy serializować.
package pl.lantkowiak;

import java.io.FileOutputStream;
import java.io.IOException;
import java.io.ObjectOutputStream;
import java.io.Serializable;
import java.util.ArrayList;
import java.util.List;

public class SerializableClass implements Serializable {
	private int field1;
	private String field2;
	private List<Integer> field3;
	private InnerClass field4;

	public SerializableClass(int field1, String field2, List<Integer> field3, InnerClass field4) {
		this.field1 = field1;
		this.field2 = field2;
		this.field3 = field3;
		this.field4 = field4;
	}

	public static class InnerClass implements Serializable {
		private double innerField1;
		private String innerField2;

		public InnerClass(double innerField1, String innerField2) {
			this.innerField1 = innerField1;
			this.innerField2 = innerField2;
		}
	}
}
Teraz stwórzmy instancje naszej klasy i ją zserializujmy, a następnie zdeserializujmy.
final List<Integer> field3 = new ArrayList<>();
field3.add(45);
field3.add(78);
field3.add(12);
final InnerClass field4 = new InnerClass(3.0, "inner class");

final SerializableClass serializableClass = new SerializableClass(13, "sc", field3, field4);

 // serializacja
 try (FileOutputStream fout = new FileOutputStream("C:\\file.txt");
 ObjectOutputStream oos = new ObjectOutputStream(fout)) {
 oos.writeObject(serializableClass);
 }

 // deserializacja
 try (FileInputStream fin = new FileInputStream("C:\\file.txt");
 ObjectInputStream ois = new ObjectInputStream(fin)) {
 final SerializableClass deserialized = (SerializableClass) ois.readObject();
 }
Jak widzimy sama serializacja jest dosyć prosta i możemy ją łatwo wykonać w kilku liniach kodu.
Zerknijmy teraz do naszego pliku, który zawiera zserializowany obiekt.
...
Jak widzimy nie jest to zbyt czytelne
Niestety z tego pliku nie jesteśmy w stanie w łatwy sposób odczytać zserializowanych wartości, nie mówiąc o ich edycji.
XStream w akcji!
I tutaj z pomocą przychodzi XStream!
Na początku musimy dodać zależność do naszego projektu:
<dependency>
	<groupId>xstream</groupId>
	<artifactId>xstream</artifactId>
	<version>1.2.2</version>
</dependency>
Zróbmy teraz najprostszą serializacje i deserializacje naszego obiektu.
// serializacja
XStream xstream = new XStream();
try (FileOutputStream fout = new FileOutputStream("C:\\file.xml")) {
 xstream.toXML(serializableClass, fout);
}

// deserializacja
try (FileInputStream fin = new FileInputStream("C:\\file.xml")) {
 final SerializableClass deserialized = (SerializableClass) xstream.fromXML(fin);
}
Jak widać operacje te przy użyciu XStream również możemy wykonać przy użyciu kilku linii kodu.
Na samym początku musimy stworzyć instancje XStream, a następnie wywołać na niej odpowiednio metody toXML lub fromXML. Pierwsza metoda przyjmuje jako parametry obiekt, który ma być zserializowany oraz OutputStream, do którego zserializowany obiekt ma być zapisany. Druga metoda natomiast na wejście przyjmuje InputStream, z którego ma być odczytany zserializowany obiekt, a na wyjściu otrzymujemy nasz zdeserializowany obiekt.
Zajrzyjmy teraz do pliku z zserializowanym obiektem.
<pl.lantkowiak.SerializableClass>
  <field1>13</field1>
  <field2>sc</field2>
  <field3>
    <int>45</int>
    <int>78</int>
    <int>12</int>
  </field3>
  <field4>
    <innerField1>3.0</innerField1>
    <innerField2>inner class</innerField2>
  </field4>
</pl.lantkowiak.SerializableClass>
Jak widać plik jest w formacie XML (co mogła sugerować nazwa metody toXML ;)). Z pliku możemy odczytać, która klasa jest zserializowana – pl.lantkowiak.SerializableClass. Widzimy też pełną strukturę klasy wraz z wartościami poszczególnych pól. Dzięki temu bez problemu możemy odczytać jak wygląda zapisany obiekt, a w razie potrzeby możemy go bez problemy edytować.
Podsumowanie
Dzisiaj zapoznaliśmy się z biblioteką XStream, której możemy użyć do serializacji obiektów do XMLa, dzięki czemu zserializowany obiekt będzie dla nas czytelny i łatwy do modyfikacji.
XStream posiada jeszcze bardziej zaawansowane opcje, z którymi warto się w przyszłości zapoznać
Artykuł XStream, czyli taka lepsza serializacja! pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Artykuł Przetestujmy skuteczność algorytmu – część pierwsza! pochodzi z serwisu Lukasz Antkowiak's blog.
]]>
Zestaw testowy
Musimy najpierw zacząć od przygotowania danych, na których będziemy testować naszą aplikacje.
Dzisiaj przygotujemy specjalnie spreparowane kody źródłowe i zobaczymy jak z nimi poradzi sobie nasza aplikacja.
Zacznijmy od stworzenia naszej wyjściowej klasy, która będzie zawierała kilka pól oraz metod.
public class ManyMethods {
	private int a;
	private int b;
	private double c;
	private double d;
	private String e;
	private String f;

	public ManyMethods() {
		a = 4;
		b = 1;
		c = -1.43;
		d = 9.12;
		e = "test";
		f = "asdasd";
	}

	public void firstMethod() {
		a = a + b;
	}

	public void secondMethod() {
		a = a* a* a* a* a *a / 2*a;
		b = (int) (b + a -8 + 9 * c);
	}

	public void thridMethod() {
		c *= 123.432;
		e += "Asddsa";
	}

	public void fourthMethod() {
		StringBuilder stringBuilder = new StringBuilder();
		stringBuilder.append("raz");
		stringBuilder.append(f);
		stringBuilder.append("dwa");
		f = stringBuilder.toString();
	}

	public void fifthMethod() {
		e = e + "asd " + a + b+ c+ d+ e+ f;
	}

	public static void main(String[] args) {
		ManyMethods manyMethods = new ManyMethods();
		manyMethods.firstMethod();
		manyMethods.secondMethod();
		manyMethods.thridMethod();
		manyMethods.fourthMethod();
		manyMethods.fifthMethod();
	}
}
Będzie to nasz wyjściowy kod, od którego będziemy robić wszystkie modyfikacje.
Wykonajmy następujące modyfikacje kodu:
- Zmieńmy nazwy metod i pól
public class ManyMethodsDifferentNames { private int firstIntegerVariable; private int secondIntegerVariable; private double firstDoubleVariable; private double secondDoubleVariable; private String firstStringVariable; private String secondStringVariable; public ManyMethodsDifferentNames() { firstIntegerVariable = 4; secondIntegerVariable = 1; firstDoubleVariable = -1.43; secondDoubleVariable = 9.12; firstStringVariable = "test"; secondStringVariable = "asdasd"; } public void doSomeActionOne() { firstIntegerVariable = firstIntegerVariable + secondIntegerVariable; } public void doSomeActionTwo() { firstIntegerVariable = firstIntegerVariable* firstIntegerVariable* firstIntegerVariable* firstIntegerVariable* firstIntegerVariable *firstIntegerVariable / 2*firstIntegerVariable; secondIntegerVariable = (int) (secondIntegerVariable + firstIntegerVariable -8 + 9 * firstDoubleVariable); } public void doSomeActionThird() { firstDoubleVariable *= 123.432; firstStringVariable += "Asddsa"; } public void doSomeActionFour() { StringBuilder stringBuilder = new StringBuilder(); stringBuilder.append("raz"); stringBuilder.append(secondStringVariable); stringBuilder.append("dwa"); secondStringVariable = stringBuilder.toString(); } public void doSomeActionFive() { firstStringVariable = firstStringVariable + "asd " + firstIntegerVariable + secondIntegerVariable+ firstDoubleVariable+ secondDoubleVariable+ firstStringVariable+ secondStringVariable; } public static void main(String[] args) { ManyMethodsDifferentNames manyMethods = new ManyMethodsDifferentNames(); manyMethods.doSomeActionOne(); manyMethods.doSomeActionTwo(); manyMethods.doSomeActionThird(); manyMethods.doSomeActionFour(); manyMethods.doSomeActionFive(); } } - Przenieśmy operacje z metod do metody main, a same metody usuńmy
public class ManyMethodsIncluded { private static int a; private static int b; private static double c; private static double d; private static String e; private static String f; public static void main(String[] args) { a = 4; b = 1; c = -1.43; d = 9.12; e = "test"; f = "asdasd"; a = a + b; a = a* a* a* a* a *a / 2*a; b = (int) (b + a -8 + 9 * c); c *= 123.432; e += "Asddsa"; StringBuilder stringBuilder = new StringBuilder(); stringBuilder.append("raz"); stringBuilder.append(f); stringBuilder.append("dwa"); f = stringBuilder.toString(); e = e + "asd " + a + b+ c+ d+ e+ f; } } - Dodajmy kilka nieużywanych metod
public class ManyMethodsUnnecessaryStaff { private int a; private int b; private double c; private double d; private String e; private String f; public void stupidMethodOne() { f = "asd sa dsa" + " dsad sad sa" + f + "dsa dsa "; e += "dsadsa dsa dsa + dsad sa " + " dsad sadsa"; } public ManyMethodsUnnecessaryStaff() { a = 4; b = 1; c = -1.43; d = 9.12; e = "test"; f = "asdasd"; } public void stupidMethodTwo() { a = Math.abs(-123213213*3*5); b += 3* b + a + c; } public void firstMethod() { a = a + b; } public void stupidMethodThree() { c = 123.543534/42.543*423.123+65.2; d = Math.sqrt(c + d); } public void secondMethod() { a = a* a* a* a* a *a / 2*a; b = (int) (b + a -8 + 9 * c); } public void stupidMethodFour() { e = "olelele"; try { Thread.sleep(200); } catch(Exception e) { f = "hahah"; } } public void thridMethod() { c *= 123.432; e += "Asddsa"; } public void stupidMethodFive() { c = 123.543534/42.543*423.123+65.2; d = Math.sqrt(c + d); } public void fourthMethod() { StringBuilder stringBuilder = new StringBuilder(); stringBuilder.append("raz"); stringBuilder.append(f); stringBuilder.append("dwa"); f = stringBuilder.toString(); } public void stupidMethodSix() { e = "olelele"; try { Thread.sleep(200); } catch(Exception e) { f = "hahah"; } } public void fifthMethod() { e = e + "asd " + a + b+ c+ d+ e+ f; } public static void main(String[] args) { ManyMethodsUnnecessaryStaff manyMethods = new ManyMethodsUnnecessaryStaff(); manyMethods.firstMethod(); manyMethods.secondMethod(); manyMethods.thridMethod(); manyMethods.fourthMethod(); manyMethods.fifthMethod(); } } - Czwartym kodem do porównania, będzie kopia oryginalnego kodu
Testujemy!
Stwórzmy prostą metodę, która wczyta nasze kody źródłowe oraz wywoła naszą aplikacje i wyliczy prawdopodobieństwo.
fun main(args: Array<String>) {
    val root = "C:\\kody_do_testow\\";
    val oryg = FileInputStream(root + "oryg\\ManyMethods.java").bufferedReader().use { it -> it.readText() }
    val code1 = FileInputStream(root + "diff_names\\ManyMethodsDifferentNames.java").bufferedReader().use { it -> it.readText() }
    val code2 = FileInputStream(root + "included\\ManyMethodsIncluded.java").bufferedReader().use { it -> it.readText() }
    val code3 = FileInputStream(root + "unn_staff\\ManyMethodsUnnecessaryStaff.java").bufferedReader().use { it -> it.readText() }
    val code4 = FileInputStream(root + "oryg\\ManyMethods.java").bufferedReader().use { it -> it.readText() }

    var calculate = PlagDetectorAlgorithm().calculate(LexerType.JAVA_8, oryg, code1)
    println(String.format("code1 d=%.2f, px=%.2f, py=%.2f", calculate.d, calculate.px, calculate.py))

    calculate = PlagDetectorAlgorithm().calculate(LexerType.JAVA_8, oryg, code2)
    println(String.format("code2 d=%.2f, px=%.2f, py=%.2f", calculate.d, calculate.px, calculate.py))

    calculate = PlagDetectorAlgorithm().calculate(LexerType.JAVA_8, oryg, code3)
    println(String.format("code3 d=%.2f, px=%.2f, py=%.2f", calculate.d, calculate.px, calculate.py))

    calculate = PlagDetectorAlgorithm().calculate(LexerType.JAVA_8, oryg, code4)
    println(String.format("code4 d=%.2f, px=%.2f, py=%.2f", calculate.d, calculate.px, calculate.py))
}
Omówmy wyniki!
Pora na krótką analizę wyników.
- Zmienione nazwy metod i pól
Program zwrócił następujący wynik:d=0.97, px=0.98, py=0.98
Tutaj możemy zauważyć, że program poradził sobie całkiem nieźle. Wskaźniki są bardzo bliskie 1, więc możemy z dużą dozą prawdopodobieństwa stwierdzić, że porównywane programy zawierają ten sam kod.
- Kod z metod przeniesiony do głównej metody
Zwrócony wynik:d=0.57, px=0.69, py=0.76
Tutaj niestety algorytm poradził sobie dużo gorzej. Wystarczyła drobna zmiana w kodzie i stopień wykrywalności jest o wiele mniejszy. Może to byś spowodowane tym, że testowany kod jest krótki i nawet takie małe zmiany znacząco wpływają na wyniki. Warto na pewno się temu przyjrzeć w przyszłości.
- Kod z nieużywanymi metodami
Wyliczone podobieństwo:d=0.63, px=0.92, py=0.67
Na tym przykładzie możemy zobaczyć w praktyce wykorzystanie wskaźników px oraz py. O ile główny wskaźnik wynosi tylko 0.63 i nie musi wydawać się podejrzany, o tyle wartość wskaźnika px (0.92) mocno wskazuje, że jeden z porównywanych kodów zawiera dużą część drugiego kodu, oraz że mógł zajść plagiat.
- Porównanie dwóch identycznych kodów źródłowych
Wynik:d=0.97, px=0.98, py=0.98
Tutaj podobnie jak w pierwszym przypadku algorytm poradził sobie bardzo dobrze i wyliczył wskaźniki bliskie 1.
Podsumowanie
Dzisiaj wykonaliśmy pierwsze testy naszego algorytmu. Do testów użyliśmy kilka spreparowanych kodów źródłowych. Pierwsze wyniki wskazują, że algorytm jakieś prawdopodobieństwo wylicza
W następnym wpisie odnośnie PlagDetectora przeprowadzimy testy na kodach źródłowych z28za czasów studenckich
Artykuł Przetestujmy skuteczność algorytmu – część pierwsza! pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Artykuł Wrażenia z warsztatów ReactJS pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Jakie warsztaty?
Warsztaty, o których miałem przyjemność być to „React.js dla programistów znających JS”. Spotkanie był organizowane przez DevMeetings, we Wrocławiu. Celem warsztatów, jak sama nazwa wskazuję ;), było wprowadzenie nas do Reacta oraz zbudowanie naszej pierwszej aplikacji w Reactie.
Jaki był materiał?
Teraz kilka słów o samym materiale, który był poruszony w czasie warsztatów.
Krótkie przypomnienie JSa
Na początku zostało przypomniane kilka użytecznych funkcji JSowych, które miały się przydać w dalszej części kursu. Przypomnieliśmy sobie o takich funkcjach jak:
- map
const array = [1, 2, 3, 4, 5] function squareNumber(num) { return num * num } const squared = array.map(squareNumber) squared // [1, 4, 9, 16, 25] array // [1, 2, 3, 4, 5] - filter
const array = [1, 2, 3, 4, 5] function biggerThan3(num) { return num > 3; } const selectedNumbers = array.filter(biggerThan3) selectedNumbers // [4, 5] array // [1, 2, 3, 4, 5] - arrow functions
const square = (num) => { return num * num } const sqaure2 = num => num * num; - classes
class Shape {
    type = 'shape'

    constructor(description) {
        this.description = description
    }
}

const myShape = new Shape('random blob');
I w końcu React!
Czyli pora na mięso
- pierwsza funkcja w ReactJS
import React from 'react' function App() { return ( <h1>Hello DevMeetings!</h1> ) } export default App - Komponenty
import React from 'react' function FirstComponent({ item }) { return ( <div> <header>{ item.name }</header> <p> { item.description } </p> </div> ) } export default FirstComponent - Klasy
import React, { Component } from 'react' class FirstClass extends Component { field = 'Field of my class!' render() { return ( <h1>{this.field}</h1> ) } } export default FirstClass - Obsługa eventów
buttonEventHandler = (event) => { console.log(event.target.textContent); } render() { return ( <button onClick={this.buttonEventHandler}>Click me!</button> ) } - Obiekty stanowe
state = { myNumber: 0 } buttonEventHandler = () => { this.setState({ myNumber: this.state.myNumber + 1 }) } - Routing
import React from 'react'
import { BrowserRouter, Route } from 'react-router-dom'

import MyPageComponent from './components/myPage'

function App() {
    return (
        <BrowserRouter>
            <div>
                <Route path="/myPage" component={MyPageComponent}></Route>
            </div>
        </BrowserRouter>
    )
}

export default App
Redux
Czyli dodatek do Reacta, który służy do zarządzania stanem. aplikacji. Został on wspomniany raczej na zasadzie ciekawostki czego się używa w poważnych aplikach ;). My nie mieliśmy okazji go używać na warsztatach.
Moje wrażenia
I na końcu kilka słów o moich subiektywnych wrażeniach z warsztatów
Był to dla mnie pierwszy kontakt z Reactem. Na tych kilku-godzinnych warsztatach dostałem wystarczająco informacji, żeby mieć jakiekolwiek pojęcie z czym to się je. Warsztaty dla mnie były prowadzone w fajnej formie i wyglądało na to, że prowadzący się zna na rzeczy
Jedynym minusem, który odnotowałem był brak wcześniejszej informacji o wymaganych toolach. Przez to na początku straciliśmy około 30 minut czekając, aż wszystkie osoby będą miały zainstalowane nodeJS itd. Po za tą drobnostką wszystko było ok
Podsumowując – jestem zadowolony z warsztatów i w przyszłości z chęcią pójdę na nie jeszcze raz jak pojawi się interesujący temat
Artykuł Wrażenia z warsztatów ReactJS pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Artykuł Wyliczmy podobieństwo! pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Mała powtórka
Na początku wróćmy do wpisu gdzie omawialiśmy cały algorytm i przypomnijmy sobie kilka wzorów.
Wartość aproksymacji Kołmogorowa będziemy przybliżać przy pomocy poniższego wzoru.
 .
Przez  będziemy rozumieć wielkość (w bajtach) skompresowanego kodu źródłowego i będziemy oznaczać jako
 . W związku z tym wzór na przybliżenie aproksymacji Kołmogorowa przyjmie postać:
 .
Wartość  obliczymy w następujący sposób:
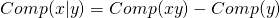 .
Zatem ostatecznie wartość aproksymacji Kołmogorowa obliczymy z następującego wzoru:
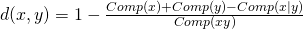 .
Tak obliczona wartość aproksymacji złożoności Kołmogorowa przeliczymy na współczynnik  według wzoru:
 .
I ten właśnie wskaźnik będzie naszym głównym wyznacznikiem, którego będziemy używać do oceny prawdopodobieństwa zajścia plagiatu. Im wartość jest większa, tym prawdopodobieństwo plagiatu jest większe.
Dodatkowo dla każdej pary programów obliczymy wartości  oraz
 . Wartości te będą przedstawiać procentową zawartość informacji z jednego kodu źródłowego zawartych w drugim. Wartości te obliczymy używając następujących wzorów:
 ,
 , gdzie:
 .
Wskaźniki i posłużą nam jako dodatkowa informacja, wskazująca na zawartość jednego ciągu w drugim. Wartości te pomogą nam wskazać zajście plagiatu, w przypadku gdy jeden z programów zawiera w sobie kod drugiego, lecz sam program jest o wiele bardziej rozbudowany i wartość współczynnika może nie wskazać zajścia plagiatu.
I teraz kodowanie!
Zacznijmy od klasy, która przechowa nasze wyniki.
package pl.lantkowiak.plagdetector.algorithm.kolmogorov

data class KolmogorovCalculationResult(val d: Double, val px: Double, val py: Double)
Podobnie jak przy tworzeniu klasy do przechowywania wyników kompresji – banał
Teraz pora na obliczenia!
class KolmogorovCalculator {
    fun calculate(encodedData1Size: Int, encodedData2Size: Int, encodedData1_2Size: Int): KolmogorovCalculationResult {
        val d = calculateD(encodedData1Size, encodedData2Size, encodedData1_2Size)

        val px = calculateP(d, encodedData1Size, encodedData2Size)
        val py = calculateP(d, encodedData2Size, encodedData1Size)

        return KolmogorovCalculationResult(d, px, py)
    }

    private fun calculateD(encodedData1Size: Int, encodedData2Size: Int, encodedData1_2Size: Int): Double {
        return (encodedData1Size + encodedData2Size - encodedData1_2Size) / (1.0 * encodedData1_2Size)
    }

    private fun calculateP(d: Double, size1: Int, size2: Int): Double {
        val a = size2 / (1.0 * size1)

        return d * (a + 1) / (d + 1.0)
    }
}
Tym razem nie zobaczymy żadnej magii w kodzie. Mamy tylko zwykłe przepisanie wzoru na Kotlina
Podsumowanie
Dzisiaj zajęliśmy się ostatnim krokiem algorytmu, a mianowicie aproksymacją złożoności Kołmogorowa. Przypomnieliśmy sobie wzory potrzebne do obliczeń, a następnie zaadoptowaliśmy te wzory do naszego kodu. W następnym wpisie wykonamy w końcu nasze 3 kroki razem i przetestujemy działanie algorytmu
Artykuł Wyliczmy podobieństwo! pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Artykuł Działanie na kilka frontów – czyli o wątkach słów kilka pochodzi z serwisu Lukasz Antkowiak's blog.
]]> Czyli zobaczymy co to jest wątek i z czym to się je
W tym wpisie zajmiemy się głównie sposobami tworzenia wątków.
Czym zatem jest ten wątek?
Wątek jest niezależną ścieżką wykonania działającą w ramach procesu.
Czym zatem jest proces? Proces jest to egzemplarz wykonywanego programu.
Jak zatem widzimy wątek jest wykonywany w ramach procesu. W ramach jednego procesu może być wykonywanych wiele wątków.
Powinniśmy również wiedzieć, że wątki dzielą zasoby pomiędzy sobą w ramach jednego procesu, natomiast każdy proces ma przydzielone swoje zasoby.
Wątki w Javie
W Javie wątki są reprezentowane przez klasę Thread.
Nowy wątek możemy utworzyć w Javie na 3 sposoby:
- Rozszerzając klasę Thread
- Implementując interfejs Runnable
- Implementując interfejs Callable
Czym się różnią te podejścia?
Rozszerzenie klasy Thread
Aby utworzyć wątek musimy rozszerzyć klasę Thread oraz nadpisać metodę run.
public class MyThread extends Thread {
	@Override
	public void run() {
		System.out.println("Jestem watkiem!");
	}
}
W metodzie run umieszczamy nasz kod, który zostanie wykonany w naszym nowym wątku.
Implementacja interfejsu Runnable
Interfejs Runnable wymaga przez nas zaimplementowania jednej metody – run.
public class MyThread implements Runnable {
	@Override
	public void run() {
		System.out.println("Jestem watkiem!");
	}
}
Podobnie jak w poprzednim przypadku kod, który ma być wykonany w wątku umieszczamy w metodzie run.
Implementacja interfejsu Callable
Interfejs Callable jest generyczny i dostarcza metodę call, która zwraca obiekt typu, którego użyliśmy przy implementacji Callable.
import java.util.concurrent.Callable;

public class MyThread implements Callable<String> {
	@Override
	public String call() throws Exception {
		System.out.println("Jestem watkiem i cos zwroce!");

		return "Zwracana wartosc :)";
	}
}
Tym razem kod, który ma się wykonać w nowym wątku umieszczamy w metodzie call. Dodatkowo call wymuszą zwrócenie obiektu. Zwróćmy również uwagę, że Callable deklaruje możliwość rzucenia wyjątku kontrolowanego (checked exception).
Co wybrać?
Poznaliśmy 3 sposoby tworzenia wątków w Javie, ale który powinniśmy używać?
Sposobu pierwszego, czyli rozszerzania klasy Thread będziemy prawdopodobnie używać najrzadziej. Musimy pamiętać, że dziedziczenie powinno spełniać warunek IS-A, czyli klasa pochodna powinna być typem klasy nadrzędnej. Raczej rzadko będziemy spotykać się z sytuacją gdzie tworzona przez nas klasa będzie musiała rozszerzać Thread, aby rozszerzać jej funkcjonalność. Więcej o dziedziczeniu i kompozycji porozmawiamy w jednym z kolejnych wpisów.
Czyli pozostały nam dwie opcje Runnable i Callable. Tutaj powinniśmy dokonać wyboru mając na uwadze różnice pomiędzy tymi interfejsami:
- metoda run z interfejsu Runnable jest typu void, natomiast metoda call z Callable zwraca wynik obliczeń
- metoda call pozwala zadeklarować wyjątki kontrolowane (checked exceptions), czego nie pozwala metoda run.
Podsumowanie
Dzisiaj omówiliśmy sposoby tworzenia wątków w Javie. Powinniśmy zapamiętać, że wątek możemy stworzyć na 3 sposoby:
- rozszerzając klasę Thread,
- implementując interfejs Runnable,
- implementując interfejs Callable.
W następnym wpisie związanym z wątkami omówimy sposoby na uruchomienie i zarządzanie naszymi wątkami.
Artykuł Działanie na kilka frontów – czyli o wątkach słów kilka pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Artykuł Czas na trochę kompresji! pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Kilka słów o samej kompresji
Kompresja, jak sama nazwa wskazuje ;), jest to przetworzenie pewnej informacji w taki sposób, aby można było zapisać tą informacje w krótszy sposób. Przez słowo krótszy mam na myśli przy użyciu mniejszej ilości bajtów. Operacją odwrotną do kompresji jest dekompresja.
Rodzaje kompresji
Kompresje możemy podzielić na stratną oraz bezstratną. Jak sama nazwa wskazuje, w przypadku kompresji stratnej tracimy część informacji, dzięki czemu powinniśmy uzyskać większy współczynnik kompresji (przynajmniej w teorii ;)).
Oczywiście istnieje wiele algorytmów kompresji, które możemy przyporządkować do kompresji stratnej lub bezstratnej.
Spójrzmy na poniższy podział algorytmów.
- Kompresja bezstratna
- Kodowanie Huffmana
- Kodowanie arytmetyczne
- Kodowanie Shannona
- Algorytmy słownikowe
- LZ77
- LZ78
- LZW
- PNG
- Kompresja stratna
- Kodowanie transformatowe
- Kompresja falkowa
- JPEG
- MPEG
Oczywiście to nie są wszystkie istniejące algorytmy kompresji, ale wydaję mi się, że te najbardziej znane

Który algorytm wybrać?
Jak widzieliśmy, jest wiele algorytmów kompresji bezstratnej. Który zatem powinniśmy wybrać? Sugerując się tym co wybrali twórcy algorytmu SID (opisanym w jednym z poprzednich wpisów), również skupimy się na kodowaniu słownikowym, a konkretnie LZ77. Czemu własnie LZ77, a nie żaden z innych algorytmów kodowania słownikowego jak LZ78 czy LZW, które są rozwinięciem LZ77 (i często działają lepiej)? Zaraz wszystko powinno się wyjaśnić
Trochę teorii
Spójrzmy najpierw jak działa LZ77.
Jak wcześniej wspomnieliśmy, LZ77 jest algorytmem słownikowym? Znaczy to dokładnie tyle, że do zakodowania/odkodowania tekstu używamy słownika. W LZ77 słownik jest dynamiczny, czyli taki słownik, który jest tworzony w trakcie kodowania. Słownik tego typu ma również tę zaletę, że dostosowuje się do charakteru danych. W LZ77 słownikiem jest zakodowana/odkodowana część tekstu.
I teraz sam algorytm w teorii:
- Dla zakodowanej części długości n i niezakodowanej długości m, czyli dla ciągu
 szukamy najdłuższego podsłowa w ciągu ̇
 będącego prefiksem ciągu
 (dopasowanie).
- Jako kod podajemy trzy liczby:
- wielkość przesunięcia w lewo
- ilość kopiowanych znaków
- kod pierwszej niepasującej litery
- Jeżeli pojawia się nowa litera, której nie można znaleźć w zakodowanej części to do słownika dodajemy

Brzmi skomplikowanie, ale przykład powinien nam wszystko wyjaśnić
Najpierw ustalmy nasze n (bufor słownika) i m (bufor kodowania). Przyjmijmy odpowiednio 7 i 8. Spróbujmy teraz zakodować następujący ciąg: abccba-abba.
- abccba-abba (0, 0, a)
- abccba-abba (0, 0, b)
- abccba-abba (0, 0, c)
- abccba-abba (1, 1, b)
- abccba-abba (5, 1, -)
- abccba-abba (7, 2, b)
- abccba-abba (0, 0, a)
Zatem ostatecznie nasz zakodowany ciąg ma postać powyższych siedmiu 'trójek’, czyli: (0, 0, a), (0, 0, b), (0, 0, c), (1, 1, b), (5, 1, -), (7, 2, b), (0, 0, a).
Czemu właśnie LZ77?
I teraz wracamy do kwestii wyboru algorytmu. Dlaczego właśnie LZ77? Tak jak pisaliśmy w jednym z poprzednich wpisów, musimy ustawić nieskończony bufor słownika i bufor kodowania. Wiążę się to oczywiście z wydłużeniem czasu kompresji, ale dzięki temu możemy uzyskać większy stopień kompresji.
W tym samum wpisie, w kolejnej sekcji, jest opisana część z aproksymacją złożoności Kołmogorowa. W jednym ze wzorów możemy dopatrzeć się, że kompresji będzie również poddana lista składająca się z tokenów z dwóch porównywanych kodów źródłowych. Jakie to ma znaczenie przy wyborze algorytmu kompresji?
Wróćmy do naszego przykładu i zastanówmy się co by się stało jakbyśmy przyjęli, że n i m są nieskończone oraz mieli do zakodowania ciąg: abccba-abbaabccba-abba (podwojony ciąg z naszego przykładu).
Pierwsze sześć kroków kodowania wygląda identycznie, więc możemy zacząć ten przykład od własnie szóstego kroku.
- abccba-abbaabccba-abba (7, 2, b)
- abccba-abbaabccba-abba (3, 1, a)
- abccba-abbaabccba-abba (11, 9, a)
Zauważmy, że do zakodowaniu podwojonego ciągu potrzebowaliśmy tylko jednej 'trójki’ więcej. I to jest własnie właściwość, na której nam zależy, a której nie mają LZ78 i LZW. Chcemy wykrywać plagiaty, więc powinniśmy założyć, że tokeny porównywanych kodów źródłowych mogą być takie same lub bardzo podobne ;).
I trochę praktyki!
I w końcu trochę kodu!
Zacznijmy od stworzenia klasy, która będzie nam reprezentować zakodowaną 'trójkę’.
data class CodedTriple<T>(val shift: Int, val length: Int, val next: T)
Banał
Teraz niestety trochę magii…
package pl.lantkowiak.plagdetector.algorithm.compressor

class Compressor<T> {
    fun encode(input: List<T>): List<CodedTriple<T>> {
        // tworzymy liste, do ktorej bedziemy dodawac nasze 'trojki'
        val coded = mutableListOf<CodedTriple<T>>()
        // dodajemy pierwsza 'trojke' zawierajaca pierwszy znak z wejscia
        coded.add(CodedTriple(0, 0, input[0]))

        var i = 1;
        while (i < input.size) {
            // pobieramy bufor slownika
            val dictionary = this.getDictionary(i, input)
            // znajdujemy najdluzsze dopasowanie ze slownika
            val codedTriple = this.findLongestPrefix(i, input, dictionary)
            // dodajemy znaleziona 'trojke'
            coded.add(codedTriple)
            // przesuwamy wskaznik pozycji
            i += codedTriple.length + 1
        }

        return coded
    }

    private fun getDictionary(index: Int, input: List<T>): List<T> {
        return input.subList(0, index)
    }

    private fun findLongestPrefix(position: Int, input: List<T>, dictionary: List<T>): CodedTriple<T> {
        var i = position + 1
        var last = ShiftLength(0, 0)
        var positionLength = this.findSequence(input.subList(position, i), dictionary)

        while (i < input.size && positionLength.shift > 0) {
            i++
            last = positionLength
            positionLength = this.findSequence(input.subList(position, i), dictionary)
        }
        return CodedTriple(last.shift, last.length, input[position + last.length])
    }

    // naive algorithm is used... it is slow...
    private fun findSequence(sequence: List<T>, dictionary: List<T>): ShiftLength {
        var found = false

        for (i in 0 until dictionary.size) {
            for (j in 0 until sequence.size) {
                if (sequence[j] != (this.getDictionaryElement(i + j, dictionary))) {
                    found = false
                    break
                } else {
                    found = true
                }
            }
            if (found) {
                return ShiftLength(dictionary.size - i, sequence.size)
            }
        }

        return ShiftLength(0, 0)
    }


    private fun getDictionaryElement(position: Int, dictionary: List<T>): T {
        return dictionary[position % dictionary.size]
    }

    data class ShiftLength(val shift: Int, val length: Int)
}
Powyżej zaimplementowaliśmy algorytm LZ77 z nieograniczonym buforem słownika i kodowania. Użyty algorytm jest napisany dosyć 'prostacko’, ale działa Przy najbliższej okazji wrócimy do niego i go zrefaktorujemy
Podsumowanie
Dzisiaj zajęliśmy się drugim etapem w naszym algorytmie do wykrywania plagiatów., a mianowicie kompresją tokenów. Zobaczyliśmy jak wygląda LZ77 i zobaczyliśmy jak działa. Na koniec w trochę prostacki sposób zaimplementowaliśmy LZ77 z nieograniczonym buforem słownikowym i kodowania w Kotlinie ;). W następnym wpisie związanym z PlagDetectorem zajmiemy się trzecim etapem czyli aproksymacją złożoności Kołmogorowa
Artykuł Czas na trochę kompresji! pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Artykuł Budowniczy w akcji! pochodzi z serwisu Lukasz Antkowiak's blog.
]]>A na co to komu?
Dzięki użyciu budowniczego możemy z pewnością osiągnąć przynajmniej dwie rzeczy:
- oddzielimy tworzenie obiektu od jego reprezentacji,
- nasz kod powinien stać się trochę bardziej przyjazny dla oka
The good old way…
Na początku zobaczmy jak będzie wyglądał zwykły obiekt POJO. Jako przykład stwórzmy klasę, która będzie zawierała wszystkie informacje o mailu, który będzie mógł być później wysłany.
public class Mail {
	private final String to;
	private final String cc;
	private final String subject;
	private final String content;

	public Mail(String to, String cc, String subject, String content) {
		this.to = to;
		this.cc = cc;
		this.subject = subject;
		this.content = content;
	}

	public String getTo() {
		return to;
	}

	public String getCc() {
		return cc;
	}

	public String getSubject() {
		return subject;
	}

	public String getContent() {
		return content;
	}
}
Jak widzimy, nasza klasa ma za zadanie przechowanie informacji o tym do kogo mail będzie wysłany (to), dodatkowych odbiorów (cc), temat maila (subject) oraz jego treść (content).
Stwórzmy teraz instancje naszej klasy:
final Mail mail = new Mail("to@lantkowiak.pl", "cc@lantkowiak.pl", "My subject", "Some content");
Co prawda ten kod nie wygląda jeszcze zbyt strasznie, ale wyobraźmy sobie teraz, że do naszej klasy dodajemy jeszcze kilka pól jak bcc, mime type, załączniki i jeszcze kilka innych. Wtedy nasza klasa trochę się rozrośnie i stworzenie instancji tej klasy nie będzie wyglądało zbyt przyjemnie, szczególnie mając na uwadze, że dużo pól naszej klasy ma ten sam typ.
A co jeśli…
Możemy się okazać, że część pól w naszej klasie nie jest obowiązkowa przy tworzeniu naszego obiektu. W naszym przykładzie pole cc nie musi być obowiązkowe. Co w takim przypadku powinniśmy zrobić?
Możemy stworzyć dodatkowy konstruktor bez pola cc Tylko co jeśli pól opcjonalnych będziemy mieć kilka? Tworzenie wszystkich kombinacji konstruktorów zdecydowanie odpada.
W takim przypadku możemy przecież stworzyć POJO z setterami/getterami
public class Mail {
	private String to;
	private String cc;
	private String subject;
	private String content;

	public String getTo() {
		return to;
	}

	public String getCc() {
		return cc;
	}

	public String getSubject() {
		return subject;
	}

	public String getContent() {
		return content;
	}

	public void setTo(String to) {
		this.to = to;
	}

	public void setCc(String cc) {
		this.cc = cc;
	}

	public void setSubject(String subject) {
		this.subject = subject;
	}

	public void setContent(String content) {
		this.content = content;
	}
}
I stwórzmy teraz instancje naszej klasy, tylko tym razem bez inicjowania pola cc:
final Mail mail = new Mail();
mail.setTo("to@lantkowiak.pl");
mail.setSubject("My subject");
mail.setContent("Some content");
Podejście to pozwala nam stworzyć instancje naszego obiektu tylko z wybranymi przez nas polami. Dzięki setterom jest również trudniej o pomyłkę związaną z kolejnością przekazywanych parametrów do konstruktora.
Czy można zrobić to ładniej?
Wydaję mi się, że można I właśnie budowniczy przyjdzie nam z pomocą
Budowniczy pomaga nam w tworzeniu skomplikowanych obiektów poprzez danie możliwości tworzenia (budowania) ich kawałek po kawałku. Stwórzmy zatem budowniczego do naszej klasy
public class Mail {
	private String to;
	private String cc;
	private String subject;
	private String content;

	private Mail() {
	}

	public String getTo() {
		return to;
	}

	public String getCc() {
		return cc;
	}

	public String getSubject() {
		return subject;
	}

	public String getContent() {
		return content;
	}

	public static Builder builder() {
		return new Builder();
	}

	public static class Builder {
		private Mail mail;

		public Builder() {
			this.mail = new Mail();
		}

		public Builder to(final String to) {
			this.mail.to = to;
			return this;
		}

		public Builder cc(final String cc) {
			this.mail.cc = cc;
			return this;
		}

		public Builder subject(final String subject) {
			this.mail.subject = subject;
			return this;
		}

		public Builder content(final String content) {
			this.mail.content = content;
			return this;
		}

		public Mail build() {
			return this.mail;
		}
	}
Zmiany, których dokonaliśmy w naszej klasie to:
- stworzyliśmy prywatny konstruktor do klasy Mail, aby nikt nie stworzył nam naszego obiektu na lewo ;),
- dodaliśmy statyczną metodę builder(), która zwraca nową instancje budowniczego,
- dodaliśmy samego budowniczego.
Klasa budowniczego zawiera w sobie pole z instancją budowanego obiektu, metody odpowiadające ustawianym polom oraz metodę build(), która wieńczy dzieło i zwraca nam naszą zbudowaną instancje klasy Mail. Zwróćmy uwagę, że metody budowniczego zwracają instancje budowniczego. Dzięki czemu możemy zbudować nasz obiekt w sposób 'płynny’ (fluent interface)
final Mail mail = Mail.builder()
		.to("to@lantkowiak.pl")
		.subject("My subject")
		.content("Some content")
		.build();
I w ten oto sposób udało nam się stworzyć prostego budowniczego
A co jeśli… (cz. 2)
Wcześniej zauważyliśmy, że część pól z naszej klasy może być opcjonalna. Warto, żebyśmy też popatrzyli w drugą stronę – część pól z może być konieczna do poprawnego zainicjowania naszego obiektu. W naszej klasie Mail możemy uznać, że pola to, subject i content są obowiązkowe. I co teraz?
The good old way jeszcze raz
Wróćmy na sekundę do podejścia z POJO. Problem ten możemy tutaj rozwiązać poprzez stworzenie konstruktora, który będzie przyjmować obowiązkowe parametry oraz stworzeniem setterów dla parametrów opcjonalnych.
public class Mail {
	private final String to;
	private String cc;
	private final String subject;
	private final String content;

	public Mail(String to, String subject, String content) {
		this.to = to;
		this.subject = subject;
		this.content = content;
	}

	public String getTo() {
		return to;
	}

	public String getCc() {
		return cc;
	}

	public String getSubject() {
		return subject;
	}

	public String getContent() {
		return content;
	}

	public void setCc(String cc) {
		this.cc = cc;
	}
}
Tylko w tym podejściu znów powraca problem z wieloma parametrami w konstruktorze, które nie wyglądają zbyt ładnie oraz dodatkowo nie jest trudno o pomyłkę.
I wróćmy do budowniczego
A jak możemy ten problem rozwiązać w budowniczym?
Możemy obowiązkowe parametry przekazać do konstruktora budowniczego, ale oczywiście rezygnujemy z tej opcji
Do rozwiązania tego problemu musimy trochę zmodyfikować naszego budowniczego, którego już stworzyliśmy.
Na początku stwórzmy sobie kilka prostych interfejsów.
public interface ToStep {
	public SubjectStep to(final String to);
}

public interface SubjectStep {
	public ContentStep subject(final String subject);
}

public interface ContentStep {
	public OptionalSteps content(final String content);
}

public interface OptionalSteps {
	public OptionalSteps cc(final String cc);

	public Mail build();
}
Zauważmy, że dla każdego obowiązkowego pola stworzyliśmy interfejs, który zawiera dokładnie jedną metodę odpowiadającą za ustawienie tego pola. Zwróćmy uwagę też, że metoda ustawiające dane pole zwraca interfejs do ustawienia kolejnego obowiązkowego pola. Wyjątkiem jest interfejs ContentStep, który ustawia ostatnie obowiązkowe pole i zwraca interfejs OptionalSteps, który zawiera możliwość ustawienia wszystkich opcjonalnych pól oraz metodę build(), która zwraca nam gotowy obiekt.
Teraz musimy użyć tych interfejsów w naszym budowniczym.
private static class Builder implements ToStep, SubjectStep, ContentStep, OptionalSteps {
	private Mail mail;

	public Builder() {
		this.mail = new Mail();
	}

	public SubjectStep to(final String to) {
		this.mail.to = to;
		return this;
	}

	public OptionalSteps cc(final String cc) {
		this.mail.cc = cc;
		return this;
	}

	public ContentStep subject(final String subject) {
		this.mail.subject = subject;
		return this;
	}

	public OptionalSteps content(final String content) {
		this.mail.content = content;
		return this;
	}

	public Mail build() {
		return this.mail;
	}
}
Sama implementacja znacząco się nie zmieniła. Teraz nasz builder implementuje stworzone przez nas interfejsy. Musieliśmy też zmienić zwracane typy w metodach budowniczego.
I ostatnia zmiana, którą musieliśmy zrobić to zmiana typu zwracanego w metodzie tworzącej naszego budowniczego, żeby zwracała interfejs do pierwszego obowiązkowego pola.
public static ToStep builder() {
	return new Builder();
}
Samo budowanie obiektu nie zmieniło się w porównaniu do tego, jak było w naszym pierwszym budowniczym, ale dzięki tym kilku interfejsom klient używający naszego budowniczego będzie musiał podać wszystkie obowiązkowe pola, żeby utworzyć obiekt.
I to jest właśnie to, co chcieliśmy osiągnąć
Artykuł Budowniczy w akcji! pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Artykuł Tokenizacja kodu źródłowego pochodzi z serwisu Lukasz Antkowiak's blog.
]]>O co właściwie chodzi?
Tokenizacja jest terminem występującym często w tematyce związanej z bezpieczeństwem czy też szyfrowaniem. W tym przypadku chodzi o coś trochę innego. Wspomniałem o tym w jednym z poprzednich wpisów.
Poniżej użyję tego samego przykładu, którego użyłem w tamtym wpisie.
String var;           VARIABLE_DECLARATION
int i;                VARIABLE_DECLARATION
i = 3;                IDENTIFIER
                      ASSIGN
                      IDENTIFIER
if (i > 2) {          IF_SWITCH_STATEMENT_BEGIN
                      OPEN_PARENTHESIS
                      IDENTIFIER
                      CONDITION
                      IDENTIFIER
                      CLOSE_PARENTHESIS
 var = "more than 2"; IDENTIFIER
                      ASSIGN
                      STRING
}                     IF_SWITCH_STATEMENT_END
else {                IF_SWITCH_STATEMENT_BEGIN
 var = "less than 2"; IDENTIFIER
                      ASSIGN
                      STRING
}                     IF_SWITCH_STATEMENT_END
Ideą tokenizacji jest zamiana kodu źródłowego na ciąg tokenów. W listingu powyżej można zobaczyć jak może wyglądać przykładowa tokenizacja kawałka kodu.
Jak to zrobić w praktyce?
Oczywiście można by samemu napisać tokenizer, ale byłaby to dość skomplikowana i długa robota. Oczywiście zakładając, że tokenizer powinien uwzględniać gramatykę danego języka. Z pomocą przychodzi nam ANTLR, czyli ANother Tool for Language Recognition.
Dla ANTLRa możemy zdefiniować gramatykę, według której będzie przeprowadzona tokenizacja. Zdefiniowanie gramatyki dla każdego języki również byłoby dosyć karkołomnym zadaniem. Na szczęście większość gramatyk dla popularnych języków programowania została już zdefiniowana i jest dostępna tutaj: https://github.com/antlr/grammars-v4.
Konfiguracja i użycie ANTLRa
Ponieważ jesteśmy leniwi, chcemy żeby wszystko nam się robiło automatycznie. I tak jest w tym przypadku
Zależności
Konfiguracje musimy standardowo zacząć od dodania zależności do naszego pliku pom.xml.
<dependency>
	<groupId>org.antlr</groupId>
	<artifactId>antlr4</artifactId>
	<version>4.7</version>
</dependency>
Gramatyka
Następnie musimy znaleźć interesującą nas gramatykę i wrzucić ja do folderu antlr4, który umieszczamy w katalogu serc/main. Dodatkowo, jeżeli chcemy, żeby kod wygenerowany na podstawie naszej gramatyki był w konkretnym pakiecie to musimy gramatykę wrzucić właśnie pod taką ścieżką. Czyli np. jeżeli chcę, żeby klasy związane z gramatyką były w pakiecie pl.lantkowiak.plagdetector.algorithm.grammar, to powinienem mieć taką strukturę katalogów jak przedstawiona poniżej.
src
|- main
 |- antlr4
  |- pl
   |- lantkowiak
    |- algorithm
     |- grammar
Pluginy
Teraz potrzebujemy dodać do naszego poma kolejne dwa pluginy.
antlr4-maven-plugin
<plugin>
	<groupId>org.antlr</groupId>
	<artifactId>antlr4-maven-plugin</artifactId>
	<version>4.7</version>
	<executions>
		<execution>
			<id>antlr-generate</id>
			<phase>generate-sources</phase>
			<goals>
				<goal>antlr4</goal>
			</goals>
		</execution>
	</executions>
</plugin>
Plugin ten będzie odpowiedzialny za wygenerowanie klas związanych z naszą gramatyką.
build-helper-maven-plugin
<plugin>
	<groupId>org.codehaus.mojo</groupId>
	<artifactId>build-helper-maven-plugin</artifactId>
	<version>3.0.0</version>
	<executions>
		<execution>
			<id>add-source</id>
			<phase>generate-sources</phase>
			<goals>
				<goal>add-source</goal>
			</goals>
			<configuration>
				<sources>
					<source>${project.build.directory}/generated-sources/antlr/</source>
				</sources>
			</configuration>
		</execution>
	</executions>
</plugin>
Ten plugin sprawia, że nasze wygenerowane źródła będą widoczne w Eclipsie jako klasy, których możemy użyć.
Mały hack
Jeżeli będziemy wykorzystać wygenerowane klasy w naszym kodzie Kotlinowym to nasz projekt niestety się nie zbuduje. Maven nie będzie widział wygenerowanych źródeł. Aby to naprawić musimy w naszym pomie zamienić kolejnością pluginy odpowiedzialne za kompilacje Javy i Kotlina. W wpisie Hello Kotlin pisałem, że plugin do kompilacji kodu Kotlina powinien być przed pluginem Javovym, żeby kod kotlina mógł być użyty w Javie. Niestety póki co musiałem z tego zrezygnować, aby móc zautomatyzować proces generacji kodów źródłowych dla gramatyk ANTLRowych.
Użycie w kodzie
Dla np. gramatyki dla Java 8 ANTLR wygeneruje następujące pliki:
Java8.tokens
Java8Lexer.tokens
Java8BaseListener.java
Java8Lexer.java
Java8Listener.java
Java8Parser.java
Klasa, która będzie nas interesowała do przeprowadzenia tokenizacji to Java8Lexer.
Ponieważ Plag-Detector będzie wspierał wiele języków programowania stworzyłem enuma, który będzie zawierał wszystkie wspierane języki.
enum class LexerType(val title: String) {
	JAVA_8("Java 8")
}
Następnie stworzyłem prostą fabrykę, która na podstawie przekazanego enuma zwróci mi instancje oczekiwanego leexera.
class LexerFactory {
	fun getLexer(type: LexerType, cs: CharStream): Lexer {
		when (type) {
			LexerType.JAVA_8 -> return Java8Lexer(cs)
		}
	}
}
Klasa Lexer jest klasą abstrakcyjną, po której dziedziczą wszystkie lexery wygenerowane przez ANTLRa.
Sama tokenizacja jest już bardzo prosta:
class TokenizerImpl : Tokenizer {
	override fun tokenize(lexerType: LexerType, input: String): List<Int> {
		val lexer = LexerFactory().getLexer(lexerType, CharStreams.fromString(input))

		return lexer.allTokens.map { t -> t.type }
	}
}
W pierwszej linii metody tworze instancje fabryki, a następnie pobieram lexer. Następnie wywołuję metodę getallTokens(), która zwraca mi listę wszystkich tokenów z przetworzonego kodu źródłowego. Ponieważ do dalszych potrzeb istotne są dla mnie tylko typy tokenów, a nie całe obiekty z nadmiarowymi danymi, mapuję tokeny na ich typ, czyli int. Taką listę intów jest zwracana przez metodę i będzie dalej użyta w procesie wykrywania plagiatów.
Podsumowanie
W tym wpisie przedstawiłem ANTLRa oraz pokazałem jak go skonfigurować. Dodatkowo pokazałem w jaki sposób można użyć ANTLRa, aby dokonać tokenizacji ciągu znaków na wejściu – w naszym przypadku kodu źródłowego.
Artykuł Tokenizacja kodu źródłowego pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Artykuł Kilka słów o ciągłej integracji… pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Continous Integration == Jenkins ?
W swojej pracy mam przyjemność brać udział w rozmowach rekrutacyjnych. Czasami rozmowa schodzi na temat ciągłej integracji. Zauważyłem, że część osób utożsamia Continous Integration (CI) z Jenkinsem (lub czasem z innym toolem, którego akurat używają), ale czy to faktycznie to samo?
Ciągła integracja jest procesem…
Czym jest zatem ta ciągła integracja? W moim rozumieniu jest to proces jak najczęstszej integracji naszych zmian w kodzie z kodem, który znajduję się w repozytorium. Integracja obejmuje również kompilacje kodu, zbudowanie projektu oraz uruchomienie testów.
I w tym całym procesie z pomocą przychodzą nam narzędzia takie jak Jenkins czy TeamCity. Narzędzia te możemy skonfigurować, żeby przeprowadzały powyższe operacje automatycznie. Jenkins, czy inny tool, sprawdza regularnie repozytorium, a gdy wykryje zmiany buduje projekt, a następni uruchamia testy naszej aplikacji.
A może coś więcej?
CI jest według mnie podstawą, o którą powinno się zadbać w każdym projekcie. A co jeżeli chcemy pójść dalej z automatyzacją? Wtedy powinniśmy rozważyć Continous Delivery oraz Continous Deployment.
Czym się różnią te dwa podejścia? Wydaje mi się, że najprościej będzie to przedstawić za pomocą grafiki.

Jak widać oba podejścia są do siebie bardzo podobne. Różnią się właściwie ostatnim krokiem w dostarczaniu aplikacji. W Continous Delivery cały proces jest przeprowadzany automatycznie do momentu wybudowania wersji aplikacji, która będzie gotowa do deploya na serwer produkcyjny.
W Continous Deployment ostatni krok również jest zautomatyzowany i wybudowana wersja trafia automatycznie na produkcje.
Darmowe narzędzie
W ramach tego wpisu pozwolę sobie wpleść kilka słów na temat narzędzia do CI, którego użyłem w swojej aplikacji Plag-Detector. Część narzędzi do CI, tak jak np. Jenkins, jest darmowych, ale wymagają one serwera, na którym będą mogły być uruchomione. Jeżeli nie chcemy/nie możemy posiadać swojego serwera do CI to polecam użyć np. serwisu https://travis-ci.org, który jest darmowym narzędziem do CI. Ma on pewne ograniczenie, a mianowicie możemy go użyć tylko i wyłącznie do projektów, które mamy na naszym koncie GitHub (co w przypadku wymogów konkursów nie jest specjalnie problematyczne ;)).
Moje CI znajduje się tutaj: https://travis-ci.org/lukaszantkowiak/plag-detector.
Konfiguracja Travisa.
Aby Travis działał poprawnie musimy go skonfigurować. Robimy to za pomocą pliku .travis.yml, który wrzucamy do głównego katalogu naszego projektu. Poniżej przedstawię listing swojej konfiguracji dla projektu napisanego w Javie 8.
language: java
jdk:
  - oraclejdk8
Jak widać najprostsza konfiguracja jest banalna i przyjemna
Kilka słów na koniec
W tym wpisie omówiliśmy pokrótce czym są Continous Integration, Continous Delivery i Continous Deployment oraz jakie są różnice między nimi.
Dodatkowo wspomniałem o Travis-CI, który jest darmowym toolem, i z którego zachęcam skorzystać jeżeli nie mamy możliwości postawienia toola do CI na swoim serwerze.
Artykuł Kilka słów o ciągłej integracji… pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Artykuł Hello Kotlin! pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Po kilku wpisach teoretycznych na temat mojej aplikacji przyszła pora, żeby napisać pierwsze linijki w Kotlinie! Postaram się od razu przygotować projekt tak, aby mógł być dalej rozwijany i ostatecznie stać się gotową aplikacją.
Struktura projektu
Aplikacja będzie się nazywać plag-detector. Będzie ona podzielona na kilka modułów. W tym wpisie zacznę od podstawowego modułu mojej aplikacji, czyli części programu, która będzie odpowiedzialna za wyliczanie prawdopodobieństwa plagiatu pomiędzy dwoma kodami źródłowymi.
plag-detector
|--plag-algorithm
Build tool
Przed napisaniem pierwszej linijki kodu warto wybrać narzędzie automatyzujące budowę aplikacji. Wybór padł na klasykę, czyli stary i lubiany Maven
Konfiguracji parenta, czyli plag-detector, nie będę pokazywał. Nie ma tam nic odkrywczego
Poniżej przedstawię pom.xml modułu plag-algorithm.
<project xmlns="http://maven.apache.org/POM/4.0.0" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
         xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 http://maven.apache.org/xsd/maven-4.0.0.xsd">
    <modelVersion>4.0.0</modelVersion>
    <parent>
        <groupId>pl.lantkowiak</groupId>
        <artifactId>plag-detector</artifactId>
        <version>0.0.1-SNAPSHOT</version>
    </parent>
    <artifactId>plag-algorithm</artifactId>

    <properties>
        <kotlin.version>1.1.1</kotlin.version>
        <project.build.sourceEncoding>UTF-8</project.build.sourceEncoding>
    </properties>

    <dependencies>
		...
    </dependencies>

    <build>
        <plugins>
            <plugin>
                <artifactId>kotlin-maven-plugin</artifactId>
                <groupId>org.jetbrains.kotlin</groupId>
                <version>${kotlin.version}</version>
                <executions>
                    <execution>
                        <id>compile</id>
                        <goals>
                            <goal>compile</goal>
                        </goals>
                        <configuration>
                            <sourceDirs>
                                <sourceDir>${project.basedir}/src/main/kotlin</sourceDir>
                                <sourceDir>${project.basedir}/src/main/java</sourceDir>
                            </sourceDirs>
                        </configuration>
                    </execution>
                    <execution>
                        <id>test-compile</id>
                        <goals>
                            <goal>test-compile</goal>
                        </goals>
                        <configuration>
                            <sourceDirs>
                                <sourceDir>${project.basedir}/src/test/kotlin</sourceDir>
                                <sourceDir>${project.basedir}/src/test/java</sourceDir>
                            </sourceDirs>
                        </configuration>
                    </execution>
                </executions>
            </plugin>
            <plugin>
                <groupId>org.apache.maven.plugins</groupId>
                <artifactId>maven-compiler-plugin</artifactId>
                <version>3.6.1</version>
                <configuration>
                    <source>1.8</source>
                    <target>1.8</target>
                </configuration>
                <executions>
                    <execution>
                        <id>default-compile</id>
                        <phase>none</phase>
                    </execution>
                    <execution>
                        <id>default-testCompile</id>
                        <phase>none</phase>
                    </execution>
                    <execution>
                        <id>java-compile</id>
                        <phase>compile</phase>
                        <goals>
                            <goal>compile</goal>
                        </goals>
                    </execution>
                    <execution>
                        <id>java-test-compile</id>
                        <phase>test-compile</phase>
                        <goals>
                            <goal>testCompile</goal>
                        </goals>
                    </execution>
                </executions>
            </plugin>
        </plugins>
    </build>
</project>
W tej konfiguracje ważne są właściwie dwie rzeczy:
- Pluginy do kompilacji Kotlina i Javy. Wydaję mi się, że nie ma za bardzo co tutaj się rozpisywać
- Kolejność pluginów. Plugin Kotlina powinien być przed pluginem do kompilacji kodu Javy. Dzięki temu w kodzie Javowym będziemy mogli używać naszych klas Kotlinowych
Hello world!
I w końcu! Pierwszy kawałek kodu w Kotlinie!
package pl.lantkowiak.plagdetector

// definiujemy nasza klase
class HelloKotlin {
    // oraz nasza metode, ktora sie z nami przywita
    fun sayHello() {
        println("Hello Kotlin!");
    }
}

// ponizsza metoda jest odpowiednikiem metody main w Javie
fun main(args: Array<String>) {
    // tworzymy nowa instancje naszej klasy, a nastepnie wywolujemy metode
    // warto zwrocic uwage, ze nowa instance tworzymy bez uzycia 'new'
    HelloKotlin().sayHello()
}
Po uruchomieniu powyższego kodu, tak jak można się łatwo domyślić, otrzymujemy:
Hello Kotlin!
Kilka słów na koniec
Dzisiaj w wpisie pokazałem szkielet mojej aplikacji. Udało mi się skonfigurować mavena, tak aby kompilował kody napisane zarówno w języku Java, jak i w Kotlnie. Napisałem również pierwszy kod w Kotlinie, który się ładnie przywitał
W następnych wpisach będę pokazywał swoje kolejne zmagania z Kotlinem, przy rozwijaniu plag-detectora
Artykuł Hello Kotlin! pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Artykuł Wykrywanie plagiatów – wybór algorytmu pochodzi z serwisu Lukasz Antkowiak's blog.
]]>PlagDetector – algorytm
Głównym podejściem, wokół którego będzie koncentrował się mój system został opisany przeze mnie w tym wpisie. Chodzi o wykrywanie plagiatów przy użyciu aproksymacji złożoności Kołmogorowa.
Aplikacja będzie składała się z trzech głównych etapów.
Tokenizacja
Pierwszym etapem algorytmu jest poddanie kodu źródłowego tokenizacji.
Bardzo ważną rzeczą, jest dobranie odpowiedniego zestawu tokenów. Ztokenizowany kod programu powinien dobrze oddawać strukturę i logikę programu. Zbyt dokładne tokenizowanie może doprowadzić do pominięcia wykrycia plagiatu z powodu sprawdzania i porównywania nieistotnych informacji. Z drugiej strony, niewystarczająco dokładna tokenizacja może doprowadzić to fałszywych wskazań. Zestaw tokenów oraz sama tokenizacja jest przeprowadzona pod kątem danego języka programowa. Dzięki temu uzyskany ciąg tokenów powinien dobrze oddać strukturę programu. W Listingu poniżej znajduje się fragment przykładowego kodu i odpowiadający mu przykładowy ciąg tokenów.
String var;           VARIABLE_DECLARATION
int i;                VARIABLE_DECLARATION
i = 3;                IDENTIFIER
                      ASSIGN
                      IDENTIFIER
if (i > 2) {          IF_SWITCH_STATEMENT_BEGIN
                      OPEN_PARENTHESIS
                      IDENTIFIER
                      CONDITION
                      IDENTIFIER
                      CLOSE_PARENTHESIS
 var = "more than 2"; IDENTIFIER
                      ASSIGN
                      STRING
}                     IF_SWITCH_STATEMENT_END
else {                IF_SWITCH_STATEMENT_BEGIN
 var = "less than 2"; IDENTIFIER
                      ASSIGN
                      STRING
}                     IF_SWITCH_STATEMENT_END
Kompresja tokenów
Główną rzeczą przy wyborze algorytmu kompresji była konieczność wyboru takiego algorytmu, który będzie bezstratny, lecz jego stopień kompresji będzie możliwie duży. Na podstawie testów i doświadczeń autorów systemu SID (opisanego w poprzednim wpisie) wybór padł na algorytm LZ77.
Najważniejszą modyfikacją, którą wprowadzę do implementowanego algorytmu kompresji w stosunku do oryginalnego algorytmu LZ77 jest nieograniczony bufor słownika oraz nieograniczony bufor wejściowy. Dzięki takiemu podejściu stopień kompresji danych będzie większy niż w przypadku, gdy bufory słownika i wejściowy są ograniczone. Podejście to w oczywisty sposób powoduje wydłużenie działania algorytmu, lecz taki zabieg jest konieczny, aby uzyskać jak najbardziej dokładnie wyniki. Poniżej przedstawiłem pseudokod zmodyfikowanego algorytmu kodowania LZ77.
Require: Input
while(Input nie jest pusty) do
  znajdz najdluzszy prefiks z Input znajdujacy sie w slowniku
  if (znaleziono dopasowanie) then
    dodaj do slownika trojke (left_shift, length, mismatch_token)
      // gdzie:
      // left_shift - przesuniece w lewo
      // length - dlugosc dopasowanego ciagu
      // mismatch_token - pierwszy niepasujacy token
    przesun wskaznik o length + 1
  else
    dodaj do slownika trojke (0, 0, mismatch_token)
      // gdzie:
      // mismatch_token - pierwszy token na wejsciu
    przesun wskaznik o 1
  end if
end while
Wielkością skompresowanego ciągu jest ilość wpisów w słowniku pomnożona przez (shift_size + length_size + token_size), gdzie:
- shift_size – wielkość w bajtach potrzebna do zakodowania przesunięcia w lewo;
- length_size – wielkość w bajtach potrzebna do zakodowania długości;
- token_size – wielkość w bajtach potrzebna do zakodowania jednego tokena.
Aproksymacja złożoności Kołmogorowa
Wartość aproksymacji Kołmogorowa jest przybliżana przy pomocy wzoru:
.
Przez w przypadku konstruowanego algorytmu będzie rozumiana wielkość (w bajtach) skompresowanego programu i będzie oznaczana jako . W związku z tym wzór na przybliżenie aproksymacji Kołmogorowa przyjmie postać:
.
Wartość zostanie przybliżona w następujący sposób:
.
Zatem ostatecznie wartość aproksymacji Kołmogorowa zostanie obliczone ze wzoru:
.
Tak obliczona wartość aproksymacji złożoności Kołmogorowa jest przeliczana na współczynnik R według wzoru:
 .
Wskaźnik ten służy za wskaźnik prawdopodobieństwa zajścia plagiatu. Im wartość  jest większa, tym prawdopodobieństwo plagiatu jest większe.
Dodatkowo dla każdej pary programów obliczane są wartości oraz . Wartości te przedstawiają procentową zawartość informacji z jednego ciągu zawartych w drugim. Wartości te obliczane są w sposób następujący:
 ,
 , gdzie:
.
Wskaźniki i służą jako dodatkowa informacja, wskazująca na zawartość jednego ciągu w drugim. Wartości te mogą wykazać zajście plagiatu, w przypadku gdy jeden z programów zawiera w sobie kod drugiego, lecz sam program jest o wiele bardziej rozbudowany i wartość współczynnika R może nie wskazać zajścia plagiatu.
Podsumowanie
W tym wpisie omówiłem algorytm, który planuję zaimplementować. Składa się on z 3 głównych kroków – tokenizacji, kompresji i aproksymacji złożoności Kołmogorowa. W kolejnych wpisach postaram się bardziej przybliżyć każdy z tych etapów.
Artykuł Wykrywanie plagiatów – wybór algorytmu pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Artykuł Niezmienne obiekty – po co nam one? pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Czym jest Immutable Object?
Tutaj nie ma żadnego haczyka i nazwa dokładnie wskazuje o czym mówimy. Immutable object jest to niezmienny obiekt, czyli taki, którego stan nie może zostać zmieniony cały okres życia obiektu. Czyli po prostu tworzymy nasz obiekt wraz ze wszystkimi wymaganymi atrybutami i żadnego z nich nie możemy zmienić. Przynajmniej w teorii :)… ale zmiany poprzez refleksje się nie liczą, więc uznajemy, że nie mamy możliwości zmiany wartości tych atrybutów
Jakie są zalety i wady tego podejścia?
Niezmienne obiekty, jak wszystko ;), mają zalety i wady. Do najważniejszych zalet według mnie należą:
- Są łatwiejsze w użyciu i testowaniu
- Można je bezpiecznie używać w Setach lub jako klucz w Mapach
- Mogą być łatwo cachowane
- Immutable object mogą być bezpiecznie używane w programowaniu wielowątkowym. Stan tych obiektów nie może ulec zmianie, więc mamy pewność, że każdy wątek widzi aktualny stan obiektu

Wady Immutable Object:
- Nadmiarowy kod – musimy dopisać kilka finali, ale za to pozbywamy się setterów
- Inicjalizacja wszystkich pól przez konstruktory. Ponieważ wszystkie nasze pola są oznaczone jako final, muszą więc zostać zainicjalizowane w konstruktorze. A co jak nie chcemy zawsze podawać wartości wszystkich parametrów, tylko użyć domyślnych wartości dla niektórych pól? Wtedy musimy stworzyć osobny konstruktor dla każdej kombinacji pól, którą chcemy użyć.
- Problem z wydajnością – za każdym razem, gdy chcemy wprowadzić zmianę w naszym obiekcie to sprowadza się to do utworzenia nowego obiektu. Może to być odczuwalne zarówno w czasie działania aplikacji, jak i zużyciu pamięci.
Kiedy ich używać?
Jest na pewno kilka podstawowych use-caseów, kiedy powinniśmy rozważyć użycie niezmiennych obiektów:
- programowanie wielowątkowe – jeżeli mamy obiekt, który ma być współdzielony pomiędzy wątkami to zdecydowanie warto rozważyć użycie immutable object
- obiekt używany jako klucz (np. w mapach) – mamy wtedy pewność, że klucz nie zostanie zmieniony kiedy jest już w użyciu i nie będzie kolizji
- obiekt ma być typowym 'value object’ – wydaje się oczywiste
Z drugiej strony powinniśmy skłaniać się ku 'standardowym obiektom’, kiedy mamy do czynienia:
- z dużymi obiektami, których tworzenie zajmie dużo czasu i/lub pamięci
- obiektami, które posiadają 'tożsaność’, tzn. reprezentują osoby/rzeczy, dla których zmiana pewnych parametrów jest naturalna np. samochód, dla którego naturalnymi jest zmiana takich parametrów jak prędkość czy poziom paliwa.
Implementacja Immutable Object w Javie
Stworzenie Immutable Object w Javie jest dosyć proste. Wystarczy przestrzegać kilku wskazówek
- Wszystkie pola powinny posiadać modyfikatory private i final.
- Nie tworzymy setterów (wynika to zresztą z użycia modyfikatora final przy polach).
- Musimy zabezpieczyć naszą klasę, żeby nie można było po niej dziedziczyć.
- Jeżeli pola naszej klasy zawierają mutable object, wtedy musimy zabezpieczyć te obiekty przed zmianą.
Pora na przykład, który zobrazuje nam powyższe zasady.
public final class MyImmutableObject { // uzywajac final zapewniamy, ze po klasie nie mozna dziedziczyc
	private final String name; // wszystkie pola maja modyfikatory private i final
	private final int age;
	private final List<String> plants;
	private final List<Pet> pets; // uzywajac innych obiektow, musimy zapewnic ich niezmiennosc

	public MyImmutableObject(String name, int age, List<Pet> pets, List<String> plants) {
		this.name = name;
		this.age = age;
		// uzywajac list musimy pamietac o trzech rzeczach:
		// 1. Obiekty w listach powinny rowniez byc Immutable
 		// 2. Stworzyc kopie przekazanej listy, zeby zabezpieczyc sie przez jej modyfikacja z zewnatrz
		// 3. W gecie zwracac kopie listy lub uzyc unmodifiableList lub innej listy, ktorej nie mozna edytowac
		this.pets = Collections.unmodifiableList(new ArrayList(pets));
		this.plants = Collections.unmodifiableList(new ArrayList(plants));
	}

	public String getName() { // zadne z pol nie ma settera
		return name;
	}

	public int getAge() {
		return age;
	}

	public List<Pet> getPets() {
		return pets;
	}

	public List<String> getPlants() {
		return plants;
	}
}
Trochę optymalizacji
Jeżeli nasz niezmienny object będzie na prawdę często używany w naszej aplikacji możemy rozważyć pewne optymalizacje.
Jedną z technik, którą możemy użyć jest Pooling. Jest on np. użyty w JVM w przypadku Stringów. Poniżej przedstawię bardzo prymitywną implementacje tego podejścia.
Na początku stwórzmy jeszcze nasz immutable object, którego użycie będizemy chcieli zoptymalizować.
public final class Person {
	private final String name;
	private final int age;

	public Person(String name, int age) {
		this.name = name;
		this.age = age;
	}

	public String getName() {
		return name;
	}

	public int getAge() {
		return age;
	}
}
I teraz prosty mechanizm poolingu:
public class PersonPool {
	private static final Map<String, Map<Integer, Person>> PEOPLE = new HashMap<>();

	public static Person getPerson(final String name, final int age) {
		if (PEOPLE.containsKey(name)) {
			if (PEOPLE.get(name).containsKey(age)) {
				// jesli w naszej mapie istnieje osoba o tej samej nazwie
				// i wieku to zwracamy utworzona wczesniej osobe
				return PEOPLE.get(name).get(age);
			} else {
				// jezeli istnieje osoba o tym samym imieniu, ale nie wieku
				// to tworzymy nowa osobe, dodajemy do poli i zwracamy utworzony obiekt
				Person p = new Person(name, age);
				PEOPLE.get(name).put(age, p);
				return p;
			}
		} else {
			// jezeli nie istnieje osoba o takim imieniu to rowniez tworzemy nowa osobe
			// i dodajemy ja do naszej poli
			Person p = new Person(name, age);
			PEOPLE.put(name, new HashMap<>());
			PEOPLE.get(name).put(age, p);
			return p;
		}
	}
}
Ogólnie mówiąc ideą jest powtórne użycie wcześniej utworzonego obiektu, jeżeli jest taki sam jak byśmy chcieli stworzyć.
Przy używaniu poolingu powinniśmy mieć na uwadze, że o ile w środowisku jednowątkowym powinien sprawdzić się całkiem nieźle, o tyle przy wielu wątkach narzut na synchronizacje może być znaczący.
Podsumowanie
We wpisie postarałem przedstawić się ideę niezmiennych obiektów, ich wady oraz zalety. Pokazałem również jak zaimplementować taki obiekt w Javie oraz zaproponowałem pewną optymalizacje, którą możemy użyć, aby zwiększyć wydajność naszej aplikacji w przypadku częstego korzystania z naszego immutable object.
UPDATE 14.05.2017
Kolega zwrócił mi uwagę na błąd, który był w listingu z implementacją niezmiennej klasy w Javie – teraz wszystko powinno być ok
Zwrócił również uwagę, że warto dodać wzmiankę o poolingu w środowisku wielowątkowym – dodane
Dzięki
Artykuł Niezmienne obiekty – po co nam one? pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Artykuł Jak wykrywać plagiaty? Część trzecia! pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Systemy bazujące na analizie drzewa wyprowadzeń
Systemy opierające się na analizie drzewa wyprowadzeń wyszukują podobieństwa między programami poprzez wyszukiwanie identycznych lub podobnych poddrzew w drzewie wyprowadzeń.
System CloneDR
System CloneDR jest komercyjnym systemem stworzonym przez firmę Semantic Designs. Działanie systemu opiera się na sprowadzeniu kodu źródłowego programu do drzewa wyprowadzeń, a następnie każda para drzew dwóch programów jest testowana w 3 fazach:
- wykrywanie identycznych i bardzo podobnych powtórzeń poddrzew w badanych drzewach
- wykrywanie powtórzeń deklaracji w kodzie
- wykrywanie podobnych poddrzew, które nie zostały znalezione w pierwszej fazie
Na podstawie danych zebranych podczas tych trzech faz algorytmu system decyduje o prawdopodobieństwie zajścia plagiatu.
Systemy bazujące na analizie grafu zależności
Systemy opierające się na analizie grafu zależności opierają się na budowie i badaniu grafu zależności programów.
System GPlag
Analizowane dane w system GPlag są reprezentowane przez grafy zależności i przepływu danego programu.
Szukanie podobieństw polega na szukaniu izomorficznych podgrafów pomiędzy dwoma drzewami programów.
Systemy bazujące na aproksymacji złożoności Kołmogorowa
Podejście do wykrywania plagiatów poprzez złożoność Kołmogorowa stawia na szukanie podobieństw w ilości informacji niesionych przez program.
Teraz będzie ciężko…
Niech  będzie ciągiem wszystkich maszyn Turinga zakodowanych za pomocą słów nad alfabetem
 . Dla każdego słowa
 możemy zdefiniować jego złożoność Kołmogorowa względem
 jako

A co to znaczy bardziej po ludzku?
Intuicyjnie można powiedzieć, że złożonością Kołmogorowa jest wielkość najmniejszego ciągu, z którego można odtworzyć ciąg x.
Ideą działania systemów opierających się na aproksymacji złożoności Kołmogorowa jest znalezienie właśnie tej aproksymacji dla każdego programu poprzez kompresje danego ciągu.
W przypadku systemów do wykrywania plagiatów przez  określa się długość mierzoną w danej jednostce (np. bajty) najkrótszego programu, który dla pustego wejścia zwróci na wyjściu x. Przez
 rozumie się warunkową złożoność Kołmogorowa. Określa ona ile nowych informacji wnosi napis x, w przypadku kiedy mamy już dany napis y.
Odległość między dwiema złożonościami Kołmogorowa jest definiowana jako:
, gdzie:
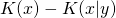 określa ile informacji o słowie x znajduje się w słowie y.
System SID
Ideą działania algorytmu SID jest tokenizacja ciągu wejściowego, jego kompresja oraz przybliżenie złożoności Kołmogorowa.
Pierwszym etapem systemu SID jest zamiana kodu programu źródłowego na ciąg Tokenów przy użyciu parsera.
W kolejnym etapie ciąg tokenów jest poddawany silnej kompresji bezstratnej algorytmem TokenCompress. Twórcy systemu oparli swój algorytm kompresji na algorytmie LZ z pewnymi modyfikacjami. Istotne było uzyskanie jak największego stopnia kompresji, kosztem czasu kompresji.
Aproksymacja  jest liczone w następujący sposób:
, gdzie:
 jest skompresowaną wielkością słowa x.
Im obliczona wartość jest bardziej zbliżona do 0 tym odległość w sensie informacyjnym jest między programami mniejsza i tym samym jest większe prawdopodobieństwo, że programy są do siebie podobne.
Podsumowanie
Tak jak wspomniałem we wstępie, wpisem tym kończę przegląd istniejących sposobów wykrywania plagiatów. Z wszystkich wymienionych sposobów wybiorę jeden i będę starał się go zaimplementować, a następnie przetestować w praktyce
Artykuł Jak wykrywać plagiaty? Część trzecia! pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Artykuł Ile on waży?! pochodzi z serwisu Lukasz Antkowiak's blog.
]]>
W tym wpisie postaram się pokazać w jaki sposób oszacować wielkość obiektów, które tworzymy w Javie.
Typy prymitywne
Niewątpliwie najłatwiej jest określić ilość pamięci zajmowanej przez typy prymitywne. Poniżej przedstawiam tabelkę, która pokazuje ile każdy z typów potrzebuję bajtów w pamięci.
| Typ | bajty |
|---|---|
| boolean | 1 |
| byte | 1 |
| char | 2 |
| int | 4 |
| float | 4 |
| long | 8 |
| double | 8 |
Ilość pamięci potrzebnej do przechowywania booleana może trochę dziwić. W końcu może on przyjąć tylko dwa wartości i w teorii powinien zajmować 1 bit. Specyfikacja JVM nie definiuje ile pamięci jest potrzebne na przechowanie booleana i zależy to od danej implementacji. Dla uproszczenia możemy śmiało przyjąć, że jest potrzebny 1 bajt.
Reszta wartości wydaję się być w miarę oczywista
Tablice
Każda tablica zajmuje wielokrotność danego typu (co wydaję się oczywiste ;)) oraz dodatkowe 24 bajty, które są narzutem tablicy. Poniżej przedstawiam tabelkę z przykładami, które powinny wszystko wyjaśnić.
| Typ | bajty |
|---|---|
| byte[] | N + 24 |
| char[] | 2N+24 |
| int[] | 4N+24 |
| double[] | 8N+24 |
Obiekty
I teraz przechodzimy do mięsa tematu – czyli jak oszacować wielkość obiektu naszej klasy.
Aby to zrobić potrzebujemy kilku dodatkowych informacji.
Narzut obiektu
Każdy obiekt, podobnie jak tablica, powoduje dodatkowy narzut pamięci. W tym przypadku jest to 16 bajtów.
Referencja
Każda przetrzymywana referencja w naszym obiekcie to dodatkowe 8 bajtów.
Padding
Wielkość każdego obiektu jest uzupełniana do wielokrotności 8 bajtów.
Praktyka
Jako przykład weźmy klasę String. Poniżej przedstawiam wycinek implementacji tej klasy, który jest potrzebny do oszacowania wielkości obiektu.
public final class String
	implements java.io.Serializable, Comparable<String>, CharSequence {

	private final char value[];
	private final int offset;
	private final int count;
	private int hash;

	...
}
Do obliczenia potrzebujemy zsumować kilka rzeczy:
- Narzut obiektu – 16 bajtów
- Referencja do tablicy – 8 bajtów
- Tablica – 2N + narzut tablicy 24 bajty
- Pole offset – 4 bajty
- Pole count – 4 bajty
- Pole hash – 4 bajty
Zsumowując wszystko wychodzi nam 2N + 60 bajtów. W takim przypadku musimy jeszcze pamiętać o paddingu, czyli dodajemy 4 bajty, aby całkowita wielkość obiektu była wielokrotnością 8.
Podsumowanie
Powyżej przedstawiłem ogólne zasady, których możemy użyć, aby oszacować wielkość naszych obiektów w Javie. Dzięki temu możemy lepiej zrozumieć co jest alokowane w pamięci i jaki rozmiar zajmuje.
Artykuł Ile on waży?! pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Artykuł Jak wykrywać plagiaty? Część druga! pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Systemy bazujące na metrykach strukturalnych
Techniki wykrywania plagiatów opierające się na metrykach strukturalnych polegają na badaniu podobieństwa na podstawie podobnych lub identycznych fragmentów w badanych plikach. Poniżej opiszę kilka najpopularniejszych systemów służących do wykrywania plagiatów w kodach źródłowych programów, które bazują na metryce strukturalnej.
Dotplot
Metoda Dotplot jest wizualną metodą znajdującą pasujące do siebie fragmenty tekstu (w szczególnym przypadku kodu źródłowego). Decyzja o plagiacie jest podejmowana przez użytkownika analizującego otrzymane wizualne wyniki. Autor systemu uważa, że właśnie dzięki powierzeniu decyzji o plagiacie człowiekowi można zdecydowanie podwyższyć próg skuteczności znajdowania plagiatów. System działa w następujący sposób:
- tokenizacja wejścia
- konkatenacja tokenów z programu A i programu B
- przedstawienie wyników w postaci graficznej
Aby lepiej pokazać działanie algorytmu, poniżej pokażę przykład działania algorytmu.
Ciągi wejściowe:
- Ala ma kota
- Kot ma na imie ala
Przebieg algorytmu:
- tokenizacja: ala
 makota, kotmanaimieala
- konkatenacja: alamakotakotmanaimieala
- wyniki w graficznej formie:
ala ma kota kot ma na imie ala ala XXX XXX ma XXX XXX kota XXX kot XXX ma XXX XXX na XXX imie XXX ala XXX XXX
Na podstawie tak przedstawionych wyników, osoba analizująca dane z pomocą wskazówek, stworzonych przez autora systemu, może stwierdzić zajście plagiatu.
JPlag
System JPlag jest darmowym systemem do wykrywania plagiatów dostępnym online. System analizując kody źródłowe programów działa w dwóch etapach:
- Parsowanie i tokenizacja kodu źródłowego.
Przy pomocy parsera i tokenizera kod źródłowy programu jest zamieniany na ciąg tokenów. - Porównanie par ciągów tokenów ze sobą.
Każda para ciągu tokenów jest porównywana ze sobą przy użyciu algorytmu Greedy String Tiling
Przy porównywaniu tokenów przestrzegane są następujące zasady:- Każdy token z programu A może zostać dopasowany tylko do jednego tokena z programu B.
- Podciągi tokenów są znajdowane niezależnie od ich pozycji.
- Dłuższe podciągi są bardziej preferowane od krótszych
Uwzględniając powyższe zasady powstał algorytm, który przebiega w dwóch fazach:
- W pierwszej fazie algorytmu w dwóch ciągach tokenów znajdowany jest najdłuższy wspólny podciąg dla dwóch podanych ciągów wśród tokenów, które nie są oznaczone.
- W drugiej fazie wszystkie tokeny zawierające się w znalezionym w fazie pierwszej podciągu zostają oznaczone jako użyte i algorytm wraca do punktu pierwszego.
Algorytm jest wykonywany dopóki są znajdowane dopasowania tokenów o długości nie mniejszej niż ustalony próg.\par
W listingu poniżej przedstawiono pseudo-kod algorytmu Greedy String Tiling.
Greedy-String-Tiling(String A, String B) {
	tiles = {};
	do {
		maxmatch = MinimumMatchLength;
		matches = {};
		Forall unmarked tokens A(a) in A {
			Forall unmarked tokens B(b) in B {
				j = 0;
				while (A(a)+j == B(b)+j && unmarked(A(a+j)) && unmarked(B(b+j))) {
					j++;
				}
				if (j == maxmatch) {
					append(matches,match(a,b,j));
				}
				else if (j > maxmatch) {
					matches = {match(a,b,j)};
					maxmatch = j;
				}
			}
		}
	}
}
Na podstawie wyniku działania algorytmu jest wyliczane prawdopodobieństwo w następujący sposób:
 , gdzie:

Obliczone podobieństwo jest wyrażone w procentach, zatem im wyższa wartość tym większe prawdopodobieństwo na to, że mamy do czynienia z plagiatem.
MOSS
Ostatnim systemem opierającym się na metrykach strukturalnych, który opiszę jest MOSS. Głównym algorytmem systemu jest algorytm Winnowing. Jego zasada działania opiera się na k-gramach, czyli podciągach tokenów długości k. Algorytm przebiega następująco:
- podanie na wejście ciągu znaków
- usunięcie zbędnych znaków
- podzielenie ciągu wejściowego na k-gramy
- zamiana k-gramów na hashe
- wybranie części hashów, według odpowiedniego algorytmu – wybrane hashe tworzą tzw. odcisk palca programu.
Tak przygotowane zestawy odcisków palca są ze sobą porównywane w celu znalezienia jak największych wspólnych części odcisków palców.
Krótkie podsumowanie
Dzisiaj pokazałem bardziej zaawansowane systemy wykrywania plagiatów. według mnie na szczególną uwagę zasługuje system JPlag, który ma całkiem niezłą skuteczność.
W jednym z kolejnych wpisów opiszę jeszcze 2-3 podejścia do tego problemu. Po tej dawce teorii będziemy mogli z czystym sumieniem przejść do praktyki i implementacji naszego algorytmu
Artykuł Jak wykrywać plagiaty? Część druga! pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Artykuł Adnotacje – starcie drugie! pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Małe uzupełnienie poprzedniego wpisu
W poprzednim wpisie pominąłem jedną (przynajmniej :P) istotną sprawę przy tworzeniu adnotacji.
Dziedziczenie adnotacji
Przy tworzeniu adnotacji możemy użyć również @Inherited, który powoduje, że adnotacja będzie widoczną również jako obecna na klasach, które dziedziczą po klasie z tą adnotacją.
Zdefiniujmy naszą adnotacje następująco:
@Inherited
@Retention(RetentionPolicy.RUNTIME)
public @interface MyAnnotation {
}
Klasę, która będzie oznaczona naszą adnotacją:
@MyAnnotation
public class MySuperClass {
}
I naszą klasę dziedziczącą po MySuperClass:
public class MyClass extends MySuperClass {
}
W ten sposób MyAnnotation będzię widoczne również na MyClass.
Wracając do tematu…
Wydaję mi się, że najpopularniejszym przypadkiem użycia adnotacji są różnego rodzaju frameworki jak np. Hibernate czy Spring.
Jeżeli mamy naszą klasę oznaczoną np. adnotacją @Entity, to jak framework 'znajduje’ informacje, że dana klasa ma właśnie tą adnotacje?
Jako przykład weźmy prostą adnotacje:
@Retention(RetentionPolicy.RUNTIME)
public @interface MyAnnotation {
	String name();
}
oraz klasę:
@MyAnnotation(name = "Santa")
public class MyClass {
	private int a;
}
I teraz spróbujemy dobrać się do naszej adnotacji
Zacznijmy może od początku – czyli warto byłoby najpierw znaleźć klasy z adnotacjami, żebyśmy wiedzieli z czym będziemy pracować
W Springu definiujemy pakiety, które mają być skanowane pod kątem adnotacji. Wyjdziemy z tego samego założenia – nie ma sensu skanować wszystkich klas, jeżeli nie jest to konieczne
Stwórzmy zatem dwie metody, dzięki którym będziemy mogli przejść rekurencyjnie po wszystkich folderach z danego pakietu o zwrócić listę wszystkich klas, adnotacji i interfejsów.
private static List<Class<?>> getClasses(final String packageName) throws Exception {
	// pobieramy Class Loader
	ClassLoader classLoader = Thread.currentThread().getContextClassLoader();
	// tworzymy nasza 'wyjsciowa' sciezke do rozpoczecia poszukiwan innych klas
	String path = packageName.replace('.', '/');
	// pobieramy liste wszystkich plikow z naszej wyjsciowej sciezki
	Enumeration<URL> resources = classLoader.getResources(path);

	List<Class<?>> classes = new ArrayList<Class<?>>();
	// iteratujemy po wszystkich plikach, znajdujemy wszystkie klasy z danego folderu i dodajemy do listy
	while (resources.hasMoreElements()) {
		final File dir = new File(resources.nextElement().getFile());

		classes.addAll(findClasses(dir, packageName));
	}

	// zwracamy liste znalezionych klas
	return classes;
}
private static List<Class<?>> findClasses(File directory, String packageName) throws Exception {
	final String _class = ".class";
	List<Class<?>> classes = new ArrayList<Class<?>>();
	// iterujemy po wszystkich plikach z danej lokalizacji
	for (File file : directory.listFiles()) {
		// jezeli obiekt jest folderem
		if (file.isDirectory()) {
			// to dodajemy jego nazwe do nazwy pakietu i iteracyjnie bedziemy dalej szukac klas
			classes.addAll(findClasses(file, packageName + "." + file.getName()));
		// jezeli plik jest klasa
		} else if (file.getName().endsWith(_class)) {
			// to za pomoca Class.forName ladujemy nasza klase, a nastepnie dodajemy do zwracanej listy
			classes.add(Class.forName(packageName + '.' + file.getName().substring(0, file.getName().length() - _class.length())));
		}
	}
	return classes;
}
Metody są okraszone komentarzami, więc nie powinno być problemu ze zrozumieniem co tam się dzieje.
Metody nie robią co prawda nic skomplikowanego, ale po co pisać coś, co zostało już raz dobrze napisane Metody te pokazałem, żeby przedstawić jak to wygląda od podstaw, w najprostszej formie. W życiu codziennym polecam używanie odpowiednich metod z Spring, Guavy czy np. Reflections Library.
I teraz samo znajdowanie klas z naszą adnotacją:
public static void main(String[] args) throws Exception {
	// zmajdujemy wszystkie klasy z pakietu pl.lantkowiak
	List<Class<?>> classes = getClasses("pl.lantkowiak");

	for (Class<?> clazz : classes) {
		// pobieramy nasza adnotacje
		final MyAnnotation annotation = clazz.getAnnotation(MyAnnotation.class);

		// jezeli adnotacja jest nullem to oznacza, ze dana klasa nie posiada tej adnotacji
		if (annotation != null) {
			String name = annotation.name();

			System.out.println(clazz + " : " + name);
		}
	}
}
Metoda wypisze na ekranie następującą linie:
class pl.lantkowiak.MyClass : Santa
Jak widać udało nam się znaleźć wszystkie (całą jedną w tym konkretnym przypadku ;)) klasy z adnotacją @MyAnnotation i odczytać wartości atrybutów adnotacji.
Podsumowanie
We wpisie został pokazany sposób w jaki można znaleźć klasy z konkretnego pakietu z konkretną adnotacją. Dzięki temu możemy zdefiniować własne zachowania/akcje dla klas z danymi adnotacjami.
Oczywiście wpis ten nie wyczerpuje tematu. Mechanizm refleksji dostarcza wielu innych metod związanych ze znajdywaniem klas czy adnotacji. Zachęcam do zagłębienia się w ten temat
Artykuł Adnotacje – starcie drugie! pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Artykuł Jak wykrywać plagiaty? Część pierwsza! pochodzi z serwisu Lukasz Antkowiak's blog.
]]>W tym i w kilku (0, 1 lub 2 :P) kolejnych wpisach postaram się przedstawić kilka istniejących podejść do tego problemu.
Systemy bazujące na zliczaniu atrybutów
Pierwszymi automatycznymi systemami do wykrywania plagiatów w kodach źródłowych programów były systemy polegające za zliczaniu i porównywaniu atrybutów programów.
Miara złożoności Halstead’a
Pierwszym automatycznym systemem służącym do automatycznego porównywania stopnia podobieństwa między kodami źródłowymi programów był system zaproponowany przez Halsted’a w 1977 roku. System ten do mierzenia podobieństwa programów używał czterech statystyk programu:
 – liczba unikalnych operatorów
 – liczba unikalnych operandów
 – liczba wystąpień operatorów
 – liczba wystąpień operandów
Pary programów, u których powyższe wartości były identyczne były dalej przeglądane przez człowieka w celu stwierdzenia lub odrzucenie zajścia plagiatu (spora wada tego systemu ;)).
Powyższy system miał bardzo ograniczone możliwości. Statystyki takie jak liczba wystąpień operatorów czy ilość unikalnych operatorów są wartościami, które można w bardzo łatwy sposób zmienić, a co za tym idzie oszukać opisany wyżej system.
System Accuse Grier’a
System Accuse, stworzony przez Grier’a, powstał na bazie wcześniej opisanego systemu. Grier w swoim systemie do badania podobieństw między programami używa następujących statystyk:
- liczba unikalnych operatorów
- liczba unikalnych operandów
- liczba wystąpień operatorów
- liczba wystąpień operandów
- liczba linii kodu
- liczba zmiennych zadeklarowanych i użytych
- liczba wszystkich instrukcji kontrolnych
W pierwszej fazie system Accuse zliczał dla każdego programu wyżej wymienione parametry. W drugiej fazie jest obliczania korelacja pomiędzy parami programów. Przy obliczaniu korelacji używane są dwa stałe parametry:
- rozmiar okna (window) – określa maksymalną różnicę pomiędzy zliczonymi statystykami dwóch programów
- wartość ważności (importance) – waga danego parametru przy obliczaniu korelacji
Następnie korelacja jest obliczana w następujący sposób:
- wartość korelacji jest ustawiana na 0
- dla każdej metryki wykonywane jest:
- jeżeli
 jest wartością i-tej metryki programu A i
 jest korenspondującą metryką w programie B wtedy
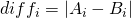 .
- jeżeli
 wtedy
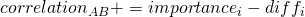 .
- jeżeli
Przy parach programów z dużą wartością obliczonej korelacji zachodzi prawdopodobieństwo plagiatu i programy te powinny zostać przejrzane przez człowieka (tym razem jest o tyle lepiej, że nie wszystkie porównania muszą zostać przejrzane ;)).
System Faidhi-Robinson
Faidhi i Robinson stworzyli listę metryk służącą do wykrywania plagiatów. Metryki te według nich miały być lepsze od metryk opisanych w systemie Accuse. Metryki te, nie korelują ze sobą, a dodatkowo w tych metrykach są ukryte dodatkowe miary, które powinny być ciężkie do zmiany przynajmniej przez programistę (a przynajmniej początkującego ;).
Pierwsze dziesięć metryk Faidhi i Robinson zakwalifikowali do grupy metryk, które według nich może bez większego problemu zmienić nawet początkujący programista.
- średnia ilość znaków na linię
- liczba linii z komentarzami
- liczba linii z wcięciami
- liczba pustych linii
- średnia długość procedury lub funkcji
- liczba słów kluczowych
- średnia długość identyfikatora
- średnia ilość spacji na linię
- liczba etykiet i poleceń goto
- liczba unikalnych identyfikatorów
Kolejne 14 metryk zostało wybranych jako metryki mierzące strukturę programu, które są trudne do zmodyfikowania przez programistę.
- liczba etapów programów – przy pomocy algorytmu Cocke’a i Allen’a jest tworzony graf przepływu
- liczba kolorów wierzchołków o kolorach 1 i 2 w pokolorowanym grafie przepływu
- liczba wierzchołków mających kolor 3
- liczba wierzchołków mających kolor 4
- procentowa ilość wyrażeń w programie
- procentowa ilość prostych wyrażeń w programie
- procentowa ilość termów w programie
- procentowa ilość współczynników w programie
- liczba zbędnych rzeczy w programie – np. zbędne średniki lub pary BEGIN/END
- liczba linii wewnątrz funkcji i procedur
- liczba funkcji i procedur
- procentowa ilość wyrażeń warunkowych
- procentowa ilość powtarzających się wyrażeń
- liczba instrukcji w programie
W systemie Faidhi-Robinson, podobnie jak w poprzednim systemie, do obliczania podobieństwa użyto dwóch stałych parametrów:
- rozmiar okna (window)
- wartość ważności (importance)
Algorytm obliczania podobieństwa wygląda następująca:
- dla każdej metryki:

Całkowita korelacja wynosi zatem:
 .
Im otrzymana korelacja miała większą wartość tym zachodziło większe prawdopodobieństwo plagiatu.
Krótkie podsumowanie
W tym wpisie przedstawiłem kilka pierwszych systemów do wykrywania plagiatów w kodach źródłowych. Niestety nie były one zbyt efektywne.
W kolejnych wpisach opiszę kilka innych podejść do wykrywania plagiatów, które charakteryzują się większą skutecznością.
Artykuł Jak wykrywać plagiaty? Część pierwsza! pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Artykuł Adnotacje w Javie pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Adnotacje są to metadate, które dostarczają nam informacji na temat programu, ale same nie są częścią kodu, ani bezpośrednio nie wpływają na kod.
Najprostszą adnotacje możemy stworzyć w następujący sposób:
public @interface MyAnnotation {
}
Teraz możemy użyć jej w naszym kodzie:
@MyAnnotation
public class MyClass {
}
Pola
Do naszych adnotacji możemy dodawać pola. Aby to zrobić musimy je zdefiniować w ciele naszej adnotacji.
public @interface MyAnnotation {
	String name();
}
I samo użycie:
@MyAnnotation(name = "My name")
public class MyClass {
}
Jeżeli nasze pole będzie miał nazwę value, wtedy możemy pominąć nazwę pola w użyciu adnotacji.
public @interface MyAnnotation {
	String value();
}
@MyAnnotation("My name")
public class MyClass {
}
Domyślne wartości pól
W przykładach powyżej podanie wartości zdefiniowanych pól jest obowiązkowe. Jeżeli chcemy, aby podanie pola nie było wymagane musimy zdefiniować jego domyślną wartość.
public @interface MyAnnotation {
	String name() default "My default name";
}
Wtedy przy użyciu adnotacji możemy, ale nie musimy, podawać wartość pola.
Zakres adnotacji
Adnotacje domyślnie mogą być używane na:
- innych adnotacjach
- konstruktorach
- metodach
- polach
- lokalnych zmiennych
- pakietach
- parametrach metod
- klasach, interfejsach, enumach
- typach generycznych (od Java 8)
Domyślnie nowo stworzona adnotacja może być używana w każdym z wymienionych wcześniej miejsc. Możemy jednak ograniczyć jej zasięg poprzez użycie adnotacji @Target z parametrami definiującymi zasięg.
@Target({ElementType.FIELD})
public @interface MyAnnotation {
	String name() default "My default name";
}
Wszystkie dostępne wartości ElementType to:
- ANNOTATION_TYPE
- CONSTRUCTOR
- METHOD
- FIELD
- LOCAL_VARIABLE
- PACKAGE
- PARAMETER
- TYPE
- TYPE_PARAMETER
Kolejne wymienione wartości ElementType odpowiadają wcześniej wymienionym miejscom opisującym gdzie można użyć adnotacji.
Dodatkowo w Javie 8 wprowadzono ElementType.TYPE_USE, który może być użyty na wszystkich typach.
Retencja adnotacji
Dla każdej adnotacji możemy ustalić jej zakres widoczności. Definiujemy to przez dodanie adnotacji @Retention.
@Retention(RetentionPolicy.CLASS)
public @interface MyAnnotation {
}
Dostępne są trzy wartości dla adnotacji @Retention:
- RetentionPolicy.SOURCE – informacja o adnotacji jest dostępna jedynie podczas kompilacji; przykładami takich adnotacji są @Override i @SuppressWarnings
- RetentionPolicy.CLASS – adnotacja jest dostępna podczas ładowania klas; jest to domyślny poziom retencji
- RetentionPolicy.RUNTIME – adnotacja jest dostępna podczas działania aplikacji, dzięki czemu mamy do niej dostęp poprzez refleksje; przykładem takiej adnotacji jest @Deprecated
Krótkie podsumowanie
W wpisie przedstawiłem najważniejsze informacje na temat adnotacji w Javie. Mam nadzieję, że okażą się one przydatne i choć trochę ułatwią poruszanie się po frameworkach, które pełne są najróżniejszych adnotacji
Artykuł Adnotacje w Javie pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Artykuł Daj się poznać 2017 pochodzi z serwisu Lukasz Antkowiak's blog.
]]>
Kilka słów o aplikacji
W ramach konkursu zamierzam napisać aplikacje służącą do wykrywania plagiatów pomiędzy kodami źródłowymi programów.
Co będzie dokładnie robiła aplikacja? Będziemy mogli wysłać kilka kodów źródłowych programów w wybranym języku, a następnie dostaniemy informacje jak bardzo poszczególne kody są do siebie podobne.
Aplikacja będzie napisana w Kotlinie i AngularJS. Dlaczego własnie te dwie technologie? Ponieważ nie znam żadnej z nich

Backend zostanie napisany w Kotlinie. Będzie składał się z dwóch części, Pierwsza część – 'corowa’ – będzie implementowała algorytm do wykrywania podobieństw. Druga część będzie wystawiała restowe web serwisy, udostępniając funkcjonalność.
Frontend, tak jak wspomniałem wcześniej, zostanie napisany w AngularJS. Będzie to prosta (przynajmniej w założeniu) stronka, na której będziemy mogli załadować pliki do sprawdzenia, a następnie wysłać do naszego serwisu, otrzymać odpowiedź i wyświetlić ją użytkownikowi.
To by było na tyle, jeżeli chodzi o ogólny opis aplikacj
Artykuł Daj się poznać 2017 pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Artykuł Kontrakt hashCode i equals pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Kontrakt
Metody equals oraz hashCode powinny spełniać poniższe warunki:
- Jeżeli x == y to x.equals(y) == true
- Jeżeli x.equals(y) == true to x.hashCode() == y.hashCode()
- Jeżeli x.hashCode() == y.hashCode() to x.equals(y) może zarówno zwrócić true, jak i może zwrócić false
Wszystkie wartości zwracane przez powyższe funkcje muszą być determistyczne – zawsze zwracać te same wartości dla tych samym parametrów.
Domyślna implementacja
Metody hashCode i equals są zdefiniowane w Object, czyli w klasie nadrzędnej dla wszystkich klas w Java. Domyślne implementacje wyglądają następująco:
public boolean equals(Object obj) {
	return (this == obj);
}
Domyślna implementacja metody equals opiera się na sprawdzeniu czy przekazany obiekt jest tą samą instancją, co obiekt, na którym wywołano metodę equals. Jak widać domyślna implementacja w żaden sposób nie opiera się na atrybutach klasy.
public native int hashCode();
Klasa Object nie ma natomiast zdefiniowanego ciała metody hashCode. Każda implementacja JVM dostarcza swoją wersje tej metody. Zazwyczaj jest to adres pamięci, pod którym znajduje się obiekt, zamieniony na typ integer. Podejście takie byłoby prawidłowe, gdyby każdy obiekt był unikalny. W przypadku kiedy dwa obiekty są identyczne (bazując na atrybutach klasy) implementacja taka nie spełnia kontraktu tej metody.
Przykładowe implementacje
Oczywiście powyższe metody możemy (a często wręcz musimy) nadpisać i dostosować do naszych potrzeb. Załóżmy, że mamy poniższą klasę, do której chcemy dopisać nasze dwie metody, o których rozmawiamy.
class Person {
	private final String name;
	private final int age;

	public Person(final String name, final int age) {
		this.name = name;
		this.age = age;
	}

	public String getName() {
		return name;
	}

	public int getAge() {
		return age;
	}
}
Przykładowe implementacja metody hashCode mogą wyglądać następująco:
@Override
public int hashCode() {
	final int prime = 31;
	int result = 1;
	result = prime * result + age;
	result = prime * result + ((name == null) ? 0 : name.hashCode());

	return result;
}
Jak widać wartość hashCode jest wyliczana przy użyciu mnożenia i dodawanie na podstawie wszystkich pól klasy.
Implementacja equals dla naszej klasy może wyglądać tak:
@Override
public boolean equals(Object obj) {
	if (this == obj) {
		return true;
	}
	if (obj == null) {
		return false;
	}
	if (getClass() != obj.getClass()) {
		return false;
	}
	final Person that = (Person) obj;
	if (age != that.age) {
		return false;
	}
	if (name == null) {
		if (that.name != null) {
			return false;
		}
	} else if (!name.equals(that.name)) {
		return false;
	}
	return true;
}
Tutaj już się dzieję trochę więcej… albo przynajmniej wygląda jakby się działo więcej.
W liniach 3-11 sprawdzamy identyczność obiektów na poziomie samego obiektu, a nie jego atrybutów. Sprawdzamy czy:
- przekazany obiekt jest tym samym obiektem, na którym została wywołana metoda – jeżeli jest to oczywiście zwracamy true
- przekazany obiekt nie jest nullem – jeżeli jest to zwracamy false – obiekt, na ktorym wywołaliśmy metodę z oczywistych powodów nie może być nullem
- oba obiekty są tego samego typu – jeżeli nie są to oczywiście zwracamy false
Jeżeli obiekt przejdzie te 3 warunki to jest rzutowany na nasz typ klasy, a następnie każde pole klasy jest porównywane. Jeżeli, któreś z porównywanych pól jest inne to oczywiście zwracamy false, a w przeciwnym przypadku przechodzimy dalej. Kiedy już wszystkie pola zostały sprawdzony to zwracamy true.
Bardziej praktyczna implementacja
Implementacje powyższych metod nie są trudne, ale zajmują trochę linii kodu (szczególnie equals). Dodatkowo implementując ręcznie te metody dla klas z większą ilością pół łatwo o pomyłke. Co prawda każde IDE potrafi wygenerować implementacje powyższych metod na podstawie pól klasy, ale wciąż zostaje problem pierwszy – dużo linii i brzydko to wygląda
Bardzo polecam używanie bibliotek, które zawierają wbudowany builder’y do tych metod. Jedną z takich bibliotek jest common-lang od Apache.
Implementacja hashCode przy użyciu tej metody wygląda następująco:
@Override
public int hashCode() {
	return new HashCodeBuilder().append(age).append(name).toHashCode();
}
Jak widać kod dla tej metody został zdecydowanie uproszczony i jest bardziej przejrzysty.
Implementacja metody equals może wyglądać na przykład tak:
@Override
public boolean equals(Object obj) {
	if (this == obj) {
		return true;
	}
	if (obj == null) {
		return false;
	}
	if (getClass() != obj.getClass()) {
		return false;
	}
	final Person that = (Person) obj;
	return new EqualsBuilder().append(this.age, that.age).append(this.name, that.name).isEquals();
}
Jak widać kod w tym przypadku również się trochę uprościł. Trzy pierwsze if’y co prawda zostały, ale reszta kodu została zdecydowanie skrócona i jest bardziej czytelna.
Jak widać dzięki użyciu kodu z biblioteki mogliśmy stworzyć nasze metody pisząc mniej kodu, który jest jednak bardziej czytelny i przejrzysty.
A może by tak jeszcze coś ulepszyć?
Patrząc na implementacje metody equals można by się zastanowić czy użycie instanceof zamiast drugiego i trzeciego if’a nie byłoby dobrym pomysłem. Wtedy nasza klasa mogłaby wyglądać w następujący sposób:
class Person {
	private final String name;
	private final int age;

	public Person(final String name, final int age) {
		this.name = name;
		this.age = age;
	}

	public String getName() {
		return name;
	}

	public int getAge() {
		return age;
	}

	@Override
	public int hashCode() {
		return new HashCodeBuilder().append(age).append(name).toHashCode();
	}

	@Override
	public boolean equals(Object obj) {
		if (this == obj) {
			return true;
		}
		if (!(obj instanceof Person)) {
			return false;
		}
		final Person that = (Person) obj;
		return new EqualsBuilder().append(this.age, that.age).append(this.name, that.name).isEquals();
	}
}
Dzięki takiemu podejściu 'oszczędzamy’ jednego if’a, a wszystko działa jak działało. Chociaż…
Spójrzmy na poniższą klase:
class Student extends Person {
	private final String school;

	public Student(final String name, final int age, final String school) {
		super(name, age);
		this.school= school;
	}

	public String getSchool() {
		return school;
	}

	@Override
	public int hashCode() {
		return new HashCodeBuilder().appendSuper(super.hashCode())
				.append(school).toHashCode();
	}

	@Override
	public boolean equals(Object obj) {
		if (this == obj) {
			return true;
		}
		if (!(obj instanceof Student)) {
			return false;
		}
		final Student that = (Student) obj;
		return new EqualsBuilder().appendSuper(super.equals(that))
				.append(this.school, that.school).isEquals();
	}
}
Stworzyliśmy klasę Student, która dziedziczy po Person. Nasza nowa klasa zawiera dodatkowe pole 'school’.
Zróbmy teraz coś takiego:
final Person p = new Person("Adam", 15);
final Student s = new Student("Adam", 15, "uj");

System.out.println(p.equals(s)); // true
System.out.println(s.equals(p)); // false
Jak widać dochodzimy do sytuacji, gdzie tworzymy dwa różne obiekty i w zależności od tego, który do którego porównamy to otrzymujemy różne wyniki. Równość powinna być relacją symetryczną, a taka sytuacja zdecydowanie ją narusza.
Czy to oznacza, że to podejście jest błędne? Odpowiedź jest bardzo prosta i brzmi: to zależy
Wersja equals z getClass jest, powiedzmy, 'restrykcyjna’, ale za to prosta i intuicyjna. Porównywany obiekt musi być dokładnie tego samego typu co obiekt, do którego jest porównywany.
Druga wersje może narobić nam trochę ambarasu, lecz zostawia trochę więcej swobody. Istotnym przypadkiem, kiedy takie podejście może być konieczne jest porównywanie obiektów, które są zarządzane przez jakiś framework np. część implementacji JPA opakowuje encje. W takiej sytuacji, dzięki użyciu instanceof w metodzie equals jesteśmy w stanie w poprawny sposób porównywać takie obiekty.
Jak widać obydwa sposoby implementacji metody equals mają swoje zastosowania. Najważniejsze, żeby świadomie wybierać podejście, którego potrzebujemy
Artykuł Kontrakt hashCode i equals pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Artykuł Krótkie podsumowanie mojego udziału w „Daj się poznać” pochodzi z serwisu Lukasz Antkowiak's blog.
]]>
Było kilka powodów, dla którego zdecydowałem zgłosić się do „Daj się poznać”.
- większa motywacja do stworzenia aplikacji, nad którą i tak zaczynałem pracować
- sprawdzenie się czy jestem w stanie pisać regularnie notki na blogu
- chęć poćwiczenia umiejętności, którą bym nazwał 'płynność pisania’
A jak to się sprawdziło w praktyce?
Motywacja do tworzenia aplikacji była taka sama jak wcześniej Chciałem napisać tą aplikacje (w sumie to dalej chcę ;)) tak samo i w ramach wolnego czasu starałem się ją rozwijać. Rzeczą, którą zmieniłem po zgłoszeniu się do konkursu była decyzja o zmianie języka. Pierwsze dwa ekrany miałem już napisane w Javie, ale stwierdizłem, że jest to dobra okazja, żeby pouczyć się Scali Więc w sumie gdyby nie konkurs to właściwie miałbym aplikacji napisane więcej niż teraz ;), ale za to mniej umiałbym Scali – więc w sumie sądzę, że dobrze wyszło
Czy udało mi się pisać notki regularnie? Prawie Wpisy pojawiały się prawie zawsze 2 razy w tygodniu, więc tutaj prawie pełen sukces Niestety czasem miałem wrażenie, że nie mam czasu na rozwijanie aplikacji, bo muszę pisać notkę
Co prowadzi nas do punktu 3 Każda notka, szczególnie na początku, sprawiała mi sporo trudności, żeby ją napisać. Wraz z każdą kolejną notką było co raz lepiej, ale do pożądanego przeze mnie poziomu jeszcze daleka droga
Podsumowując jednym zdaniem swój udział w „Daj się poznać” – Jestem zadowolony
Artykuł Krótkie podsumowanie mojego udziału w „Daj się poznać” pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Artykuł DatePicker w Androidzie pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Właśnie do wyszukiwania po datach postanowiłem użyć datepicker’a.
W formularzu chcę mieć dwie kontrolki:
- pole tekstowe, gdzie będzie można ręcznie wpisać date
- ikonka kalendarza, w którą jak klikniemy pojawi nam się nasz datepicker, a wybrana data zostanie zapisana we wcześniej wspomnianym polu tekstowym
Czyli na początku stworzyłem dwie wcześniej wspomniane kontrolki:
<EditText android:id="@+id/from_date"
    android:layout_width="match_parent"
    android:layout_height="wrap_content"
    android:inputType="text"
    android:hint="form date" />

<Button
    android:id="@+id/form_date_datepicker"
    android:layout_width="25sp"
    android:layout_height="25sp"
    android:background="@android:drawable/ic_menu_my_calendar"
    android:onClick="datePicker" />
Pierwsza kontrolka to zwyczajne pole tekstowe. Druga kontrolka to przycisk, który po kliknięciu wywoła metodę datePicker. Metoda ta wygląda w następujący sposób:
def datePicker(view: View): Unit = {
  showDialog(datePickerCode)
}
Gdzie datePickerCode jest zdefiniowanym w aplikacji kodem dla danej akcji czyli po prostu liczba typu Int.
Wywołanie metody showDialog(Int) wywoła metodę onCreateDialog, która u mnie wyglada następująco:
override protected def onCreateDialog(id: Int): Dialog = {
  if (id == datePickerCode) {
    val now = Calendar.getInstance()
    return new DatePickerDialog(this, new DateListener(findViewById(R.id.from_date).asInstanceOf[EditText]), now.get(Calendar.YEAR), now.get(Calendar.MONTH), now.get(Calendar.DAY_OF_MONTH))
  }
  null
}
Akcje wykonywane w tej metodzie są dosyć proste. W przypadku gdy metoda zostanie wywołana z naszym kodem tworzymy DatePickerDialog z naszą implementacją OnDateSetListener. U mnie wygląda to następująco:
class DateListener(editText: EditText) extends DatePickerDialog.OnDateSetListener {
  override def onDateSet(view: DatePicker, year: Int, monthOfYear: Int, dayOfMonth: Int): Unit = {
    editText.setText(year + "-" + monthOfYear + "-" + dayOfMonth)
  }
}
Wydaję mi się, ze kod jest na tyle prosty oraz intuicyjny, że nie będę bardziej szczegółowo opisywał tych funkcji oraz klasy
Artykuł DatePicker w Androidzie pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Artykuł Opis ekranów i funkcjonalności aplikacji cz. 2 pochodzi z serwisu Lukasz Antkowiak's blog.
]]>- Wyświetlanie szczegółów dokumentu
 Na górze strony, na niebieskim tle, znajduje się tytuł dokumentu. Po prawej stronie znajduje się button uruchamiający edycje dokumentu.
Poniżej są wypisane wszystkie tagi z dokumentu. Pod spodem znajdują się wyświetlone wszystkie pliki wraz z opisem plików. Każda miniaturka po kliknięciu uruchamia zdjęcię w pełnej rozdzielczości. - Edycja dokumentu
 Edycja dokumentu jest praktycznie identyczna jak dodawanie dokumentu, które opisywałem jakiś czas temu. Główną różnicą jest oczywiście to, że do formularza zostają załadowane tytuł, tagi oraz pliki wraz z opisami.
Artykuł Opis ekranów i funkcjonalności aplikacji cz. 2 pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Artykuł Problem z GUI tworzonym w kodzie pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Problem, który chcę opisać, napotkałem przy tworzeniu ekranu wyświetlającego szczegóły dokumentu. Na tym ekranie powinien być widoczny tytuł dokumentu, tagi oraz wszystkie pliki wraz z ich opisami. I przy tym ostatnim elemencie powstały problemy.

Powyżej wstawiłem efekt jaki bym chciał osiągnąć. Chodzi oczywiście o rozmieszczenie elementów – niebieskie linie oraz zielony kolor zostały dodane dla lepszej widoczności co się dzieję. Wracając do układu elementów – pliki chciałbym wyświetlić w formie tabelarycznej, gdzie w lewej kolumnie będzie miniaturka zdjęcia/pliku, a w prawej będzie dodany opis pliku.
Powyższy efekt udało się uzyskać przy pomocy następującego kodu:
<TableRow
    android:layout_width="match_parent"
    android:layout_height="match_parent">

    <FrameLayout
        android:layout_width="110dp"
        android:layout_height="110dp">

        <ImageView
            android:layout_width="100dp"
            android:layout_height="100dp"
            android:layout_gravity="center_horizontal|center_vertical"
            android:src="@android:drawable/ic_dialog_map" />
    </FrameLayout>

    <TextView
        android:layout_width="wrap_content"
        android:layout_height="110dp"
        android:scrollHorizontally="false"
        android:text="Ut ac libero tincidunt, bibendum sem nec, pellentesque sem." />
</TableRow>
Czy tworzę TableRow i są w nim dwa elementy:
- FrameLayout, który w sobie zawiera ImageView z obrazem
- TextView, który zawiera opis pliku
Oczywiście kod ten w XMLu stworzyłem tylko po to, żeby zobaczyć, których elementów mam użyć, żeby uzyskać efekt jaki chcę. Sama lista plików z opisami będzie oczywiście tworzona dynamicznie w kodzie.
Jeden wiersz tworzyłem mniej więcej w poniższy sposób:
val filesLayout = findViewById(R.id.show_document_files_table).asInstanceOf[TableLayout]

val dim110 = (110 * this.getResources.getDisplayMetrics.density + 0.5f).toInt

val tableRow = new TableRow(this)
tableRow.setLayoutParams(new TableRow.LayoutParams(MATCH_PARENT, MATCH_PARENT))

val imageFrameLayout = new FrameLayout(this)
imageFrameLayout.setLayoutParams(new FrameLayout.LayoutParams(dim110, dim110))

val imageView: ImageView = new ImageView(this)
imageView.setImageBitmap(...)
val layoutParams = new LinearLayout.LayoutParams(thumbnail.getWidth, thumbnail.getHeight)
layoutParams.gravity = Gravity.CENTER_HORIZONTAL | Gravity.CENTER_VERTICAL
imageView.setLayoutParams(layoutParams)

imageFrameLayout.addView(imageView)

tableRow.addView(imageFrameLayout)

val fileDescription = new TextView(this)
fileDescription.setLayoutParams(new LinearLayout.LayoutParams(WRAP_CONTENT, dim110, 0.1f))
fileDescription.setText(...)

tableRow.addView(fileDescription)

filesLayout.addView(tableRow)
Tworząc elementy tabeli w kodzie starałem się tworzył dokładnie te same elementy z tymi samymi parametrami, które użyłem w XMLu. Niestety tworzenie wiersza tabeli w powyższy sposób powodował, że na ekranie nic się nie pojawiało – tabela zostawała pusta. Metodą prób i błędów próbowałem dojść do tego co jest nie tak i w końcu mi się udało.
Okazało się, że przy tworzeniu ustawień layouty, czyli tworząc obiekty LayoutParams musimy użyć LayoutParams z klasy rodzica danego elementu, a nie z samego elementu. Czyli w przypadku gdzie tworzyłem wiersz tabeli w poniższy sposób
val tableRow = new TableRow(this)
tableRow.setLayoutParams(new TableRow.LayoutParams(MATCH_PARENT, MATCH_PARENT))
wystarczyło zamienić na:
val tableRow = new TableRow(this)
tableRow.setLayoutParams(new TableLayout.LayoutParams(MATCH_PARENT, MATCH_PARENT))
Czyli użyć TableLayout.LayoutParams zamiast TableRow.LayoutParams, ponieważ TableLayout jest rodzicem naszego wiersza.
Po takich zmianach w kodzie ekran wyświelił elementy w taki sposób w jaki chciałem. Kod po modyfikacjach wyglada następująco:
val filesLayout = findViewById(R.id.show_document_files_table).asInstanceOf[TableLayout]

val dim110 = (110 * this.getResources.getDisplayMetrics.density + 0.5f).toInt

val tableRow = new TableRow(this)
tableRow.setLayoutParams(new TableLayout.LayoutParams(MATCH_PARENT, MATCH_PARENT))

val imageFrameLayout = new FrameLayout(this)
imageFrameLayout.setLayoutParams(new TableRow.LayoutParams(dim110, dim110))

val imageView: ImageView = new ImageView(this)
imageView.setImageBitmap(...)
val layoutParams = new FrameLayout.LayoutParams(thumbnail.getWidth, thumbnail.getHeight)
layoutParams.gravity = Gravity.CENTER_HORIZONTAL | Gravity.CENTER_VERTICAL
imageView.setLayoutParams(layoutParams)

imageFrameLayout.addView(imageView)

tableRow.addView(imageFrameLayout)

val fileDescription = new TextView(this)
fileDescription.setLayoutParams(new TableRow.LayoutParams(WRAP_CONTENT, dim110, 0.1f))
fileDescription.setText(...)

tableRow.addView(fileDescription)

filesLayout.addView(tableRow)
Artykuł Problem z GUI tworzonym w kodzie pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Artykuł Android Studio 2.1 i DEX 64K Methods Limit pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Po ściągnięciu i uruchomieniu konfiguracja poszła gładko. Wszystkie ustawienia zostały zaimportowane z poprzedniej wersji środowiska, więc wszystko praktycznie ogarniczało się do klikania 'Next’ i potwierdzenia przeczytania licencji
Po skończonej konfiguracji uruchomiłem aplikacje na emulatorze. Wszystko poszło bez przeszkód. Problemy pojawiły się gdy chciałem uruchomić aplikacje na realnym urządzeniu. Przy próbie kompilacji i uruchomienia apki pojawiają się poniższe błędy:
Error:The number of method references in a .dex file cannot exceed 64K.
Learn how to resolve this issue at https://developer.android.com/tools/building/multidex.html
Error:Execution failed for task ':app:transformClassesWithDexForDebug'.
> com.android.build.api.transform.TransformException: com.android.ide.common.process.ProcessException: java.util.concurrent.ExecutionException: com.android.ide.common.process.ProcessException: org.gradle.process.internal.ExecException: Process 'command 'C:\Program Files\Java\jdk1.8.0_45\bin\java.exe'' finished with non-zero exit value 2
:app:transformClassesWithDexForDebug FAILED
Android posiada ograniczenie 64k referencji metod. Gdy przekroczymy ten próg to pojawia się na powyższy bład.
Na GitHubie pluginu do scali dla androida jest opisany ten problem w punkcie 5. Jako rozwiązanie problemu zaproponowane są dwa podejścia.
- Użycie ProGuard, który usuwa nieużywane metody/kod przy kompilacji, dzięki czemu nie przekracamy wyżej wspomnianego limitu.
- Uzycie opcji MultiDex, która pozwala utworzyć aplikacji więcej niż jeden plik Dex.
Odniosę się może najpiew do podejścia drugiego. Aby uruchomić tą opcje wystarczy dodać do pliku gradle poniższy wpis:
multiDexEnabled true
I to podejście działa w Android Studio 2.1, ale nie ukrywam, że nie podoba mi się. Nie po to tworzę SIMPLE Document Manager, żeby zajmował dużo miejsca
Co do pierwszego podejścia, to ono działało w Android Studio 1.5 jak należy, natomiast przestało działać w Android Studio 2.1. Pokombinowałem trochę, szukałem w internecie i niestety nie udało mi się rozwiązać tego problemu. W związku z tym chcąc, nie chcąc, muszę póki co został przy Android Studio w wersji 1.5.
Artykuł Android Studio 2.1 i DEX 64K Methods Limit pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Artykuł Zapis danych na dysku pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Pierwszym krokiem jaki musimy zrobić to dodanie do pliku AndroidManifest.xml poniższego wpisu:
<uses-permission android:name="android.permission.WRITE_EXTERNAL_STORAGE" />
Jak można wywnioskować, jest to dodanie uprawnień do zapisu danych na pamięci zewnętrznej do naszej aplikacji.
Sam zapis pliku nie jest specjalnie skomplikowany. Stworzyłem prostą metodę, której zadaniem jest skopiowanie wskazane pliku do wskazanego miejsca.
def copyFile(src: File, dst: File) = {
  try {
    val inStream = new FileInputStream(src)
    val outStream = new FileOutputStream(dst)
    val inChannel = inStream.getChannel
    val outChannel = outStream.getChannel
    inChannel.transferTo(0, inChannel.size, outChannel)
    inStream.close()
    outStream.close()
  } catch {
    case e: Exception => Log.e(FileUtils.getClass.getSimpleName, e.getMessage, e)
  }
}
Dlaczego kopiowanie? W swojej aplikacji zapisuje dwa rodzaje plików:
- zrobione zdjęcia, które są zapisywane do pliku tymczasowego; właśnie ten plik kopiuje to folderu z dokumentami dla aplikacji
- pliki wskazane bezpośrednio przez użytkownika; w tym przypadku wskazany plik jest kopiowany do folderu z plikami aplikacji
Artykuł Zapis danych na dysku pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Artykuł SqLite – typy danych oraz zapis daty pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Dostępne typy danych w SqlLite to:
- INTEGER – służy do przechowywania liczb całkowitych; w zależności od wielkości wartości przechowywane są na 1, 2, 3, 4, 6 lub 8 bitach
- REAL – liczby zmiennoprzecinkowe
- TEXT- ciągi znaków
- BLOB – dane binarne
Jak widać nie ma tego za wiele, lecz wystarczająco, aby zapewnić nam wszystko czego potrzebujemy. Przynajmniej w większości wypadków
Chociaż po chwili zastanowienia… gdzie jest typ Date? Jak zapisywać datę? Tyle pytań bez odpowiedzi… Aż do teraz!
Data może być przechowywana w bazie danych w jednym z trzech formatów:
- TEXT – data jest zapisana w formacie ISO8601, czyli „YYYY-MM-DD HH:MM:SS.SSS”
- REAL – data jest zapisana jako liczba dni, które mineły od 24 listopada 4714 r. p.n.e., czyli tak zwana data Juliańska
- INTEGER – czas UNIXowy, czyli liczba milisekund, które mineły od 1 stycznia 1970r.
Do operacji na datach SqLite dostarcza 5 metod:
- date(timestring, …)
- time(timestring, …)
- datetime(timestring, …)
- julianday(timestring, …)
- strftime(format, timestring, …)
Pierwsze 4 funkcje przyjmują string jako pierwszy argument, a następnie dodatkowe argumenty. Funckja strftime przyjmuje jako pierwszy argument format daty, następnie wartość daty jako string oraz dodatkowe argumenty jako kolejne argumenty.
String opisujący date może być w jednym z poniższych formatów:
- YYYY-MM-DD
- YYYY-MM-DD HH:MM
- YYYY-MM-DD HH:MM:SS
- YYYY-MM-DD HH:MM:SS.SSS
- YYYY-MM-DDTHH:MM
- YYYY-MM-DDTHH:MM:SS
- YYYY-MM-DDTHH:MM:SS.SSS
- HH:MM
- HH:MM:SS
- HH:MM:SS.SSS
- now
- DDDDDDDDDD
Formaty od 1 do 4 wydają się być oczywiste. W formatach 5-7 występuję stały znak T, który służy jako separator daty i godziny. Formaty 8-10 służą do przechowywania samej godziny. Format 11 to string now, który odpowiada aktualnej dacie. Ostatni format jest to liczba zmiennoprzecinkowa opisująca date Juliańską.
Artykuł SqLite – typy danych oraz zapis daty pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Artykuł OrmLite – realizacja relacji wiele-do-wielu pochodzi z serwisu Lukasz Antkowiak's blog.
]]>OrmLite niestety nie wspiera relacji wiele-do-wielu, ale sama realizacja tego na szczęście nie jest trudna.
Zacznę od pokazania encji dla tabeli documents_tags.
@DatabaseTable(tableName = "documents_tags")
class DocumentTag {
  @DatabaseField(generatedId = true)
  var id: Int = _
  @DatabaseField(foreign = true, canBeNull = false)
  var document: Document = _
  @DatabaseField(foreign = true, canBeNull = false)
  var tag: Tag = _
}
Jak widać encja zawiera tylko 3 pola:
- id – id encji, które jest wymagane
- document – klucz obcy odnoszący się do dokumentu
- tag – klucz obcy odnoszący się do tagu
Encja tag wygląda następująco:
@DatabaseTable(tableName = "tags")
class Tag {
  @DatabaseField(generatedId = true)
  var id: Int = _
  @DatabaseField(canBeNull = false, unique = true)
  var name: String = _
}
Wydaję mi się, że tutaj nie ma nic do tłumaczenia
Encja dla dokumentu wygląda natomiast tak:
@DatabaseTable(tableName = "documents")
class Document {
  @DatabaseField(generatedId = true)
  var id: Int = _
  @DatabaseField(canBeNull = false)
  var title: String = _
  @DatabaseField(canBeNull = false)
  var createDate: Date = _
  @ForeignCollectionField(eager = false)
  var documentTags: ForeignCollection[DocumentTag] = _
  @ForeignCollectionField(eager = false)
  var documentFiles: ForeignCollection[DocumentFile] = _
}
Tutaj istotne jest następujące pole:
  @ForeignCollectionField(eager = false)
  var documentTags: ForeignCollection[DocumentTag] = _
Jak widać jest to 'obca’ kolekcja. Co będzie zawierała kolekcja po pobraniu dokumentu przy pomocy metody queryForId?
class DocumentDao(val dao: Dao[Document, Int]) extends RuntimeExceptionDao[Document, Int](dao) {
  def getDocumentById(documentId: Int): Document = {
    dao.queryForId(documentId)
  }
}
Otóż, jak można się domyślić, kolekcja ta będzie zawieraja liste encji DocumentTag powiązanych z dokumentem. Jest tylko jeden haczyk – pobrane encje DocumentTag nie zawierają 'całych’ obiektów, a jedynie ich id. Czyli np. instancja klasy Tag w pobranej kolekcji bedzie zawierała uzupełnione id, lecz pole name zawsze będzie puste.
Mając tą wiedze wystarczą dwa kroki do pobrania naszych tagów.
Po pierwsze musimy stworzyć metodę, która na podstawie listy id tagów, zwróci nam tagi.
def getTagsByIds(tagIds: List[Int]): List[Tag] = {
  dao.queryBuilder.where().in("id", tagIds.asJava).query().toList
}
A mając pobraną naszą encje możemy pobrać jej taki wywołując powyższą metodę w następujący sposób:
val tags: List[Tag] = tagDao.getTagsByIds(document.documentTags.map(t => t.tag.id).toList)
Jak widać pomimo braku jawnego wsparcia dla relacji wiele-do-wielu możemy sobie z tym w miarę ładny sposób poradzić
Artykuł OrmLite – realizacja relacji wiele-do-wielu pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Artykuł Tworzenie layoutu w Androidzie pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Stworzenie aktywności z menu rozwijanym z boku może wyglądać następująco.
activity_main.xml
<?xml version="1.0" encoding="utf-8"?>
<android.support.v4.widget.DrawerLayout xmlns:android="http://schemas.android.com/apk/res/android"
    xmlns:app="http://schemas.android.com/apk/res-auto"
    xmlns:tools="http://schemas.android.com/tools"
    android:id="@+id/drawer_layout"
    android:layout_width="match_parent"
    android:layout_height="match_parent"
    android:fitsSystemWindows="true"
    tools:openDrawer="start">

    <include
        layout="@layout/app_bar_main"
        android:layout_width="match_parent"
        android:layout_height="match_parent" />

    <android.support.design.widget.NavigationView
        android:id="@+id/nav_view"
        android:layout_width="wrap_content"
        android:layout_height="match_parent"
        android:layout_gravity="start"
        android:fitsSystemWindows="true"
        app:headerLayout="@layout/nav_header"
        app:menu="@menu/activity_drawer" />

</android.support.v4.widget.DrawerLayout>
app_bar_main.xml
<?xml version="1.0" encoding="utf-8"?>
<android.support.design.widget.CoordinatorLayout xmlns:android="http://schemas.android.com/apk/res/android"
    xmlns:fab="http://schemas.android.com/apk/res-auto"
    xmlns:tools="http://schemas.android.com/tools"
    android:layout_width="match_parent"
    android:layout_height="match_parent"
    android:fitsSystemWindows="true"
    tools:context="pl.lantkowiak.sdm.MainActivity">

    <android.support.design.widget.AppBarLayout
        android:layout_width="match_parent"
        android:layout_height="wrap_content"
        android:theme="@style/AppTheme.AppBarOverlay">

        <android.support.v7.widget.Toolbar
            android:id="@+id/toolbar"
            android:layout_width="match_parent"
            android:layout_height="?attr/actionBarSize"
            android:background="?attr/colorPrimary"
            fab:popupTheme="@style/AppTheme.PopupOverlay" />

    </android.support.design.widget.AppBarLayout>

    <include layout="@layout/content_main" />

</android.support.design.widget.CoordinatorLayout>
content_main.xml
<?xml version="1.0" encoding="utf-8"?>
<RelativeLayout xmlns:android="http://schemas.android.com/apk/res/android"
    xmlns:app="http://schemas.android.com/apk/res-auto"
    xmlns:tools="http://schemas.android.com/tools"
    android:layout_width="match_parent"
    android:layout_height="match_parent"
    android:paddingBottom="@dimen/activity_vertical_margin"
    android:paddingLeft="@dimen/activity_horizontal_margin"
    android:paddingRight="@dimen/activity_horizontal_margin"
    android:paddingTop="@dimen/activity_vertical_margin"
    app:layout_behavior="@string/appbar_scrolling_view_behavior"
    tools:context="pl.lantkowiak.sdm.MainActivity"
    tools:showIn="@layout/app_bar_main">

...

</RelativeLayout>
Wydaję mi się, że tworzenie elementów layoutu jest na tyle intuicyjne, że nie będę szczegółowo opisywał co się dokładnie dzieje w powyższych listingach.
Jest jednak jednak jedna rzecz, na którą chciałbym zwrócić uwagę. Wewnątrz activity_main.xml umieszczany jest app_bar_main.xml, wewnątrz którego umieszczony jest content_main.xml.
Pierwsze dwa pliki są odpowiedzialne za tworzenie aktywności z bocznym menu, natomiast trzeci plik – content_main.xml – zawiera layout specyficzny dla konkretnego ekranu.
I teraz pojawia się problem, którego nie udało mi się rozwiązać w elegancki sposób.
Tworzę drugą aktywność, która ma zawierać to samo menu, lecz sam ekran ma mieć inną zawartość. I teraz, żeby to zrobić muszę skopiować dwa pierwsze layouty odpowiedzialne za menu, zmienić nazwy plików i wartości atrybutów w samych plikach. Podejście to oczywiście działa, lecz generuje sporo plików, które są praktycznie identyczne.
Rzeczą, która by się tutaj mogła przydać byłaby możliwość podania parametrów, które były by przekazywane do załączanego layoutu. Mam na myśli rozwiązanie podobne do tego, które jest dostępne np. w JSF.
Niestety, póki co nie udało mi się znaleźć rozwiązania tego problemu i w związku z tym, póki co zostaje z moim rozwiązaniem.
Artykuł Tworzenie layoutu w Androidzie pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Artykuł Ciekawy problem z ORMLite pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Podczas próby aktualizacji encji
DocumentFile
otrzymałem poniższy błąd:
pl.lantkowiak.sdm E/AndroidRuntime: FATAL EXCEPTION: main
java.lang.RuntimeException: java.sql.SQLException: Cannot update class pl.lantkowiak.sdm.core.entity.DocumentFile because it doesn't have an id field
 at com.j256.ormlite.dao.RuntimeExceptionDao.update(RuntimeExceptionDao.java:264)
 at pl.lantkowiak.sdm.activities.EditDocumentActivity$$anonfun$updateFiles$2.apply(EditDocumentActivity.scala:134)
 at pl.lantkowiak.sdm.activities.EditDocumentActivity$$anonfun$updateFiles$2.apply(EditDocumentActivity.scala:130)
 at scala.collection.mutable.ResizableArray$class.foreach(ResizableArray.scala:59)
 at scala.collection.mutable.ArrayBuffer.foreach(ArrayBuffer.scala:48)
 at pl.lantkowiak.sdm.activities.EditDocumentActivity.updateFiles(EditDocumentActivity.scala:130)
 at pl.lantkowiak.sdm.activities.EditDocumentActivity.updateDocument(EditDocumentActivity.scala:101)
 at pl.lantkowiak.sdm.activities.EditDocumentActivity.onOptionsItemSelected(EditDocumentActivity.scala:45)
 at android.app.Activity.onMenuItemSelected(Activity.java:2566)
 at android.support.v4.app.FragmentActivity.onMenuItemSelected(FragmentActivity.java:404)
 at android.support.v7.app.AppCompatActivity.onMenuItemSelected(AppCompatActivity.java:167)
 at android.support.v7.view.WindowCallbackWrapper.onMenuItemSelected(WindowCallbackWrapper.java:100)
 at android.support.v7.app.AppCompatDelegateImplV7.onMenuItemSelected(AppCompatDelegateImplV7.java:646)
 at android.support.v7.view.menu.MenuBuilder.dispatchMenuItemSelected(MenuBuilder.java:811)
 at android.support.v7.view.menu.MenuItemImpl.invoke(MenuItemImpl.java:152)
 at android.support.v7.view.menu.MenuBuilder.performItemAction(MenuBuilder.java:958)
 at android.support.v7.view.menu.MenuBuilder.performItemAction(MenuBuilder.java:948)
 at android.support.v7.widget.ActionMenuView.invokeItem(ActionMenuView.java:618)
 at android.support.v7.view.menu.ActionMenuItemView.onClick(ActionMenuItemView.java:139)
 at android.view.View.performClick(View.java:4209)
 at android.view.View$PerformClick.run(View.java:17431)
 at android.os.Handler.handleCallback(Handler.java:725)
 at android.os.Handler.dispatchMessage(Handler.java:92)
 at android.os.Looper.loop(Looper.java:153)
 at android.app.ActivityThread.main(ActivityThread.java:5297)
 at java.lang.reflect.Method.invokeNative(Native Method)
 at java.lang.reflect.Method.invoke(Method.java:511)
 at com.android.internal.os.ZygoteInit$MethodAndArgsCaller.run(ZygoteInit.java:833)
 at com.android.internal.os.ZygoteInit.main(ZygoteInit.java:600)
 at dalvik.system.NativeStart.main(Native Method)
Caused by: java.sql.SQLException: Cannot update class pl.lantkowiak.sdm.core.entity.DocumentFile because it doesn't have an id field
 at com.j256.ormlite.stmt.mapped.MappedUpdate.build(MappedUpdate.java:33)
 at com.j256.ormlite.stmt.StatementExecutor.update(StatementExecutor.java:402)
 at com.j256.ormlite.dao.BaseDaoImpl.update(BaseDaoImpl.java:350)
 at com.j256.ormlite.dao.RuntimeExceptionDao.update(RuntimeExceptionDao.java:261)
 at pl.lantkowiak.sdm.activities.EditDocumentActivity$$anonfun$updateFiles$2.apply(EditDocumentActivity.scala:134)
 at pl.lantkowiak.sdm.activities.EditDocumentActivity$$anonfun$updateFiles$2.apply(EditDocumentActivity.scala:130)
 at scala.collection.mutable.ResizableArray$class.foreach(ResizableArray.scala:59)
 at scala.collection.mutable.ArrayBuffer.foreach(ArrayBuffer.scala:48)
 at pl.lantkowiak.sdm.activities.EditDocumentActivity.updateFiles(EditDocumentActivity.scala:130)
 at pl.lantkowiak.sdm.activities.EditDocumentActivity.updateDocument(EditDocumentActivity.scala:101)
 at pl.lantkowiak.sdm.activities.EditDocumentActivity.onOptionsItemSelected(EditDocumentActivity.scala:45)
 at android.app.Activity.onMenuItemSelected(Activity.java:2566)
 at android.support.v4.app.FragmentActivity.onMenuItemSelected(FragmentActivity.java:404)
 at android.support.v7.app.AppCompatActivity.onMenuItemSelected(AppCompatActivity.java:167)
 at android.support.v7.view.WindowCallbackWrapper.onMenuItemSelected(WindowCallbackWrapper.java:100)
 at android.support.v7.app.AppCompatDelegateImplV7.onMenuItemSelected(AppCompatDelegateImplV7.java:646)
 at android.support.v7.view.menu.MenuBuilder.dispatchMenuItemSelected(MenuBuilder.java:811)
 at android.support.v7.view.menu.MenuItemImpl.invoke(MenuItemImpl.java:152)
 at android.support.v7.view.menu.MenuBuilder.performItemAction(MenuBuilder.java:958)
 at android.support.v7.view.menu.MenuBuilder.performItemAction(MenuBuilder.java:948)
 at android.support.v7.widget.ActionMenuView.invokeItem(ActionMenuView.java:618)
 at android.support.v7.view.menu.ActionMenuItemView.onClick(ActionMenuItemView.java:139)
 at android.view.View.performClick(View.java:4209)
 at android.view.View$PerformClick.run(View.java:17431)
 at android.os.Handler.handleCallback(Handler.java:725)
 at android.os.Handler.dispatchMessage(Handler.java:92)
 at android.os.Looper.loop(Looper.java:153)
 at android.app.ActivityThread.main(ActivityThread.java:5297)
 at java.lang.reflect.Method.invokeNative(Native Method)
 at java.lang.reflect.Method.invoke(Method.java:511)
 at com.android.internal.os.ZygoteInit$MethodAndArgsCaller.run(ZygoteInit.java:833)
 at com.android.internal.os.ZygoteInit.main(ZygoteInit.java:600)
 at dalvik.system.NativeStart.main(Native Method)
Błąd sugeruje, że encja ta nie posiada pola id. Sama encja wyglądała tak:
@DatabaseTable(tableName = "documentFiles")
class DocumentFile {
  @DatabaseField(generatedId = true)
  var id: Int = _
  @DatabaseField(canBeNull = false)
  var createDate: Date = _
  @DatabaseField(canBeNull = false)
  var filename: String = _
  @DatabaseField(canBeNull = false)
  var extension: String = _
  @DatabaseField(canBeNull = false)
  var mime: String = _
  @DatabaseField(canBeNull = false)
  var description: String = _
  @DatabaseField(foreign = true, canBeNull = false)
  var document: Document = _
}
Encja oczywiście zawierała pole id, a sam zapis encji do bazy danych odbył się bez problemu.
Zanim przejdę do mojego rozwiązania to chciałbym odnieść się do znaku _, który występował przy kazdym polu, np:
@DatabaseField(generatedId = true)
var id: Int = _
Idąc za dokumentacją języka:
A variable definition var x: T = _ can appear only as a member of a template. It introduces a mutable field with type T and a default initial value. The default value depends on the type T as follows:
0 if T is Int or one of its subrange types,
0L if T is Long,
0.0f if T is Float,
0.0d if T is Double,
false if T is Boolean,
() if T is Unit,
null for all other types T .
Czyli w przypadku pola id powinno do niego zostać przypisane domyślnie 0.
Wracając do mojego rozwiązania problemu. Jedyną zmianą, którą zrobiłem w moim kodzie to poniższa modyfikacja.
@DatabaseField(generatedId = true)
var id: Int = 0
Jak widać bezpośrednie przypisanie 0 do pola id pomogło z rozwiązaniem problemu.
Artykuł Ciekawy problem z ORMLite pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Artykuł Robienie zdjęc w aplikacji pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Na początku musimy ustalić miejsce gdzie zdjęcie zostanie zapisane. Robię to w poniższy sposób:
private def getOutputMediaFile: File = {
  val mediaStorageDir: File = new File(Environment.getExternalStorageDirectory, ".temp")
  if (!mediaStorageDir.exists) {
    if (!mediaStorageDir.mkdirs) {
      Log.e(".temp", "failed to create directory")
      return null
    }
  }
  fileId = System.currentTimeMillis.toString
  new File(mediaStorageDir, File.separator + fileId + ".jpg")
}
Na początku tworzę folder „.temp”, do którego zostanie zapisane zrobione zdjęcie. Następnie tworzymy obiekt File, wskazujący dokladnie na plik, do którego ma nastąpić zapis.
Następnym krokiem jest stworzenie obiektu Uri, który będzie wskazywał na wcześniej stworzony plik:
private def getOutputMediaFileUri: Uri = {
  Uri.fromFile(getOutputMediaFile)
}
Wywołanie samej akcji odpowiedzialnej za robienie zdjęcia wygląda następująco:
def takePhotoOnClickAction(view: View): Unit = {
  val intent: Intent = new Intent(MediaStore.ACTION_IMAGE_CAPTURE)

  val tempUri: Uri = getOutputMediaFileUri
  intent.putExtra(MediaStore.EXTRA_OUTPUT, tempUri)

  tempFile = new File(tempUri.getPath)

  startActivityForResult(intent, takePhotoRequestCode)
}
gdzie
takePhotoRequestCode
jest stałą definiującą kod tej akcji, a
tempFile
jest polem klasy i będzie przechowywać ścieżkę do zrobionego zdjęcia.
Po zrobieniu zdjęcia i zatwierdzeniu go wywoływana jest poniższa metoda:
protected override def onActivityResult(requestCode: Int, resultCode: Int, data: Intent) {
  if (requestCode == takePhotoRequestCode && resultCode == RESULT_OK) {
    // tempFile points to the taken photo
  }
}
Po sprawdzeniu czy requestCode jest zgodny z kodem naszej akcji oraz operacja jest zakończona sukcesem to wtedy możemy zająć się przetwarzaniem wykonanego zdjęcia.
Artykuł Robienie zdjęc w aplikacji pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Artykuł Android file chooser dialog pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Postanowiłem bazować na file chooser’ze zaimplementowanym przez Rogera Keaysa. Jest on dostępny pod poniższym adresem: https://rogerkeays.com/simple-android-file-chooser.
Moja implementacja wygląda w następujący sposób:
class FileChooser(val activity: Activity, val fileListener: FileSelectedListener, val maxFileSize: Double) {
  private lazy val messageMaker = wire(classOf[MessageMaker])
  private val parentDir = ".."
  private val mb = 1024.0 * 1024.0
  private val dialog = new Dialog(activity)
  private val list = new ListView(activity)
  private var currentPath: File = _

  list.setOnItemClickListener(new AdapterView.OnItemClickListener() {
    override def onItemClick(parent: AdapterView[_], view: View, position: Int, id: Long): Unit = {
      val fileChosen: String = list.getItemAtPosition(position).asInstanceOf[String]
      val chosenFile: File = getChosenFile(fileChosen)
      if (chosenFile.isDirectory) {
        refresh(chosenFile)
      }
      else {
        val sizeInMB: Double = chosenFile.length / mb
        if (sizeInMB > maxFileSize) {
          messageMaker.info("Selected file is too large")
        }
        else {
          if (fileListener != null) {
            fileListener.fileSelected(chosenFile)
          }
          dialog.dismiss()
        }
      }
    }
  })
  dialog.setContentView(list)
  dialog.getWindow.setLayout(MATCH_PARENT, MATCH_PARENT)
  refresh(Environment.getExternalStorageDirectory)

  def showDialog() {
    dialog.show()
  }

  /**
   * Sort, filter and display the files for the given path.
   */
  private def refresh(path: File) {
    this.currentPath = path
    if (path.exists) {
      val dirs: Array[File] = path.listFiles(new FileFilter() {
        def accept(file: File): Boolean = {
          file.isDirectory && file.canRead
        }
      })
      val files: Array[File] = path.listFiles(new FileFilter() {
        def accept(file: File): Boolean = {
          !file.isDirectory && file.canRead
        }
      })
      dirs.sortWith(_.getName > _.getName)
      files.sortWith(_.getName > _.getName)

      // convert to an array
      val i: Int = 0
      var fileList = ArrayBuffer[String]()

      if (path.getParentFile != null) {
        fileList += parentDir
      }
      dirs.foreach(d => fileList += d.getName)
      files.foreach(f => fileList += f.getName)

      // refresh the user interface
      dialog.setTitle(currentPath.getPath)
      list.setAdapter(new ArrayAdapter(activity, android.R.layout.simple_list_item_1, fileList.toArray) {
        override def getView(pos: Int, view: View, parent: ViewGroup): View = {
          val superView = super.getView(pos, view, parent)
          superView.asInstanceOf[TextView].setSingleLine(true)
          superView
        }
      })
    }
  }

  private def getChosenFile(fileChosen: String): File = {
    if (fileChosen == parentDir) {
      currentPath.getParentFile
    }
    else {
      new File(currentPath, fileChosen)
    }
  }
}
trait FileSelectedListener {
  def fileSelected(file: File)
}
Główną zmianą (oczywiście poza napisaniem tego w języku Scala) jest dodanie ograniczenia na maksymalną wielkość pliku. Po wyborze pliku, jeżeli jego rozmiar przekracza ustawiony maksymalny rozmiar to zostaje wyświetlony komunkat z informacją, a plik nie zostaje dodany.
Artykuł Android file chooser dialog pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Artykuł ORM w Androidzie pochodzi z serwisu Lukasz Antkowiak's blog.
]]>
Po napisaniu kilku insertów, selectów itd. stwierdziłem jednak, że odrobina pomocy od strony jakiegoś framework’u nie zaszkodzi
Po przejrzeniu dostępnych frameworków wybrałem ORMLite. Cytując opis ze strony:
Object Relational Mapping Lite (ORM Lite) provides some simple, lightweight functionality for persisting Java objects to SQL databases while avoiding the complexity and overhead of more standard ORM packages.
Jedyną funkcjonalnością (przynajmniej na ten moment), której brakuje mi w ORMLite to wpieranie relacji many-to-many. No ale jak to mówią – nie można mieć wszystkiego
Sama konfiguracja była dosyć łatwa. Pierwszym krokiem jest dodanie zależności do gradle:
'com.j256.ormlite:ormlite-android:4.45'
Dalej już pozostało tylko stworzyć encje:
@DatabaseTable(tableName = "documents")
class Document {
  @DatabaseField(generatedId = true)
  var id: Int = _
  @DatabaseField(canBeNull = false)
  var title: String = _
  @DatabaseField(canBeNull = false)
  var createDate: Date = _
}
DAO dla naszej encji:
class DocumentDao(val dao: Dao[Document, Integer]) extends RuntimeExceptionDao[Document, Integer](dao) {
  def getAllDocuments: List[Document] = {
    dao.queryForAll().toList
  }
}
DAO rozszerza klase RuntimeExceptionDao. Zaimplementowałem to w ten sposób ponieważ podstawowe DAO dostarczane przez ORMLite wymaga obsługi java.sql.SQLException, który może zostać rzucony przez każdą metodę DAO. RuntimeExceptionDao (jak sama nazwa wskazuje) rzucza RuntimeException zamiast wspomnianego wczesniej SQLException.
Jeszcze jedną rzeczą, na którą warto zwrócić uwagę to poniższa linijka:
dao.queryForAll().toList
Metoda queryForAll() zwraca java.util.List. Aby przekonwertować to na liste Scala’ową wystarczy na tej liście wywołać metodę toList.
Kolejnym krokiem jest implementacja klasy rozszerzająca OrmLiteSqliteOpenHelper. Moja implementacja wygląda następująco:
class OrmDatabaseHelper(val context: Context) extends OrmLiteSqliteOpenHelper(context, DbConstants.DatabaseName, null, DbConstants.DatabaseVersion) {
  override def onUpgrade(database: SQLiteDatabase, connectionSource: ConnectionSource, oldVersion: Int, newVersion: Int): Unit = {
    TableUtils.createTable(connectionSource, classOf[Document])
  }

  override def onCreate(database: SQLiteDatabase, connectionSource: ConnectionSource): Unit = {}
}
Mamy dwie metody – jedna jest wywoływana przy tworzeniu bazy danych, a druga w momencie jej upgrade’u. Przy tworzeniu bazy danych używamy metody statycznej
TableUtils.createTable(connectionSource, classOf[Document])
I ostatnią rzeczą, którą musimy zrobić to utworzenie instancji DAO, których będziemy używać. Aby to zrobić musimy tylko wywołać metodę OrmDatabaseHelper.getDao(Class<T>), a zwrócone DAO przekazać jako parametr konstruktora dla RuntimeExceptionDao.
Artykuł ORM w Androidzie pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Artykuł Problem ze starą wersją pluginu do Androida pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Po utworzeniu grafiki wektorowej otrzymałem poniższy komunikat od IDE:
<vector> requires API level 21 (current min is 15) or building with Android Gradle plugin 1.4 or higherPo szybkim googlowaniu znalazłem informacje o zmianach w api pomiędzy wersjami pluginu com.android.tools.build.
Na szczęście nie byłem też pierwszą osobą, która miała ten problem. Na GitHubie powstał osobny branch, który zawiera poprawki umożliwiające współprace tego pluginu z najnowszą wersją pluginu do Androida. Wystarczyło skompilować plugin ściągnięty z tego brancha oraz zamienić wpis
classpath "jp.leafytree.gradle:gradle-android-scala-plugin:1.4"
na poniższy
classpath files('lib/gradle-android-scala-plugin-1.5.jar')
w pliku build.gradle.
Artykuł Problem ze starą wersją pluginu do Androida pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Artykuł Dependency Injection – część druga pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Wszystkie zmiany, które zrobiłem w modyfikacji mojej wersji DI dokonałem we wcześniej wspomnianym obiekcie ApplicationModule.
Poniżej przedstawiam listing tego obiektu.
object ApplicationModule {
  private val instances = collection.mutable.Map[Class[_], (()=>Any, Any)]()

  {
    instances.put(classOf[DocumentDao], (documentDAO(), null))
  }

  def wire[T](clazz: Class[T]): T = {
    val tuple: Option[(() => Any, Any)] = instances.get(clazz)
    if (tuple.get._2 == null) {
      instances.put(clazz, tuple.get.copy(_2 = tuple.get._1.apply()))
    }

    instances.get(clazz).get._2.asInstanceOf[T]
  }

  private def documentDAO(): () => DocumentDao = {
    () => new DocumentDaoBean(ApplicationContext.getAppContext)
  }
}
Zmiany, których dokonałem to:
- Mapa
Wcześniej mapa przechowywała pary Klasa-Instancja. W obecnej implementacji mapa zawiera pary Klasa na krotkę zawierającą funkcje oraz instancje. Dokładniej mówiąc krotka zawiera funkcje tworzącą daną instancje na konkretną instancje klasy. - Metoda tworząca instancje wstrzykiwanej klasy
Wcześniej metoda zwracała nową instancje danej klasy. W chwili obecnej zwraca funkcje bezparametrową, która po wywołaniu stworzy instancje klasy. - Blok inicjalizacyjny
Do mapy wsadzamy wszystkie pary Klasa-Krotka, których będizemy chcieli używać. Jako drugą wartość krotki ustawiamy null, ponieważ nie chcemy jeszcze tworzyć instancji klasy. - Metoda wire
We wcześniejszym podejściu metoda ta pobierała z mapy instancje żądanej klasy i ją zwracała. W chwili obecnej sprawdzamy czy druga wartość krotki dla żądanej klasy jest null’em. Jeżeli jest to tworzymy nową instancje żądanej klasy i ja zapisujemy w mapie, a następnie zwracamy stworzoną instancje. W przypadku gdy druga wartość krotki nie jest null’em to oczywiście oznacza, że instancja została stworzona wcześniej i właśnie ona zostanie zwrócona.
Artykuł Dependency Injection – część druga pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Artykuł Dependency Injection w Androidzie pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Po szybkich poszukiwaniach natrafiłem na framework Dagger. Framework ten jest przystosowany do użycia go w aplikacjach mobilnych. Dagger działa inaczej niż większość frameworków DI, które działają na refleksjach. Dagger tworzy klasy, które będzie wstrzykiwał, na etapie kompilacji. Podejście to tworzy pewne ograniczenia, lecz jest szybsze i mniej pamięciożerne, co jest zdecydowanie przydatne w przypadku aplikacji mobilnych.
Po tym wyborze przystąpiłem do konfiguracji frameworka, lecz naszła mnie pewna myśl… Moja aplikacja będzie dosyć prosta. Czy faktycznie potrzebuję frameworka DI? Po chwili namysłu stwierdziłem, że samodzielnie stworzę coś na wzór frameworka DI. Oczywiście prostszego i bardziej ubogiego ale mam nadzieję, że wystarczającego
Podszedłem do tego w następujący sposób:
- Stworzyłem w Javie klasę dziedziczącą po klasie Application, ze statycznym dostępem do contextu.
public class ApplicationContext extends Application {

    private static Context context;

    public void onCreate() {
        super.onCreate();
        context = getApplicationContext();
    }

    public static Context getAppContext() {
        return context;
    }
}
W Scali nie są dostępne metody statyczne w klasach, a Object Scalowy nie mógłby być zainicjalizowany przez system. W związku z tym byłem zmuszony stworzyć powyższą klasę Javową, aby zyskać dostęp do kontekstu aplikacji.
- Dodałem odniesienie do powyższej klasy w pliku AndroidMnifest.xml w atrybucie android:name dla tagu application. Wygląda to mniej więcej tak:
<manifest xmlns:android="http://schemas.android.com/apk/res/android" package="pl.lantkowiak.sdm"> ... <application ... android:name="pl.lantkowiak.sdm.di.ApplicationContext"> ... </application> </manifest> - Stworzyłem obiekt, w którym tworzone są instancje, które będą 'wstrzykniętę’ oraz metodę służącą do pobrania tych instancji.
object ApplicationModule {
  private val instances = collection.mutable.Map[Class[_], Any]()

  {
    instances.put(classOf[DocumentDao], documentDAO())
  }

  def wire[T](clazz: Class[T]): T = {
    instances.get(clazz).asInstanceOf[Some[T]].get
  }

  private def documentDAO(): DocumentDao = {
    new DocumentDaoBean(ApplicationContext.getAppContext)
  }
}
Obiekt zawiera w sobie mapę, która zawiera mapowanie klasy na jej instancje. Mapa ta jest uzupełniania w bloku inizjalizującym – tutaj będę musiał dodać wszystkie klasy wraz z instancjami, do których będę chciał mieć dostęp w ten sposób.
Metoda wire pobiera instancje z mapy oraz ją zwraca. - Samo 'wstrzyknięcię’ robimy w poniższy sposób:
private lazy val documentDao = wire(classOf[DocumentDao])
Oczywiście powyższe podejscie będzię wstrzykiwać zawsze tą samą instancje, lecz na potrzeby mojej aplikacji powinno być to całkowicie wystarczające.
Artykuł Dependency Injection w Androidzie pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Artykuł Opis ekranów i funkcjonalności aplikacji cz. 1 pochodzi z serwisu Lukasz Antkowiak's blog.
]]>- Ekran startowy

Ekran startowy będzię się składał z 3 części:
1. Szybka wyszukiwarka
Na podstawie wpisanych tagów zostaną wyszukane dodane wcześniej dokumenty i wyświetlone w polu 2.
2. Lista dokumentów
Obszar 2. będzię zawierał listę ostatnich dodanych dokumentów. Po wpisaniu tagów i kliknięciu przycisku 'Find’ z obszaru 1. zostaną wyświetlone dokumenty pasujące do zapytania.
3. Button przekierowujący do ekranu odpowiadającego za dodawanie dokumentu. - Dodawanie dokumentu
 1. Anulowanie operacji i powrót do poprzedniego ekranu
2. Zapis tworzonego dokumentu. Przy zapisie będzię dodana walidacja:
– pola title oraz tags nie mogą być puste
– conajmniej jeden plik/zdjęcie zostały dodane
3. Tytuł dokumentu
4. Tagi przypisane do dokumentu – oddzielone spacjami
5. Dodanie pliku do dokumentu. Plik będzię wybierany z systemu plików w telefonie.
6. Zrobienie zdjęcia i dodanie go do dokumentu.
7. Przycisk rozwijający opcje 5 i 6.
Artykuł Opis ekranów i funkcjonalności aplikacji cz. 1 pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Artykuł Integracja języka Scala z Android Studio pochodzi z serwisu Lukasz Antkowiak's blog.
]]>- Scala plugin
Plugin wymagany przez Android Studio, aby móc poprawnie wspierać język Scala. Najłatwiejsza i najbardziej intuicyjna część konfiguracji - Gradle plugin
Jako plugin do gradle znalazłem/wybrałem gradle-android-scala-plugin, który jest opisany tutaj: https://github.com/saturday06/gradle-android-scala-plugin. Niestety plugin ten nie działa z najnowszą wersją com.android.tools.build (1.5.0). Przy próbie zbudowania projektu z tą wersją pojawia się poniższy błąd
Error:No such property: bootClasspath for class: com.android.builder.core.AndroidBuilder - JUnit
Konfiguracja testów jednostkowych była dosyć prosta. Poniżej zamieszczam prosty przykład testu.
Jedyny problem, który napotkałem pojawił się przy próbie użycia AssertJ, którego używam w codziennej pracy. Niestety biblioteka ta nie jest przystosowana do pracy Android SDK. -
package pl.lantkowiak.sdm

import org.scalatest.{Matchers, FlatSpec}

class ExampleScalaUnitTest extends FlatSpec with Matchers {
  "addition" should "be correct" in {
    2 + 2 should be(4)
  }
}
Artykuł Integracja języka Scala z Android Studio pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Artykuł Przechowywanie danych w aplikacji pochodzi z serwisu Lukasz Antkowiak's blog.
]]>W aplikacji będę musiał przechowywać dane na dwa sposoby:
- W bazie danych
Android na szczęście dostarcza nam SQLite. Jak można wywnioskować z nazwy jest to baza danych z 'lekko’ okrojoną funkcjonalnością, ale na szczęście do moich zastosowań jest to całkowicie wystarczające.
Poniżej przedstawiam wstępny schemat bazy danych, który zastosuję w menadżerze dokumentów.

- document – tabela przechowująca informacje o dodanych dokumentach
- tag – tagi, które zostały dodane do dokumentów podczas ich tworzenia
- document_tag – tabela pomocnicza dla relacji many-to-many
- document_file – table zawierająca informacje o plikach/zdjęciach dodany do danego dokumentu
Na początku chciałem wykorzystać ORM przy zarządzaniu wpisami w bazie danych, lecz mając na uwadze wielkość oraz stopień skomplikowania bazy danych sądzę, że jest to zbędnę.
- W pamięci urządzenia
Wszystkie dodane pliki oraz zdjęcia, które będą powiązane z dodawanymi dokumentami będą musiały znaleźć swoje miejsce w pamięci urządzenia lub na karcie SD
Artykuł Przechowywanie danych w aplikacji pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Artykuł Kilka słów o aplikacji pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Szukałem aplikacji na androida, która by mi pomogła w przechowywaniu elektronicznych kopii takich dokumentów oraz umożliwiła dostęp do nich w każdym momencie.
Niestety nie udało mi się znaleźć aplikacji, która by spełniała wszystkie moje wymagania. Ale jak to się mówi – nie ma tego złego, co by na dobre nie wyszło. Brak takiej aplikacji jest świetnym powodem, żeby napisać swój pierwszy program na Androida
Planowałem na początku napisać aplikację w Javie, ale po na myślę stwierdziłem, że spróbuję napisać ją w Scali. Jak szaleć to szaleć! Nie mam doświadczenia w pisaniu aplikacji w Scali, więc jest to również dobra okazja, żeby poduczyć się trochę nowego języka.
Aplikacja, którą chcę napisać, powinna spełniać następujące wymagania:
- Jako dokumenty mogą być przechowywanie zarówno zdjęcia zrobione aparatem, jak i dokumenty załadowane z systemu plików
- Dokumenty mogą być wyszukiwane po tagach
- Pliki powinny być synchronizowane z Google Drive
Są to główne założenia, które traktuje jako minimum, żeby aplikacja była użyteczna.
W trakcie pisania pewnie będę sobie przypominał/zmieniał/dodawał nowe wymagania, aby zrobić aplikację jak najbardziej użyteczną i wygodną w użyciu.
Artykuł Kilka słów o aplikacji pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Artykuł Daję się poznać! pochodzi z serwisu Lukasz Antkowiak's blog.
]]>Strona powstała w ramach mojego udziału w konkursie Daj się poznać.
Aplikcja, którą zdecydowałem się stworzyć to prosty menadżer dokumentów na Androida. Jej kod będzię dostępny tutaj.
Od jakiegoś czasu chodziło za mną, aby stworzyć taki menadżer, który będzie dostosowany do moich potrzeb, a dodatkowo stworzyć swoją pierwszą aplikację na system Android. Jak się pojawiła przy okazji możliwość wzięcia udziału w konkursie jako dodatkowa motywacja, pomyślałem, że warto spróbować.
Mam nadzieję, że uda mi się dotrwać do końca konkursu, szczególnie z blogowaniem, co będzie dla mnie największym wysiłkiem
Serdecznie zapraszam do wszelkich komentarzy.
pozdrawiam serdecznie
Łukasz Antkowiak
Artykuł Daję się poznać! pochodzi z serwisu Lukasz Antkowiak's blog.
]]>