The post Wissen gegen die Angst: Ein Blick in den genetischen Inhalt des SARS-CoV-2 mRNA Impfstoffes first appeared on BioinfoWelten.
]]>Stattdessen möchte ich euch lieber auf eine bioinformatische Reise mitnehmen, und den genetischen Inhalt des Impfstoffes genau unter die Lupe nehmen. Ich bin über diese wirklich großartige Zusammenfassung von Bert Hubert gestolpert, der die fantastischen Tricks und Kniffe beschreibt, die für die Wirksamkeit des Impfstoffes sorgen. Und beim Lesen des Beitrags wurde mir einmal mehr bewusst: „Wissenschaft ist sooooo cool!“
Vermutlich habt ihr bereits mitbekommen, dass es sich bei dem BioNTech/Pfizer SARS-CoV-2 Impfstoff um einen mRNA Impfstoff handelt. mRNA steht kurz für messenger RNA (im Deutschen auch Boten-RNA genannt). Eine mRNA ist sozusagen eine Kopie, die von einem Gen auf unserer DNA gemacht wird, um die Information aus dem Zellkern (wo sich die DNA befindet) in die Zelle transportieren zu können, wo sie als Bauanleitung für ein bestimmtes Protein fungiert.
Bert Hubert nutzt in seinem Beitrag einen schönen Vergleich: Er beschreibt die DNA als Festplattenspeicher unseres Körpers: widerstandsfähig, redundant, ausfallsicher, zuverlässig. Die RNA hingegen ist die flüchtige „Arbeitsspeicher“-Variante der DNA: schneller und vielseitiger, aber eben auch fragiler und anfälliger. Daher muss der Pfizer/BioNTech mRNA Impfstoff bei Tiefsttemperaturen gelagert werden. Andererseits haben mRNA Impfstoffe den Vorteil, dass eine große Anzahl Impfdosen innerhalb weniger Wochen hergestellt werden kann.
Das nötige Hintergrundwissen

Bioinformatiker sehen DNA und RNA ja nicht als komplexe Moleküle, sondern als simple Zeichenketten. Und deswegen werden wir die Zeichenkette des mRNA Impfstoffs (und was sie so besonders macht) genauer unter die Lupe nehmen. Für ein wenig Hintergrundwissen über DNA, RNA, Nukelobasen, Proteine und Aminosäuren empfehle ich euch erst noch diesen Beitrag zu lesen. Kurz zusammengefasst solltet ihr folgendes wissen:
- DNA/RNA sind Kettenmoleküle aus Nukleotiden.
- Diese Nukleotide stellen wir als die Zeichen A,C,G und T (in der DNA) bzw U (in der RNA) dar.
- Proteine sind Kettenmoleküle aus Aminosäuren.
- Es gibt 20 verschiedene Aminosäuren.
- Jeweils 3 Nukleotide (zusammen als Codon bezeichnet) werden in eine Aminosäure übersetzt.
- Das sind 43 = 64 mögliche Codons (und damit mehr als 20 verschiedene Aminosäuren).
- Das heißt, es gibt für fast alle der Aminosäuren mehrere verschiedene Codierungen.
Die Idee hinter mRNA als Impfstoff
Ziel einer aktiven Schutzimpfung ist es, dem Immunsystem des Körpers beizubringen, auf einen Krankheitserreger (Virus oder Bakterium) schnell und wirksam zu reagieren. Das geschieht in der Regel, indem wir unseren Körper mit einem geschwächten oder entschärften Erreger konfrontieren, an dem das Immunsystem die Abwehrreaktion trainieren kann. Werden wir dann mit dem tatsächlichen Erreger infiziert, erkranken wir im besten Fall gar nicht oder nur sehr leicht.
Auch eine mRNA-Impfung trainiert das Immunsystem gegen den Erreger, aber auf eine besonders gezielte und leistungsstarke Weise. Wir müssen keinen geschwächten oder entschärften Erreger spritzen, stattdessen verabreicht man mRNA, die den genetischen Code für ein bestimmtes Protein enthält. Bei diesem Protein handelt es sich um ein sogenanntes Antigen, das eine Immunantwort des Körpers auslöst. Und genau diese Immunantwort soll unser Körper trainieren. Unser Körper lernt, genau die Erreger zu bekämpfen, die solche Antigene auf ihrer Oberfläche tragen. Die RNA selbst erzeugt keine Immunreaktion und wird nach kurzer Zeit in der Zelle abgebaut.
Ein kurzer Exkurs in die Immunabwehr
Für eine gezielte Immunreaktion gegen einen bestimmten Erreger sind unter anderem B-Lymphozyten zuständig. Es gibt unzählige verschiedene B-Lymphozyten mit unterschiedlichen Bindungsstellen an ihrer Oberfläche. Zu den Antigenen auf der Oberfläche eines bestimmten Erregers passen nur einige wenige B-Zellen. Durch Bindung an dieses spezifische Antigen werden die B-Lymphozyten aktiviert, sich zu vermehren. Die Zahl der B-Lymphozyten, die den Erreger erkennen können, nimmt also stark zu. Ein Teil der B-Lymphozyten reift zu Plasmazellen, die Antikörper speziell gegen den Erreger produzieren. Diese Antikörper sind Proteine, die spezifisch an das bestimmte Antigen binden. Sie machen Krankheitserreger unschädlich, indem sie beispielsweise Bakterien miteinander verkleben oder Viren die Fähigkeit nehmen, in Körperzellen einzudringen und sich dort zu vermehren. Außerdem werden Erreger, die mit Antikörpern markiert sind, leichter von der Immunabwehr aufgespürt.
Bis unser Immunsystem diese Immunantwort gegen einen bestimmten Erreger gelernt hat, kommt es zu Krankheitsbeschwerden. Beim ersten Kontakt, bilden sich erst nach einigen Tagen Antikörper. Nach erfolgreicher Bekämpfung des Erregers nimmt deren Konzentration wieder ab. Ein Teil der B-Lymphozyten entwickelt sich jedoch zu Gedächtniszellen, die für Jahre oder manchmal lebenslang erhalten bleiben. Bei einem erneuten Kontakt mit dem gleichen Erreger setzt die Produktion der Antikörper viel schneller ein und erreicht größere Mengen. Die Immunreaktion ist gezielter und schneller; Krankheitserscheinungen sind schwächer oder treten gar nicht erst auf.
Fun fact:
Das Wort Vakzination bzw Vakzinierung stammt vom lateinischen Wort für Kuh (vacca) ab. Ab Ende des 18. Jahrhunderts wurde der Wirksamkeitsnachweis einer Pockenimpfung mit dem Vacciniavirus erbracht (statt mit menschlichen Pockenviren als Lebendimpfstoff), die seltener zu einer Erkrankung führte. Das Vacciniavirus wurde ursprünglich für ein Kuhpockenvirus gehalten. Inzwischen ist bekannt, dass das Vacciniavirus näher mit den Pferdepocken als mit den Kuhpocken verwandt ist.
Der SARS-CoV-2 Impfstoff


Im Falle von SARS-CoV-2 trainieren wir gezielt gegen das berühmt-berüchtigte Spike-Protein. Die Verpackung des SARS-CoV-2 ist mit Spike-Proteinen gespickt. Es nutzt diese Proteine, um an menschliche Zellen anzudocken. Das Virus kann dann mit der Zellmembran verschmelzen und sein Erbgut ins Zellinnere entlassen. Das Spike-Protein ist das Antigen, dass unser Körper kennenlernen soll. Der Impfstoff enthält mRNA, der dieses Spike-Protein beschreibt. Und zwar nur dieses Protein und nicht das gesamte Virus. Durch clevere chemische Tricks gelangt der Impfstoff in einige unserer Zellen. Diese produzieren das Spike-Protein in großen Mengen. Unser Immunsystem kann an diesem Protein trainieren und Gedächtniszellen entwickeln. Werden wir dann mit SARS-CoV-2 infiziert, sind wir für eine schnelle und gezielte Abwehrreaktion gewappnet.
Ein Blick in den genetischen Code des Impfstoffes
Jetzt schauen wir uns die 4284-Zeichen-lange Kette des mRNA Impfstoffs im Detail an. Die komplette Zeichenkette könnt ihr bei der WHO einsehen. Die mRNA besteht aus mehreren Abschnitten, die wir uns im Folgenden näher angucken.
Kappe
Der Code des Impfstoffes startet mit den folgenden zwei Nukleotiden (als Kappe bezeichnet): GA. Diese Kappe sorgt dafür, dass die mRNA von den Ribosomen erkannt wird. Ribosomen sind quasi die „Übersetzer“, die die Nukleotid-Zeichenkette in eine Aminosäure-Zeichenkette übersetzen und dabei das Protein „zusammenbauen“ (quasi eine Art 3D-Drucker für Proteine). Die Kappe erhöht außerdem die Halbwertszeit der mRNA. Je langsamer die mRNA in der Zelle abgebaut wird, desto häufiger kann sie übersetzt und desto mehr Protein hergestellt werden.
Leitsequenz
Es folgt die sogenannte Leitsequenz oder 5′-UTR. UTR steht für untranslated region, also ein nicht-übersetzter Abschnitt. Dieser Teil wird nicht in Aminosäuren übersetzt und landet damit nicht im Protein. Dieser Abschnitt dient zur Steuerung der Herstellung des Proteins. Er enthält zum Beispiel die Bindungsstelle für das Ribosom. Das Ribosom muss physisch in Kontakt mit dem RNA-Strang sein, damit die Herstellung des Proteins funktionieren kann. Diese Bindungsstelle heißt Kozak-Sequenz, benannt nach der US-amerikanischen Biochemikerin Marilyn Kozak.
Zusätzlich enthält die Leitsequenz übergeordnete Informationen, etwa wann und wie oft die Übersetzung in Proteine geschehen soll. Für den Impfstoff wurde die “dringlichste” bekannte Version der Leitsequenz gewählt, basierend auf einem Gen, das dafür bekannt ist, dass es zuverlässig eine große Zahl an Proteinen herstellt.
Die Leitsequenz des mRNA Impfstoffes sieht folgendermaßen aus:
GAAΨAAACΨAGΨAΨΨCΨΨCΨGGΨCCCCACAGACΨCAGAGAGAACCCGCCACCEs fällt auf: Statt den für RNA üblichen vier Nukleinbasen A, C, G und U finden wir statt des U’s ein Ψ. Dies ist eine der außergewöhnlich schlauen Lösungen des Impfstoffs. Unsere Zellen sind extrem skeptisch gegenüber fremder oder synthetischer RNA and setzen alles daran, diese zu zerstören, bevor sie ihre Zielzellen erreichen. Damit sich die mRNA am Immunsystem vorbeimogeln kann, verwendet man ungewöhnliche Nukleoside. Der Impfstoff enthält eine minimal veränderte Form des Us, nämlich 1-Methyl-3’-Pseudouridylyl, dargestellt als Ψ. Damit kann die mRNA nicht von RNAsen abgebaut werden und ein Immunangriff wird unterdrückt. Alle für die Herstellung des Proteins relevanten Teile der Zelle erkennen das Ψ aber als reguläres U an.
Hier möchte ich gleich einem der vielen Aufschreie gegen diesen Impfstoff entgegenargumentieren: Oft höre ich die Frage „Wie kann es sein, dass der Impfstoff in so kurzer Zeit entwickelt wurde?“. Nun, wir ernten hier die Früchte der in der Vergangenheit geleisteten wissenschaftlichen Grundlagenforschung. Viele der verwendeten „Tricks“ sind nicht neu und wurden schon vorher entdeckt und erforscht. An dieser modifizierten Art der mRNA zum Beispiel wird schon seit Jahren insbesondere für die Regeneration von geschädigtem Herzmuskelgewebe geforscht. Die Entdecker:innen der Ψ-Ersetzungsmethode Katalin Karikó und Drew Weissman mussten etwa 15 Jahre dafür kämpfen, dass ihre Forschung finanziert und akzeptiert wurde, weil man den weitreichenden Nutzen damals noch nicht absehen konnte.
Signalpeptid
Der nächste Abschnitt der mRNA enthält die Information zur Herstellung des Signalpeptids. Als Peptide bezeichnet man kurze Aminosäure-Ketten (zum Beispiel Teilstücke von Proteinen). Das Signalpeptid ist das erste Teilstück des Spike-Proteins und entscheidet über dessen Bestimmungsort. Es ermöglicht, dass das Protein (über das Endoplasmatische Retikulum) aus der Zelle hinaus transportiert werden kann, um dort von unserem Immunsystem erkannt zu werden und den Lernprozess unseres Immunsystems zu starten.
Das Signalpeptid ist nicht sehr lang. Schauen wir uns die Zeichenketten der Impfstoff-RNA im Vergleich zur echten Virus-RNA an. Die Zeichenkette ist in Dreiergruppen gegliedert: Drei Nukleotide sind ein Codon und werden in eine Aminosäure übersetzt.
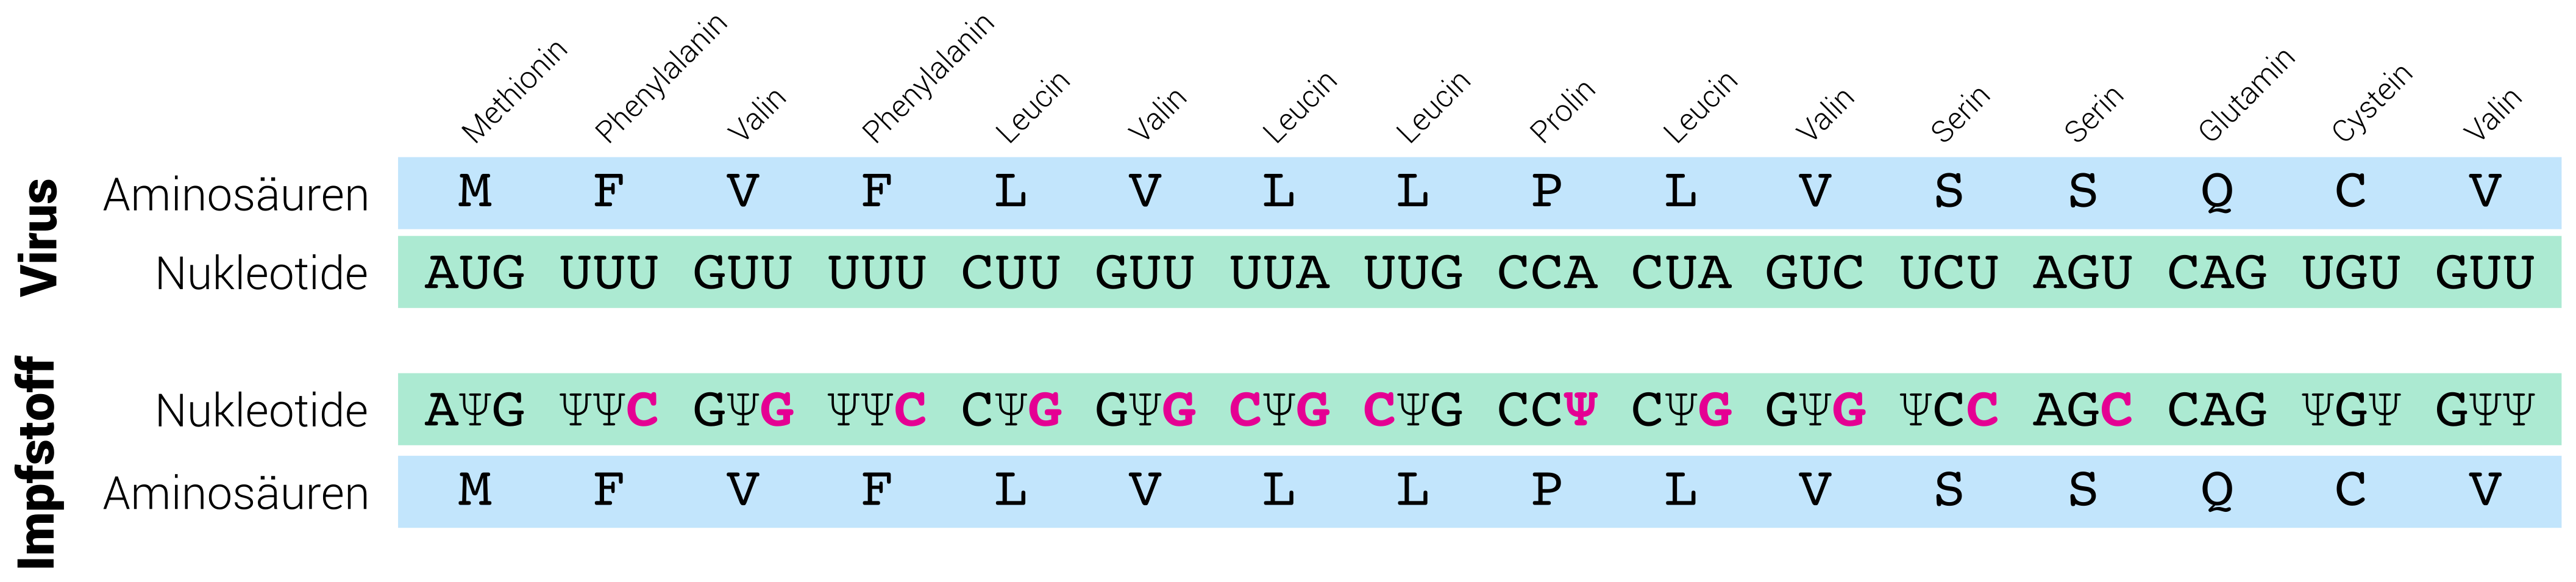
Wir sehen, dass sich die RNAs an manchen Stellen unterscheiden. Die resultierenden Aminosäuren bleiben jedoch unverändert. Das Signalpeptid im Impfstoff besteht aus genau den gleichen Aminosäuren wie im Virus selbst. Wie kann sich dann die RNA unterscheiden? Und wozu hat man diese Unterschiede in die Impfstoff-RNA eingefügt?

Wie oben erwähnt, gibt es 64 mögliche Dreierkombinationen von Nukleotiden und damit mehr als die 20 verschiedenen Aminosäuren. Das heißt, es gibt für fast alle der Aminosäuren mehrere verschiedene RNA-Codons (Synonyme könnte man sagen). Oft unterscheiden sich die Codons für eine Aminosäure nur im letzten Nukleotid. Zum Beispiel wird sowohl CCU, CCG, CCA und CCC in die Aminosäure Prolin übersetzt. Auch alle im Impfstoff vorgenommenen Ersetzungen sind Synonyme. Die Aminosäuren verändern sich nicht. Wozu dann überhaupt Änderungen einfügen? Auch hier geht es wieder um Effizienz: RNA, die viele C’s und G’s enthält, wird effizienter in Proteine verwandelt. Zu diesem Zweck wurden in der Impfstoff-RNA möglichst viele Zeichen durch C’s und G’s ersetzt.
Das Spike-Protein
Die nächsten 3777 Zeichen der Impfstoff-RNA enthalten den genetischen Code (also den Bauplan) für die Herstellung des Spike-Proteins. Sie sind in ähnlicher Weise optimiert, das heißt, es wurden möglichst viele C’s und G’s eingefügt ohne die resultierende Aminosäure-Kette zu verändern. Das gilt für alle, bis auf zwei Aminosäuren des Proteins.
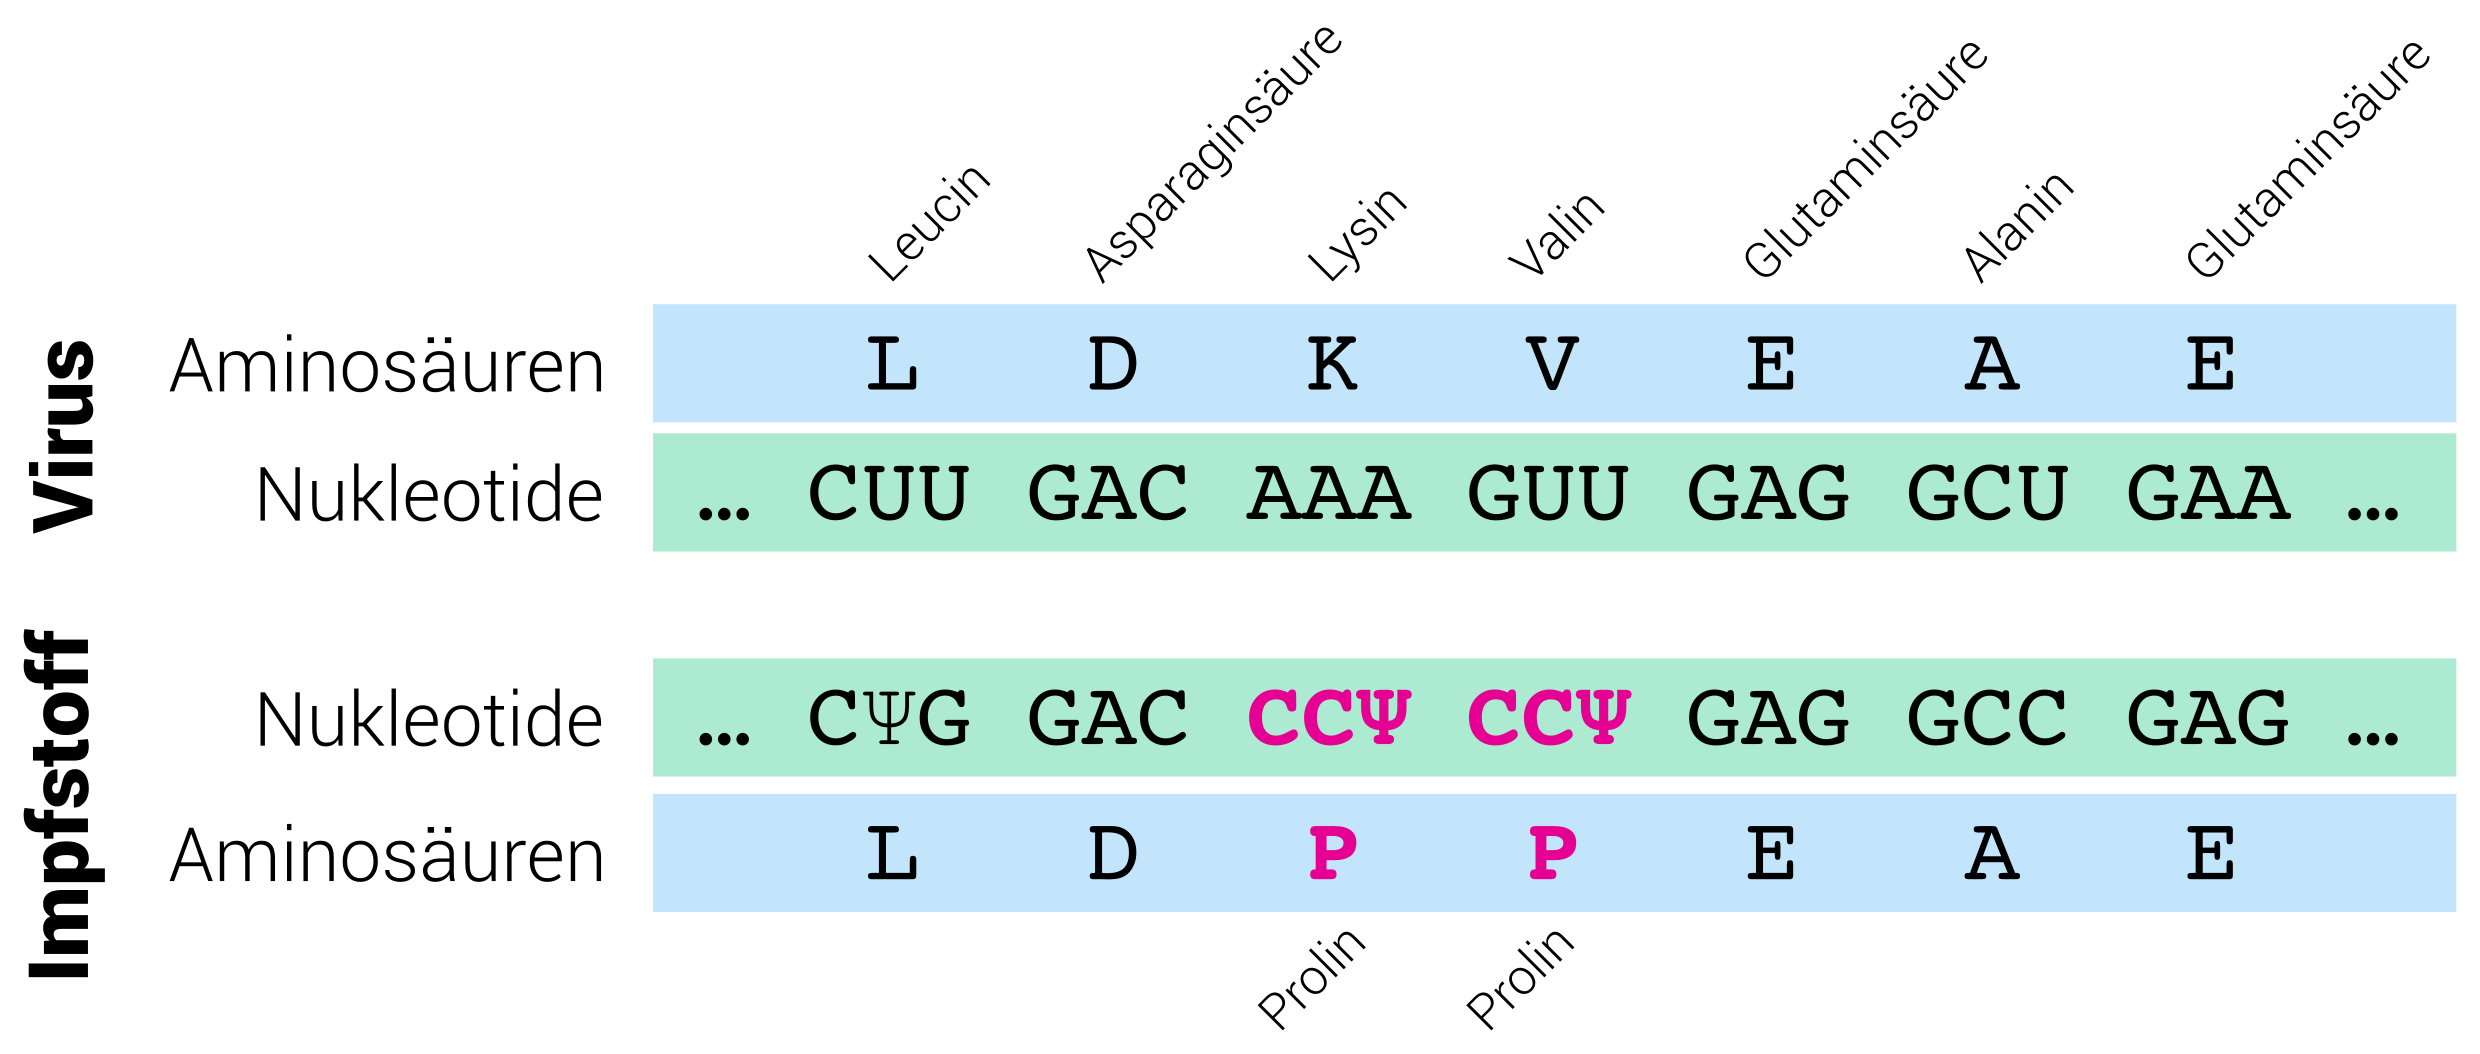
Zwei der Aminosäuren wurden durch eine andere Aminosäure ersetzt (nämlich Prolin). Der Grund liegt verborgen in der 3D-Struktur (oder Raumstruktur) des Proteins. Bis hier haben wir Proteine als Aminosäure-Kettenmoleküle betrachtet. Tatsächlich faltet sich diese Kette (2D-Struktur) aber zu einer 3D-Struktur. Vergleichbar mit einem Faden, den ihr zusammenknüllt. Die räumliche Form des Spike-Proteins ähnelt einem Stachel oder Dorn (engl. spike). Diese Form nimmt das Protein jedoch nur an, wenn es in die Virus-Verpackung (als Kapsid bezeichnet) verbaut wird. Die Idee des Impfstoffs ist es aber (wie oben erwähnt), nicht das ganze Virus oder Kapsid zu erzeugen, sondern nur das eine spezifische Protein, das als Erkennungsmerkmal des Virus ausreicht. Das Problem an der Sache: ein freies Spike-Protein nimmt eine völlig andere Form an. Unser Körper würde also ein falsches Erkennungsmerkmal lernen und den eigentlichen „Täter“ später nicht erkennen.
Auch hier haben wir riesiges Glück, dass wir auf bereits vorangegangen Forschungsarbeiten zurückgreifen konnten. 2017 veröffentlichten Forscher:innen, dass das Ersetzen zweier bestimmter Aminosäuren dazu führt, dass das Spike-Protein (damals schon aus SARS-CoV-1 und MERS bekannt) seine Stachelform einnimmt, auch ohne Teil der Virus-Verpackung zu sein. Somit kann unser Immunsystem allein auf diesem Protein lernen, woran es den Eindringling erkennt, und im Ernstfall schnell und effizient reagieren.
Der Rest
Die Impfstoff-mRNA endet mit der sogenannten 3′-UTR gefolgt vom Poly(A)-Schwanz. Die 3′-UTR hat oft regulatorische Funktionen und sorgt auch wieder für RNA Stabilität und eine möglichst große Menge an produziertem Spike-Protein. Der Poly(A)-Schwanz ist (wie der Name sagt) eine lange Kette von A’s, mit der die mRNA endet. mRNA kann immer wieder verwendet werden, verliert dabei jedoch stets einige A’s am Ende. Sind diese aufgebraucht, wird die mRNA abgebaut und entsorgt. Der Poly(A)-Schwanz schützt also einerseits vor vorzeitigem Verschleiß, sorgt aber andererseits auch dafür, dass die mRNA schlussendlich durch so genannte Ribonucleasen (Enzyme, die RNA abbauen) entsorgt wird.
Von der Buchstabenkette zum Impfstoff
Wir haben uns jetzt aus informatischer Sicht die Zeichenkette der mRNA angeschaut und analysiert, was diese Zeichen bedeuten. Wie wird aus dieser Zeichenkette eine Flüssigkeit, die ich mir spritzen lassen kann? Zu Beginn der Impfstoffproduktion wurde dieser Code an einen DNA-Drucker geschickt, welcher aus der Zeichenkette echte DNA-Moleküle herstellt. Aus der Maschine kommt eine winzige Menge DNA, die (durch biochemische Methoden) in RNA umgewandelt wird. Um die Aufnahme durch Körperzellen zu ermöglichen, wird die mRNA mit einer cleveren Lipid-Verpackung umhüllt. Fertig ist der Impfstoff.
Warum der mRNA Impfstoff nicht eure DNA verändern wird
Eine gängige Sorge, die oft geäußert wird, ist die Frage, ob die mRNA unser Genom verändern kann. Tatsächlich würde das gegen alles verstoßen, was wir über Zellbiologie wissen. Die Kurzversion: mRNA-Impfstoffe wirken vollständig im Zytosol der Zelle und kommen nicht in die Nähe des Zellkerns, wo sich die DNA befindet. Die mRNA hat also keinen Einfluss auf die menschliche DNA, weder in Körperzellen noch in Keimbahnzellen. Sie wird (wie oben beschrieben) nach kurzer Zeit abgebaut. Nach dem Abbau der mRNA kann auch das Spike-Protein nicht weiter hergestellt werden. Was bleibt sind die Gedächtniszellen unseres Immunsystems, die nun dazu in der Lage sind, den Eindringling schnell zu erkennen und effizient zu bekämpfen. Die ausführliche Erklärung eines Mikrobiologen könnt ihr hier nachlesen. Wenn ihr trotzdem wegen des mRNA-Impfstoffes besorgt seid, hier die gute Info: Es ist sehr wahrscheinlich, dass es bald auch andere Arten von Impfstoffen gegen SARS-CoV-2 geben wird.
Für weitere Fragen zur SARS-CoV-2 Impfung haben das RKI und das Bundesministerium für Gesundheit Antworten zu den gängigen Fragen bereitgestellt.
The post Wissen gegen die Angst: Ein Blick in den genetischen Inhalt des SARS-CoV-2 mRNA Impfstoffes first appeared on BioinfoWelten.
]]>The post Eine Hommage an mein liebstes Heißgetränk first appeared on BioinfoWelten.
]]>
Zu Hause, im Büro, unterwegs, früh, mittags, abends, Espresso, Cappuccino oder Americano — Kaffee könnte ich eigentlich immer und überall trinken. Und mit dieser Liebe zum Kaffee stehe ich gewiss nicht alleine da. Kaffee ist weltweit ein Lebensgefühl und nach Wasser und Tee das am häufigsten konsumierte Getränk der Welt. So kam es, dass ich für die Hochzeitszeitung von Freuden eine Hommage and den Kaffee und die Liebe geschrieben habe. Natürlich wissenschaftlich fundiert. Und im Zuge meiner Recherchen bin ich auf so viele interessante Facts über Kaffee gestolpert, dass ich sie euch nicht vorenthalten möchte. Auch wenn das Ganze natürlich nicht viel mit (Bio-)Informatik zu tun, außer vielleicht, dass Kaffee Trinken zum Informatik-Klischee einfach dazugehört: „Informatiker_innen verarbeiten im laufenden Betrieb Kaffee zu Quellcode.“
Kaffee ist ein sehr komplexes Getränk mit über tausend Verbindungen, von denen viele noch nicht identifiziert sind. Ich habe ja das Gefühl, dass sich die Wahrheiten in den Ernährungswissenschaften alle paar Jahre ändern. Aber klar ist es auch schwierig, die Einflüsse einzelner Lebensmittel zu erforschen. Nachdem die Auswirkung von Kaffee jahrelang umstritten war, ist man sich heute relativ einig, dass etwa zweieinhalb Tassen Kaffee am Stück oder fünf Tassen Kaffee täglich, nicht schädlich sind.
Heiß und frisch am besten
Die sensorischen Eigenschaften des Kaffees werden von verschiedenen Faktoren beeinflusst: Herkunft, Ernte, Aufbereitung, Röst- und Mahlgrad, Zubereitung. Durch das heiße Aufbrühen von Kaffee werden Polysaccharide (Vielfachzucker) freigesetzt, die unsere Sinne berühren: das sorgt nicht nur für das wohlige Aroma, sondern zum Beispiel auch für eine stabile Crema und das cremige Gefühl im Mund, das als „Körper“ bekannt ist.
Die Trinktemperatur hat großen Einfluss auf die wahrgenommenen Geschmackseigenschaften von Kaffee. Wie stark dieser Einfluss ist, und welche Temperatur die richtige für einen intensiven Kaffeegeschmack, hängt von der Kaffeesorte ab. Die ideale Serviertemperatur liegt irgendwo zwischen 50 und 85 Grad Celsius. Die sensorischen Eigenschaften von Kaffee sind bei 70 Grad Celsius am intensivsten. Schon nach 30 Minuten verliert Kaffee sein Aroma, wird bitter und entwickelt eine säuerliche Note.
Eine Alternative ist kalt gebrühter Kaffee. Er enthält weniger deprotonierte Säuren und ist daher verträglicher für diejenigen, die an Verdauungsproblemen leiden. Gleichzeitig verringert sich dadurch aber auch die antioxidative Aktivität des Kaffees. Die Menge des aufgenommenen Koffeins ist unabhängig von der Temperatur des Kaffees.
Gut fürs Herz und die Gesundheit
Früher galt Kaffee als Risikofaktor für Bluthochdruck, Osteoporose und Herz-Kreislauf-Erkrankungen. Heute ist die gängige Meinung, dass Kaffee eine Vielzahl von Komponenten enthält (unter anderem das Koffein selbst), die sich positiv auf die Gesundheit auswirken.
Kaffee trägt zum Beispiel wesentlich zur Gesamtaufnahme von Polyphenolen bei – mehr noch als Obst, Gemüse und Wein. Polyphenole spielen eine wichtige Rolle beim Schutz vor Krebs, senken das Risiko für Herz- Kreislauf-Erkrankungen, haben einen positiven Einfluss auf den Kohlenhydrat- und Fettstoffwechsel und verringern somit das Risiko für die Entstehung von Diabetes. Moderater Kaffeekonsum verringert das Schlaganfallrisiko und begrenzt die schädlichen Folgen. Zudem verstärkt Koffein bei Migräne und Kopfschmerzen die Wirkung üblicher Schmerzmittel.
Die optimale Menge an Kaffee liegt bei drei bis vier Tassen (300 bis 400 mg Koffein) täglich, jedoch nicht mehr als zweieinhalb Tassen (200 mg Koffein) am Stück. Noch besser: Ein süßes Stück dunkler Schokolade zur heißen Tasse Kaffee erhöht die Menge an Polyphenolen zusätzlich. Das Verhältnis von gesundheitsfördernden Verbindungen zu Koffein ist in Arabica-Kaffee übrigens höher als in anderen Sorten.
Jungbrunnen
Studien deuten darauf hin, dass der Konsum von Koffein die kognitive Leistung älterer Menschen erhöhen kann. So kann eine Tasse Kaffee beim Frühstück den Leistungsabfall zwischen Morgen und Nachmittag verhindern. Koffein scheint auch die Reaktionszeit und das Arbeitsgedächtnis älterer Menschen zu verbessern. Der lebenslange Konsum von Koffein und Polyphenolen verringert den altersbedingten geistigen Verfall, sowie das Risiko für neurodegenerative Erkrankungen, wie Parkinson, Alzheimer, Demenz, und verzögert sogar deren Fortschreiten. Voraussetzung sind drei bis vier Tassen Kaffee täglich. Die Auswirkungen von Koffein auf die Entwicklung von Parkinson wurde bereits Ende der 1960er Jahre entdeckt. Bei täglichem Koffeinkonsum ist das Risiko, an Parkinson zu erkranken, um durchschnittlich 25 Prozent geringer.
Wach und glücklich
Koffein gilt als die weltweit am meisten konsumierte psychoaktive Substanz. Koffein hat viele positive Wirkungen auf das Gehirn: Koffein bringt uns in Schwung, steigert die Konzentration und die körperliche Leistungsfähigkeit. Koffein erhöht die Wachheit, reduziert Müdigkeit, verkürzt die Reaktionszeit, verbessert die visuelle Aufmerksamkeit und kann die Aufmerksamkeit insbesondere bei langen, anspruchsvollen Aufgaben aufrechterhalten. Die Polyphenole im Kaffee verbessern außerdem die kognitive Leistungsfähigkeit und stimulieren die Gehirnfunktionen.
Kaffee macht uns nicht nur munter, er verbessert auch die Stimmung, steigert das Wohlbefinden, verhindert Depressionen und verringert angeblich sogar das Selbstmordrisiko. Kaffee ist das beliebteste Frühstücksgetränk. Seine positiven Auswirkungen auf die Stimmung können durch Sonnenstrahlen und den Duft von Brot noch verstärkt werden. Ich gebe zu, schon der Gedanke daran weckt in mir die gute Laune. Hinzu kommt das wohlige Gefühl einer wärmenden Tasse in der Hand. Ein Studie fand heraus, dass das Gefühl physischer Wärme, das Gefühl zwischenmenschlicher Wärme verstärkt, ohne dass sich die Personen dieses Einflusses bewusst sind. Kurz eine heiße Tasse Kaffee in der Hand gehalten und schon empfindet man sein Gegenüber als großzügiger, fürsorglicher und geselliger und fühlt sich somit wohler. Pro-Tipp fürs nächste Bewerbungsgespräch oder das nächste Date: am besten gemeinsam frühstücken.
In sehr großen Mengen kann Koffein den Schlaf beeinträchtigen, indem es die Schlaflatenz verlängert und die Gesamtschlafzeit und die Tiefschlafphasen verkürzt. Der Effekt ist aber viel geringer als allgemein behauptet. Die Wirkung ist am stärksten, wenn das Koffein vor dem Zubettgehen aufgenommen wird. Aber auch zwei Tassen am Morgen, können die Gesamtruhezeit um etwa zehn Minuten und die Schlafleistung um etwa drei Prozent verringern. Diese Auswirkungen treten aber eher bei Menschen auf, die nicht regelmäßig Kaffee trinken.
Suchtgefahr
Als intensive Kaffeetrinkerin habe ich mir natürlich schon öfter Sorgen um eine Abhängigkeit gemacht. Aber ehrlich, es ist der Geschmack und das wohlige Gefühl, nach dem ich süchtig bin. Während meiner Schwangerschaft habe ich fast ausschließlich entkoffeinierten Kaffee getrunken und habe mich weder mehr noch weniger müde gefühlt. Genauso muss ich aber auch zugeben, dass Kaffee bei mir kaum einen aktivierenden Effekt zeigt. Weder bringt er mich in Schwung, noch lässt er mich schlechter schlafen.
Viele Daten deuten darauf hin, dass moderate Kaffeetrinker_innen keine körperliche Abhängigkeit von Koffein entwickeln. Bildgebende Untersuchungen beim Menschen zeigen, dass Koffein den Gehirnkreislauf von Abhängigkeit und Belohnung nicht aktiviert. Es gibt jedoch Entzugserscheinungen etwa einen Tag nach abruptem Koffeinentzug: Kopfschmerzen und Müdigkeit dauern jedoch in der Regel nicht länger als zwei Tage. Möchte man Kaffee (aus mir unerfindlichen Gründen) absetzen, kann man diese Symptome durch eine schrittweise Entwöhnung vermeiden. Der Entzug von Koffein hat auch nur geringe Auswirkungen auf die Leistung. Was aber tatsächlich häufig bei Entzug von Koffein sinkt, ist die gute Laune — aber diese Auswirkung spiegelt möglicherweise weitgehend die Erwartungen der Kaffeeliebhaber_innen.
Hohe Dosen von Koffein können bei einer kleinen Gruppe besonders empfindlicher Personen sogar Angstzustände hervorrufen und Panikattacken auslösen. Der häufige Konsum von Koffein führt jedoch auch bei genetisch anfälligen Menschen zur Toleranz gegenüber dieser Wirkung.
Mein Fazit
Leute, trinkt Kaffee! Kaffee ist Teil einer gesunden, ausgewogenen Ernährung. Die meisten Menschen können ihren Koffeinkonsum sehr gut regulieren, und holen damit nur das Beste aus dem Kaffee heraus. Wer am Abend noch eine Kanne Kaffe in sich hinein kippt, ist selbst Schuld. Aber so drei bis vier Tassen über den Tag verteilt, bringen euch in Schwung und halten euch körperlich und geistig fit. Ich trinke meinen Kaffee seither mit noch mehr Genuss und Freude (und versuche ihn wieder häufiger in Blogbeiträge statt Quellcode umzusetzen).
The post Eine Hommage an mein liebstes Heißgetränk first appeared on BioinfoWelten.
]]>The post Wie die Metagenomik Einzug in Krankenhäuser hält first appeared on BioinfoWelten.
]]>
In einem meiner letzten Beiträge habe ich euch bereits erzählt, wie verschiedene Fortschritte in der Mikrobiologie einen völlig neuen Einblick in die Welt der Viren ermöglichen. Metagenomik und hochmoderne Sequenziertechnologien werden in vielen Forschungsbereichen vermehrt eingesetzt, von der Ökologie bishin zur Ernährungswissenschaft. Die Idee dahinter: man nehme eine Probe (Wasser, Käse, Kot, Blut, Gewebe, …) und sequenziert daraus direkt das gesamte genetische Material. Auch in die Krankenhäuser hält die Metagenomik Einzug und verändert die Art und Weise, wie Ärzte Infektionskrankheiten diagnostizieren und behandeln. Denn die Metagenomik bietet zwei entscheidende Vorteile gegenüber gängigen Diagnosetests: (1) Mit einem einzigen Test kann das gesamte Spektrum an Krankheitserregern in nahezu jeder klinischen Probe untersucht werden und (2) man braucht keine Anfangsvermutung, um welchen Erreger es sich handelt — somit können auch unerwartete oder sogar unbekannte Krankheitserreger erkannt werden.
Eine Krankheit — 100 verschiedene Ursachen
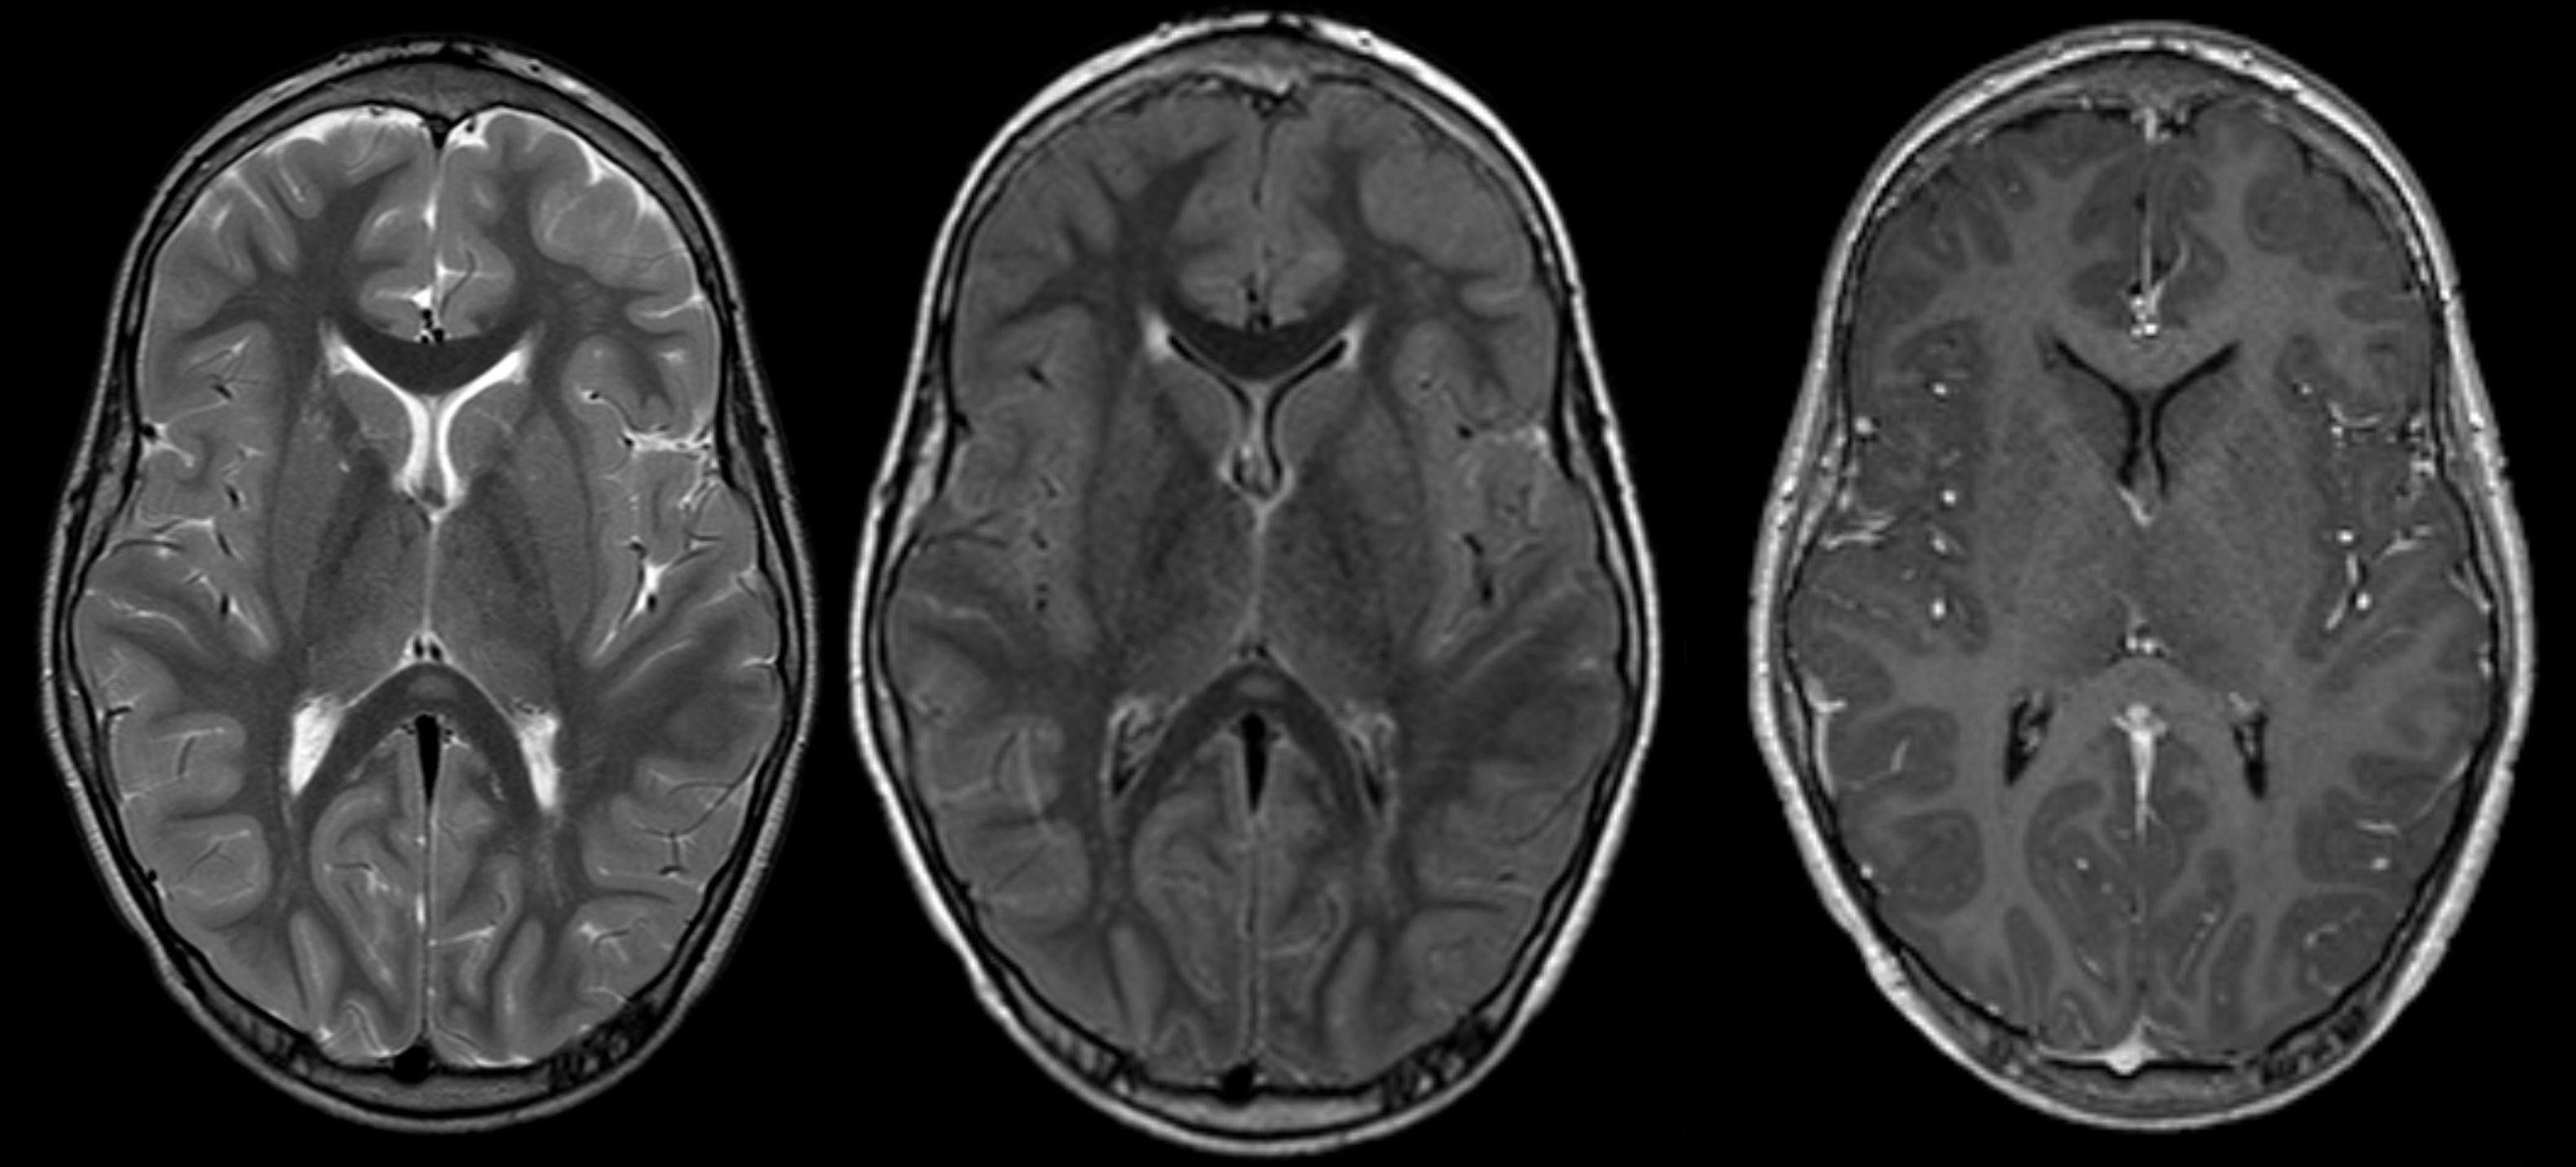
Ein Fallbeispiel: Ein 14-jähriger Junge, der an einer angeborenen schweren Störung des Immunsystems leidet, kommt dreimal innerhalb von vier Monaten in die Klinik und klagt über Fieber und Kopfschmerzen. Die Flüssigkeitsräume des Gehirns sind krankhaft erweitert und es kommt zu einem andauernden epileptischen Anfall. Der Junge muss ins Koma versetzt werden. Alle diagnostischen Test, inklusive einer Hirnbiopsie (Gewebeentnahme aus dem Gehirn), helfen nicht weiter. Mehr als 100 verschiedene Infektionserreger können solch eine Hirnentzündung auslösen. Meist wird sie durch Vireninfektionen ausgelöst (wie zum Beispiel die von Zecken übertragene Frühsommer-Meningoenzephalitis), aber auch bakterielle Infektionen können die Ursache sein. Eine Diagnose mit den herkömmlichen Testmethoden für einzelne Erreger ist enorm aufwendig. Mehr als die Hälfte der Hirnentzündungen werden nicht diagnostiziert. Im Falle des Jungen entschließt man sich zu einem Schritt in die Moderne: die Hirnflüssigkeit wird mittels eines metagenomischen Ansatzes komplett “durchsequenziert”. Dabei entdeckt man tatsächlich die Ursache der Entzündungen: eine Infektion des Gehirns durch Bakterien der Gattung Leptospira. Die erfolgreiche Diagnose der Ursache, ermöglicht eine gezielte Behandlung der Krankheit mit Antibiotika. Bei einer viralen Infektion, wäre diese wirkungslos gewesen. Einen Monat später kann der Junge aus der Klinik entlassen werden.
Diagnose von Infektionskrankheiten
Die traditionelle klinische Vorgehensweise für die Diagnose von Infektionskrankheiten bei Patienten wird seit mehr als einem Jahrhundert angewandt und läuft im Prinzip immer gleich ab: Die Ärztin/der Arzt formuliert eine Differentialdiagnose, das heißt, sie/er zählt alle möglichen Erklärungen auf, die für die Symptome des Patienten in Betracht kommen. Für viele Krankheitsbilder, zum Beispiel Hirn(haut-)entzündungen, Atemwegssyndrome oder fieberhafte Erkrankungen, ist die Differentialdiagnose sehr breit und der Arzt/die Ärztin muss eine Reihe von Tests anordnen, um den Erreger zu identifizieren. Solche Tests sind in der Regel kostengünstig und schnell (weniger als zwei Stunden). Die meisten herkömmlichen mikrobiologischen Tests sind jedoch sehr spezifisch, das heißt sie erkennen nur eine begrenzte Anzahl von Krankheitserregern (häufig genau einen Erreger). Meist wird mit dem wahrscheinlichsten Krankheitserreger begonnen und sich dann weiter vorgetestet. Dieser Ansatz ist zeitaufwändig und in Summe mit erheblichen Kosten verbunden. Im schlimmsten Fall vergehen Wochen bis ein Endergebnis erzielt wird, wenn überhaupt. Metagenomische Sequenzierung hingegen dauert länger als ein einzelner dieser mikrobiologischen Tests (etwa einen Tag) und ist teurer, aber fast alle Krankheitserreger, einschließlich Viren, Bakterien, Pilze und Parasiten, können mit einem einzigen Test identifiziert werden. Die metagenomische Sequenzierung von klinischen Proben ist damit vielleicht der vielversprechendste Ansatz für die umfassende Diagnose von Infektionen.
Metagenomik bedeutet, dass die Gesamtheit der in der Probe befindlichen DNA (Genom) und/oder RNA (Transkriptom) sequenziert wird. Jede Körperflüssigkeit und jedes Gewebe kann einer solchen metagenomischen Untersuchung unterzogen werden. Wichtig ist, dass genügend Nukleinsäure (also DNA oder RNA) in der Probe enthalten ist. Denn mehr als 99% der enthaltenen Sequenzen ist menschlich (wobei Gewebe mehr menschliche Sequenzen enthält als Körperflüssigkeiten), und von den verbleibenden Sequenzen stammt nur eine Bruchteil von potenziellen Krankheitserregern. In manchen Fällen muss die menschliche DNA vorher sogar entfernt werden, um ein ausreichend starkes Signal des Erregers zu erhalten.
Die Metagenom-Sequenzierung bietet noch weitere Vorteile: Im Falle von bakteriellen Infektionen zum Beispiel, kann nicht nur der Erreger identifiziert werden, sondern auch Antibiotikaresistenzgene im Erreger direkt nachgewiesen werden. Das verhindert den Einsatz des falschen Antibiotikums von vornherein. Überhaupt können die Sequenzdaten potenziell für zusätzliche Analysen genutzt werden. Zum Beispiel kann man anhand der menschlichen (Transkriptom-)Sequenzen auch die Reaktion des menschlichen Körpers auf den Erreger untersuchen.
Klinik vs Forschung: Kosten und Know-How
Trotz des Potenzials und der jüngsten Erfolge der Metagenomik in der Forschung hinken die Anwendungen in der klinischen Diagnostik hinterher. Klar ist, dass metagenomische Untersuchungen in klinischen Labors schwieriger umzusetzen sind. Während sich in der Forschungsumgebung die Vorverarbeitung, die Sequenziermethoden, und die bioinformatische Auswertung ständig verändern, muss ein Test für die Klinik standardisiert sein. Jede Änderung, die an einem solchen Testverfahren vorgenommen wird, muss vor der Anwendung am Patienten geprüft werden. Die Komplexität der metagenomischen Untersuchung erfordert hochqualifiziertes Personal, das in molekularbiologischen Verfahren bestens ausgebildet ist, und äußerste Sorgfalt im Umgang mit den Proben, um Fehler und Kontaminationen zu vermeiden. Selbst die kleinste Menge an DNA oder RNA von außen könnte ein falsches Signal liefern.
Zudem gibt es bisher keine wirklich benutzerfreundliche Bioinformatik-Software zur Auswertung metagenomischer Sequenzdaten. Auch hier ist hochqualifiziertes Personal erforderlich, um eine entsprechende Software für den klinischen Einsatz zu entwickeln, zu validieren und zu warten. Auch die benötigte Rechenpower und der Speicherbedarf stellen ein Problem dar, insbesondere im Hinblick auf den Schutz vertraulicher Patientendaten.
Nicht zuletzt spielen natürlichen die Kosten eine entscheidende Rolle. Auch wenn die Sequenzierverfahren an sich immer kostengünstiger werden, darf man Faktoren wie Personalkosten nicht unter den Tisch fallen lassen. Die metagenomische Untersuchung einer Probe kostet mehrere hundert bis tausend Euro und ist damit wesentlich teurer als viele andere klinische Tests. Preislich lohnt sich eine solche Untersuchung also nur, wenn dadurch eine Vielzahl anderer Tests vermieden werden kann.
Nanoporen: Der Sequenzierer in der Hosentasche
Sequenzierungstechnologien und ihre Anwendungen entwickeln sich ständig weiter. Next-Generation-Sequenzierung hat das Lesen von Sequenzen um ein vielfaches vereinfacht und beschleunigt (Zeit für die Sequenzierung eines Menschengenoms von 13 Jahren auf 2 Tage verringert) und das Feld der Metagenomik überhaupt erst in Gang gebracht. Mittlerweile sind wir im dritten Zeitalter der Sequenzierung angekommen. Mittels sogenannter Nanoporen (Sequenzierer im Hosentaschenformat) kann man heute in Echtzeit sequenzieren — ein enormer Vorteil bei der Behandlung von Patienten mit akuten Infektionskrankheiten. Nanoporen-Sequenzierung ermöglicht die Erkennung von Erregern in weniger als 6 Stunden. Für die Zukunft bedeutet das, dass metagenomische Untersuchungen direkt am Patientenbett oder in der Notaufnahme stattfinden könnten. Das ist auch attraktiv für die Fernüberwachung von Virenepidemien oder im Hinblick auf den Schutz der Privatsphäre der Patienten, da die menschlichen Sequenzdaten nicht gespeichert werden.
Auf jeden Fall werden metagenomische Untersuchungen in den kommenden Jahren auch im Krankenhaus immer attraktiver werden. Die Gesamtkosten und die Durchlaufzeiten werden weiter sinken, und die gewonnen Zusatzinformationen (zum Beispiel in Bezug auf die Immunantwort des Patienten) werden sich als nützlich erweisen. Auch die Software für die bioinformatische Auswertung wird sich weiterentwickeln, und viele der Abläufe im Labor werden automatisiert stattfinden. Und in einer Welt mit ständig neuen Krankheitserregern werden solche unvoreingenommenen Tests eine zentrale Rolle für die Erkennung und auch für die Überwachung von Infektionsausbrüchen spielen. Dank Nanoporen-Sequenzierung wird es möglich sein, Infektionsausbrüche viel früher zu erkennen und einzudämmen, und damit Leben zu retten und Kosten zu senken.
The post Wie die Metagenomik Einzug in Krankenhäuser hält first appeared on BioinfoWelten.
]]>The post Turing-Mechanismen: Wie das Zebra zu seinen Streifen kommt first appeared on BioinfoWelten.
]]>
(Photo: Public Domain)
Alan Turing gehört zweifelsohne zu den interessantesten Persönlichkeiten der Geschichte der Informatik. Er entwickelte das Konzept der Turing-Maschine, ein abstraktes Modell eines Computers, mit dem man testen kann, ob ein Problem überhaupt berechenbar (also von einem Computer lösbar) ist. Turing-Maschinen sind bis heute einer der Schwerpunkte der Theoretischen Informatik. Während des Zweiten Weltkriegs war Turing einer der herausragendsten Wissenschaftler im Bereich der Kryptoanalyse. Er half dabei, sowohl die Codes der Enigma als auch der Lorenz-Schlüsselmaschine zu brechen und damit die verschlüsselten deutschen Funksprüche zu entziffern. Zudem beschäftigte er sich schon früh mit der Problematik der künstlichen Intelligenz und formulierte den Turing-Test, um festzustellen, ob ein Computer ein dem Menschen gleichwertiges Denkvermögen hätte. Und als wäre das alles nicht schon cool genug, beschäftigte sich dieser Pionier der Informatik in seinen letzten beiden Lebensjahren doch tatsächlich auch noch mit mathematischer Biologie. Alan Turing — einer der ersten Bioinformatiker!
Biologische Ästhetik

Habt ihr euch auch schon einmal gefragt, wie diese tolle Fellmusterung bei Zebra, Tiger, Giraffe, Dalmatiner und Co eigentlich zustande kommt? Um das zu verstehen, müssen wir an den Anfang zurückspulen, bis zur Morphogenese der kleinen Tierbabies. Der Begriff Morphogenese kommt aus dem Griechischen, bedeutet „Entstehung der Form“ und beinhaltet alle Entwicklungsprozesse, die irgendwie an der Ausbildung der charakteristischen Form beziehungsweise Gestalt eines Organismus beteiligt sind, von der Organentwicklung bis hin zur Herausbildung bestimmter Strukturen oder Muster. Wie das Fell des Zebras später einmal aussehen wird, wird bereits im Zebraembryo festgelegt. Dabei stellt sich die Frage, ob die Streifen eines Zebras genetisch vorbestimmt sind? Haben Zebrazwillinge das gleiche Muster? Nein. Die Fellmuster sind von Zebra zu Zebra unterschiedlich, ähnlich zu den Fingerabdrücken beim Menschen. Die Morphogenese wird nicht nur durch das Erbgut bestimmt, sondern auch in unterschiedlichem Maße von Umweltfaktoren beeinflusst.
Wie erhält ein Haar seine Farbe?
Wie wird ein Haar denn überhaupt schwarz, weiß, oder auch blond oder braun? Ein Haar entsteht im Haarfollikel, gewissermaßen die Produktionsstätte und gleichzeitig der Anker eine Haares. Am unteren Ende des Follikels wird das Haar in der Haarwurzel gebildet. Rund um diesen Bildungsbereich lagern im Follikel zahlreiche Melanozyten. Melanozyten sind Zellen, die Melanine enthalten, die die Färbung der Haut, Haare, Federn und Augen bewirken. Diese Farbpigmente können dunkelbraun bis schwarz oder gelblich bis rötlich sein. Die Melanozyten geben die Melanine an das entstehende Haar ab und sorgen damit für dessen Färbung. Werden keine Farbpigmente an das Haar abgegeben, bleibt es weiß.
Melanozyten bestimmen auch die Farbe der Haut, wobei unterschiedliche Melanozyten für Haut- und Haarfarbe verantwortlich sind. Soll heißen: Die Haut des Zebras ist nicht gestreift, sondern schwarz. Bei manchen Großkatzen spiegelt die Haut das Muster des Fells wieder. Das liegt vermutlich jedoch daran, dass die farbigen Haarfollikel in der Haut sichtbar sind, ähnlich wie ein Bartschatten beim Mann.
Wie kommt das Zebra zu seinen Streifen?
Oder anders gesagt, wie kommt es zur unterschiedlichen Verteilung des Melanins? Mit dieser Frage beschäftigte sich Alan Turing Anfang der 1950er Jahre. Selbst kein Biologe, betrachtet er die Frage aus mathematischer Sicht und versucht nachzuvollziehen, wie sich ein Embryo Schritt für Schritt entwickelt. Er schlug einen Reaktions-Diffusions-Mechanismus vor, in dem zwei chemische Substanzen miteinander reagieren und diffundieren. Diffusion, das kennt ihr vielleicht noch aus der Schule, ist der ohne äußere Einwirkung eintretende Ausgleich von Konzentrationsunterschieden. Turing vereint mit seiner Theorie also nicht nur Biologie und Mathematik, sondern auch noch Chemie und Physik. Multidisziplinär sozusagen: eine biologische Fragestellung mit chemischen und physikalischen Konzepten erklärt und mathematisch bewiesen.
Für ein solches Reaktions-Diffusions Modell brauch wir zwei chemische Substanzen, die Turing als Morphogene bezeichnet: Die eine Substanz ist ein Aktivator, der ab einer bestimmten Konzentration die Produktion von Melanin anregt. Der Aktivator ist außerdem autokatalytisch, das heißt, er regt auch die eigene Produktion an. Und der Aktivator breitet sich nur langsam aus. Die andere Substanz ist ein Inhibitor, der die Produktion des Aktivators unterdrückt. Der Inhibitor breitet sich schnell und langreichweitig aus. Der Aktivator ist stärker fördernd, als der Inhibitor hemmend ist. Wie sich diese beiden Substanzen nun im Körper ausbreiten und miteinander interagieren, lässt sich mathematisch durch eine partielle Differentialgleichung darstellen (bestehend aus zwei Gleichungen: eine für den Aktivator und eine für den Inhibitor). Ein ganz wichtiger Bestandteil dieser Gleichung ist der Parameter für die Diffusion. Ohne Diffusion ist das System homogen, mit Diffusion formt es räumliche Muster, wie zum Beispiel Streifen: an den Stellen mit einer hoher Konzentration an Aktivatorsubstanz wird Melanin gebildet, das Fell wird schwarz.
Turing bewies, dass dieses einfache System eine Vielzahl von Mustern hervorbringen kann. Also nicht nur die Streifen des Zebras, sondern zum Beispiel auch die Flecken der Giraffe. Welches Muster konkret entsteht, hängt von vielen unterschiedlichen Faktoren ab. Zum Beispiel von der Größe und Geometrie des Fells, aber auch von der Dauer der Embryonalentwicklung und dem Zeitpunkt der Musterbildung. Bei der Giraffe zum Beispiel findet die Musterbildung recht früh statt; die Flecken wachsen entsprechend mit. Dalmatinerflecken hingegen sind eher klein, weil die Musterbildung eher später stattfindet. Das Modell erklärt sogar, wieso der Körper des Geparden fleckig, der Schwanz jedoch gestreift ist. Mehr noch, das Prinzip von Konzentrationsgradienten erklärt noch viele weitere natürliche Muster über die Fellfärbung hinaus: Von der Anordnung der Sonnenblumenkerne bishin zur links-rechts Symmetrie unseres Körpers. Turings Arbeit war damit ein Meilenstein der Entwicklungsbiologie
Wozu eigentlich Streifen?
Bleibt noch die Frage, wozu Zebrastreifen eigentlich gut sind (außer um die Straße zu überqueren ;)). Dazu gab es über die Jahre die verschiedensten Theorien, von Tarnung über Kühlung bis zur Insektenabwehr. Die Theorie vom kühlenden Effekt der Zebrastreifen ist bereits widerlegt. Sehr wahrscheinlich ist hingegen die Funktion bei der Insektenabwehr. Die Streifen der Zebras reflektieren das Licht so, dass die Insekten ihre Flugbahn nicht kontrolliert abbremsen können, gegen den Zebrakörper prallen und wieder weg fliegen.
The post Turing-Mechanismen: Wie das Zebra zu seinen Streifen kommt first appeared on BioinfoWelten.
]]>The post Wie das Klima die Gene beeinflusst first appeared on BioinfoWelten.
]]>Epigenetik – Die Metaebene der Genetik
Aber was ist Epigenetik überhaupt? Die griechische Vorsilbe „epi-“ in diesem Zusammenhang richtig zu übersetzen, finde ich schwierig. Man könnte wohl so etwas wie „zusätzlich“ oder „oberhalb“ sagen. Unter Epigenetik fasst man all die genetischen Prozesse zusammen, die über die „klassische“ Genetik hinaus gehen, das heißt, die nichtauf Nukleotidebene in der DNA-Sequenz kodiert sind. Stattdessen finden epigenetische Veränderungen auf Chromatinebene statt. Chromatin ist ein Komplex aus DNA und speziellen Proteinen (hauptsächlich Histonen), aus dem die Chromosome im Zellkern gebildet werden. Verändert werden sowohl die Histone als auch die Nukleotide, wobei die Veränderungen umkehrbar und eher mit einer Art chemischen Markierung gleichzusetzen sind. Man könnte epigenetische Veränderungen auch als „weiche Veränderungen“ bezeichnen, die mehr Anpassungsfähigkeit ermöglichen, aber auch rückgängig gemacht werden können. Die klassische Genetik sorgt hingegen für „harte Veränderungen“, die nicht umkehrbar sind.

Die komplexen epigenetische Prozesse steuern die Funktion bestimmter Gene und erhöhen damit die Flexibilität des immer gleichen Erbguts. Epigenetik beeinflusst unter anderem, dass aus totipotenten Stammzellen, aus denen wir anfangs bestehen, durch Zelldifferenzierung bestimmte Körperzellen mit festgelegten Funktionen werden, obwohl das Erbgut in allen Zellen gleich ist. So braucht zum Beispiel eine Muskelzelle andere Gene als eine Nervenzelle. Dabei werden auf unserem DNA-Strang bestimmte Gene abgeschaltet, indem sie epigenetisch markiert werden. Es bleiben nur die Gene benutzbar, die für die Aktivität der jeweiligen Körperzelle wichtig sind.
Wir sind mehr als die Summe unserer Gene

Mit der Epigenetik kam auch die Einsicht, dass die Eigenschaften eines Lebewesens nicht rein durch das vererbte Genmaterial unveränderbar bestimmt sind. Im Gegenteil: epigenetische Prozesse können sogar durch Umweltfaktoren beeinflusst werden. Ein sehr eindrucksvolles Beispiel dafür sind Bienen. Ob sich eine Biene zur Königin oder Arbeiterin entwickelt, wird epigenetisch über die Nahrung bestimmt. Die Larven zukünftiger Königinnen erhalten Gelée royale. Die Larven, die mit Pollen gefüttert werden, entwickeln sich zu Arbeiterinnen. Die unterschiedliche Nahrung sorgt für unterschiedliche Markierungen auf der DNA und entscheidet somit über das Schicksal der Larven.
Aber auch das menschliche Genom verändert sich im Laufe unseres Lebens auf epigenetischer Ebene. Das kann man vor allem an genetisch eineiigen Zwillingen nachweisen. Dabei hat man unter anderem festgestellt, dass Zwillinge im Alter epigenetisch umso verschiedener sind, je unterschiedlicher ihre Leben verlaufen sind.
Der Einfluss des Klimas
Zurück zu den Pflanzen. Auch für Pflanzen spielen Umweltfaktoren eine große Rolle. In verschiedenen Umgebungen und unter verschiedenen klimatischen Bedingungen flexibel zu sein, ist (nicht nur für Pflanzen) von großem Vorteil. Um die Anpassungsfähigkeit von Pflanzen zu verstehen, müssen wir auch die epigenetischen Markierung auf der DNA untersuchen. Eine Form dieser DNA-Markierungen sind Methylierungen. Dabei werden kleine Methylgruppen an einen bestimmten DNA-Abschnitt gehängt und das Gen damit stillgelegt. Wird die Methylgruppe wieder abgelöst, kann wieder auf die Erbinformation zugegriffen werden. Auf diese Art könnten Pflanzen zum Beispiel auf extreme Trocken- oder Hitzeperioden reagieren.
Ein Großteil unseres derzeitigen Wissens über DNA-Methylierung bei Pflanzen bezieht sich auf die Acker-Schmalwand. In der Landwirtschaft gilt sie als Unkraut, in der Genetik hat sie sich aber als Modellorganismus etabliert — „die Fruchtfliege der Botanik“. Modellorganismen sind nützlich, aber so wie sich nicht alles Wissen von Fruchtfliege auf Mensch übertragen lässt, sind eben auch nicht alle Pflanzen gleich. Bisher ist unklar, wie wichtig epigenetische Unterschiede für die Anpassungsfähigkeit natürlicher Pflanzenpopulationen unter verschiedenen Umweltbedingungen sind.
44 Wissenschaftler_innen schließen sich zusammen

EpiDiverse ist ein großer europäischer Forschungsverbund, in dem sich Bioinformatiker_innen, Molekularbiolog_innen und Ökolog_innen aus sieben Ländern zusammengeschlossen haben, um epigenetische Veränderungen an drei Wildpflanzenarten zu untersuchen: Schwarz-Pappel, Wald-Erdbeere und Acker-Hellerkraut. Im Mittelpunkt steht dabei die Frage, wie epigenetische Mechanismen zur Reaktion auf Stress durch veränderte Klimabedingungen und zur langfristigen Anpassung an solche beitragen. Dabei schauen sich die Forscher_innen unter anderem die epigenetischen Unterschiede der Pflanzen entlang des Klimagradienten an, aber auch, wie die Pflanzen epigenetisch auf Klima-Stress reagieren. Untersucht werden die genomischen Grundlagen (Bioinformatik), die molekularen Mechanismen (Molekularbiologie) und die ökologische Bedeutung der Veränderungen (Ökologie).
Dabei werden natürlich in großen Mengen DNA-Daten ausgewertet. Diesmal aber eben nicht die reinen Sequenzen, sondern die epigenetischen Informationen. Wie aber gewinnt man diese Daten? DNA-Sequenzierung liefert die Abfolge der Nukleotide, nicht aber die epigenetische Information darüber hinaus. Eine mögliche Methode, um DNA-Methylierungen zu entdecken, ist die Bisulfit-Sequenzierung. DNA-Methylierungen finden hauptsächlichen an Cytosinen statt. Behandelt man DNA mit Bisulfit, werden alle Cytosine in Uracil umgewandelt — außer diejenigen, die methyliert sind. Somit lassen sich methylierte Cytosine durch normale DNA-Sequenzierung erkennen. In einem der Projekte des EpiDiverse Netzwerks geht es speziell darum, solche Bisulfit-Sequenzierungsdaten zu untersuchen und neue Algorithmen für deren Analyse zu entwickeln.
Ziel des Forschungsverbundes ist natürlich nicht nur die Entwicklung von Methoden zur Auswertung von Daten, sondern in erster Linie, die Beantwortung biologischer Fragestellungen. Interessant wäre es zum Beispiel, natürliche Muster der epigenetischen Unterschiede in Bezug auf die lokale Umgebung, das Klima und den geografischen Standort aufzudecken. Und natürlich, die zu Grunde liegenden molekularen Mechanismen der epigenetischen Reaktionen auf Klimastress zu verstehen. Letztlich hilft uns dieses Wissen hoffentlich auch auf dem Weg zu einer nachhaltigeren Landwirtschaft.
The post Wie das Klima die Gene beeinflusst first appeared on BioinfoWelten.
]]>The post Fledermäuse: Einzigartig und gefürchtet first appeared on BioinfoWelten.
]]>Nicht nur besonders, sondern auch besonders schwer einzuordnen
Wenn ich von Fledermäusen rede, dann meine ich eigentlich Fledertiere, im englischen als „bats“ bekannt oder wissenschaftlich „Chiroptera“. Der wissenschaftliche Name setzt sich aus den griechischen Wörtern für Hand (cheir) und Flügel (pteron) zusammen; „Handflügel“ also. Fledertiere sind die zweitgrößte Säugetiergruppe und machen mit über 1200 Arten weltweit etwa zwanzig Prozent aller klassifizierten Säugetierarten aus. Schon aus phylogenetischer Sicht sind Fledertiere hochinteressant. Zum einen ist es schwierig, die Fledertiere im Stammbaum der Säugetiere einzuordnen; zum anderen ist auch die Ordnung der Fledertierarten untereinander noch immer umstritten. Traditionell unterteilte man Fledertiere in Flughunde (Megachiroptera) und Fledermäuse (Microchiroptera). Diese Systematik ist nach neueren phylogenetischen Erkenntnissen nicht ganz richtig. Man hat entdeckt, dass eine Gruppe der Fledermäuse (die Hufeisennasenartigen), näher mit den Flughunden verwandt sind als mit den übrigen Fledermäusen.

Das hartnäckige Image des Blutsaugers
Dass Fledermäuse immer irgendwie mit Vampiren in Verbindung gebracht werden, hat vermutlich mehrere Gründe. Sie lieben die Dunkelheit, hausen in düsteren Höhlen, bewegen sich fast unsichtbar durch die Nacht, haben spitze Zähne und Krallen und sehen ungewöhnlich aus — alles irgendwie furchteinflößend. Spätestens seit „Dracula“ trägt der Vampir einen Umhang, der Fledermausflügeln ähnelt. Bleibt die Frage nach der offensichtlichsten Gemeinsamkeit mit einem Vampir: Saugen Fledermäuse wirklich Blut? Es gibt tatsächlich genau drei Arten von Vampirfledermäusen, die sich ausschließlich von Blut ernähren: der Gemeine Vampir (Desmodus rotundus), der Kammzahnvampir (Diphylla ecaudata) und der Weißflügelvampir (Diaemus youngi) — wobei die Tiere nach den Sagengestalten benannt wurden und nicht umgekehrt. Von diesen dreien ernährt sich nur eine (der Gemeine Vampir) überhaupt gelegentlich von Menschen (eigentlich bevorzugt von Kühen). Anders als Graf Dracula leben Vampirfledermäuse nicht in Rumänien oder überhaupt in Europa, sondern im südlichen Nordamerika und in Mittel- und Südamerika. Und entgegen der landläufigen Meinung saugen sie das Blut auch nicht aus ihrer Nahrungsquelle. Stattdessen beißen sie ihr Opfer und schlürfen das Blut mit der Zunge. Sie haben messerscharfe Zähne, sodass ihr Biss fast schmerzlos ist und schlafende Tiere oder Menschen selten davon wach werden. Das Blutplasma scheiden sie bereits zwei Minuten später als Urin wieder aus. Fledermäuse sind Schnellverdauer. Die meisten Fledermausarten ernähren sich allerdings nicht von Blut, sondern von Insekten, andere auch von Fröschen, Fischen, Eidechsen und Vögeln. Einige Fledermausarten und alle Flughundarten sind sogar Vegetarier. Sie ernähren sich von Nektar, Pollen, Früchten und Blüten. Über 300 Pflanzenarten sind zur Bestäubung auf Fledertiere angewiesen, darunter Feigen, Bananen, Avocados, Mangos, Datteln, Kakao, Agave, Vanille, und viele mehr.
Handflügel — eine einzigartige Erfindung
Fledertiere sind die einzigen Säugetiere, die fliegen können. Also so richtig mit Flügelschlag aus eigener Kraft. Sind wir doch mal ehrlich: schon allein deshalb sind sie unglaublich cool und beflügel(te)n die Phantasie vieler Geschichtenschreiber. Der Flügel eines Fledertiers ähnelt einer modifizierten Hand, mit langen Fingerknochen, vielen beweglichen Gelenken und einer flexiblen Hautmembran. Der Name Handflügel ist also durchaus treffend. Was das betrifft, sollten die gängigen Vampirstories die Anatomie ihrer Protagonisten noch einmal überarbeiten. Obwohl ich mir einen mit den Händen flatternden Vampir wenig bedrohlich vorstelle. In der Realität sind Fledertiere besonders flexible und wendige Flieger. Die Flügelmembranen helfen außerdem, Körpertemperatur, Blutdruck, Wasserhaushalt und Gasaustausch zu regulieren.
„Blind wie eine Fledermaus“
Ein wahrhaft schlechter Vergleich. Fledermäuse sind entgegen der landläufigen Meinung nicht blind. Sie können schwarz-weiß sehen und dank Echoortung können sie sich auch im Dunkeln problemlos orientieren. Sie senden Geräusche aus und achten auf Veränderungen in den Echos, die auf sie zurückprallen. Damit können sie Objekte und auch deren Entfernung sicher erkennen. Zum Auffangen des Echos besitzen Fledermäuse ein hoch entwickeltes Ohr und große Ohrmuscheln. Die zurückkommenden Echos werden vom Fledermausgehirn in ein dreidimensionales Bild der Umgebung umgesetzt. Fledermäuse sehen quasi mit ihren Ohren. Mit der Zeit entwickeln sie sogar ein räumliches Gedächtnis und können sich auch ohne Ortungslaute orientieren. Unter den Flughunden besitzen nur Rosettenflughunde die Fähigkeit zur Echoortung und zwar durch Klickgeräusche mit der Zunge.
Außerdem können einige Fledermausarten sogar ultraviolettes Licht sehen. Für Entfernungen über zehn Meter wird die Echoortung ungenau. Das UV-Sehen erleichtert die frühzeitige Erkennung von Raubvögeln vor allem während der Dämmerung und hilft den vegetarischen Fledermäusen auf der Suche nach Blüten, die zum Teil ultraviolettes Licht verstärkt reflektieren.
Lang lebe das Fledertier
Und das tut es auch. Und auch damit sticht es unter der Säugetieren deutlich hervor. Es gibt eine Art Daumenregel: je größer das Säugetier, desto länger die Lebenserwartung. Elefanten werden so um die siebzig Jahre alt; Mäuse so zwei bis drei Jahre. Große Arten wiederum bekommen relativ selten Nachwuchs; kleinere Arten produzieren in der Regel weit mehr Nachkommen. Und Fledermäuse? Die sind mal wieder die Ausnahme von der Regel. Sie bekommen meist nur ein Baby pro Jahr und sind damit im Größenverhältnis die Säugetiere mit der langsamsten Fortpflanzung der Welt. Die durchschnittliche Lebensdauer von Fledermäusen variiert, aber einige Arten können dreißig Jahre alt werden. 2006 stellte eine winzige Fledermaus aus Sibirien mit 41 Jahren den Weltrekord auf. Die Gründe dafür sind noch nicht ganz verstanden. Bei den meisten Tierarten ist das Sterberisiko kurz nach der Geburt hoch, danach längere Zeit eher niedrig und im Alter steigt es wieder deutlich an. Bei Fledermäusen konnte man bei älteren Tieren jedoch keine erhöhte Sterblichkeit oder Krebsanfälligkeit messen. Sie werden alt und bleiben dabei kerngesund. Verschiedene Gründe könnten die Ursache sein, zum Beispiel der Winterschlaf und/oder die im Flug erhöhte Körpertemperatur.
Es gibt kein Entkommen
Falls ihr Fledermäuse nicht so cool findet wie ich und euch eher von ihnen fernhalten wollt, dann kann ich euch die Antarktis als einzigen fledertierfreien Kontinent empfehlen. Fledertiere sind auf fast allen Teilen der Erde anzutreffen (außer in extremen Wüstengebieten und Polarregionen), vom nördlichen Polarkreis bis nach Argentinien und an die südlichste Spitze Südafrikas. Auf Neuseeland waren zwei Fledermausarten sogar die ersten Säugetiere vor der Ankunft des Menschen. Besonders weit verbreitet sind die Mausohrfledermäuse (Myotis), die Bulldoggfledermäuse (Molossidae) und die Sackflügelfledermäuse (Emballonuridae).
So weit verbreitet die Fledertiere sind, so vielfältig sind sie auch. Besonders ihre Größe variiert stark; von der Schweinsnasenfledermaus (mit etwa dreißig Millimetern und zwei Gramm auch das kleinste Säugetier überhaupt) bis zu den größten Flughunden (mit etwa dreißig Zentimetern, Flügelspannweite über 1,5 Meter und etwa einem Kilo Körpergewicht).
Glück, Gesundheit und gleichgeschlechtliche Liebe
In China gelten Fledermäuse als Glücksbringer. Das chinesische Zeichen für Fledermaus (蝠, fú) klingt genauso wie das für Glück (福, fú) und Reichtum (富, fù); und die vollständige Bezeichnung 蝙蝠 (biānfú) klingt wie 变福 (biàn fú), was so viel heißt wie „glücklich/wohlhabend werden“ beziehungsweise „gesegnet sein“. Mehr noch: Ornamente aus fünf Fledermäusen symbolisieren die fünf Glückseligkeiten (Gesundheit, langes Leben, Reichtum, Tugendhaftigkeit und ein schneller natürlicher Tod).
Die einzigartigen Fähigkeiten der Fledertiere inspirieren auch die Forschung. Nicht nur, weil man die Tiere besser verstehen möchte, sondern natürlich auch, weil man sich ihre Fähigkeiten zu Nutze machen möchte. So hat zum Beispiel die Untersuchung der Echoortung geholfen, um Navigationshilfen für Blinde zu entwickeln und aus der Spucke von Vampirfledermäusen gewinnt man Medikamente zur Hemmung der Blutgerinnung zur Behandlung von Schlaganfallopfern und Herzpatienten.
Gleichgeschlechtliche Liebe ist keine Seltenheit im Tierreich. Affen, Libellen, Fische, Elefanten, Giraffen — nachweislich gibt es über 1500 Tierarten, bei denen Homosexualität ausgelebt wird. Auch bei mehr als zwanzig Fledertierarten wurde bereits dokumentiert, dass sie sich in unterschiedlicher Form homosexuell verhalten.
Ein Quell der Viren
Nachdem ich euch nun so viel darüber erzählt habe, warum ihr Fledertiere unbedingt cool finden solltet und sie ihr negatives Image als heimtückische, hässliche und schädliche Kreaturen gar nicht verdient haben, erzähle ich euch jetzt, warum von ihnen trotzdem eine große Gefahr ausgeht. Und dabei geht es — wie sollte es auch anders sein — natürlich mal wieder um Viren.
In einem meiner letzten Beiträge habe ich euch bereits erzählt, dass vor allem durch den Klimawandel und unsere Vorliebe für Reisen in ferne Länder, der Kontakt zwischen Mensch und sogenannten Reservoirwirten, die Infektionskrankheiten auf den Menschen übertragen, wesentlich erhöht wurde. Etwa 75% aller Infektionskrankheiten des Menschen sind Zoonosen, werden also von Tieren auf den Menschen übertragen. Fledertiere nehmen dabei einen größeren Anteil ein als jede andere Säugetierordnung. In den letzten zwei Jahrzehnten wurden einige virale Ausbrüche mit Fledertieren in Verbindung gebracht, vor allem durch Coronaviren (SARS, MERS) und Filoviren (Ebola, Marburg). Auch Tollwut kann durch Fledermäuse übertragen werden.
Stellt sich die Frage, warum ausgerechnet Fledertiere so gute „Übertragungsvektoren“ für alle Arten von Viren sind? Mit Vampirismus hat das, wie oben schon erwähnt, wenig zu tun. Unser Wissen über die Grundlagen der Fledertierbiologie und -immunologie ist jedoch noch sehr begrenzt, weswegen ich euch die Frage nicht beantworten kann. Eine große Rolle spielt dabei sicherlich die große Artenvielfalt der Fledertiere, und damit einhergehend die großen Unterschiede hinsichtlich ihrer geografischen Lage, ihrer Ernährungsgewohnheiten, und ihrer Physiologie. Dieses Unwissen macht es uns auch schwer, das Risiko eines viralen Übersprungs von Fledertier auf Mensch vorherzusagen. Aber aufgrund der großen genetischen Vielfalt und der großen geografischen Verbreitung der verschiedenen bisher entdeckten Fledertierviren ist es fast sicher, dass immer mehr Krankheitsausbrüche durch Fledertierviren auftreten werden.

Die zweite Frage, die sich stellt, ist, warum viele der von Fledertieren übertragenen zoonotischen Viren für den Menschen (sowie für andere Säugetiere) so tödlich sind, während sie bei den Fledertieren keine Krankheiten auslösen. Auch hier ist unser Wissen noch sehr begrenzt. Durch bioinformatische Genomuntersuchungen hat man zumindest schon Anhaltspunkte gefunden, dass Fledertiere ein erhöhtes Maß an bestimmten Abwehrgenen und Abwehrwegen besitzen. Die Erforschung des Immunsystems der Fledertiere ist vor allem deshalb so interessant, weil dort auch der Schlüssel zu einem Medikament oder Impfstoff gegen die Viren liegen könnte.
Und was sagt ihr? Konnte ich euch mit meiner Fledertierliebe mitreißen? Oder habe ich euch eher Angst gemacht? Kennt ihr vielleicht auch noch ein paar außergewöhnliche Fakten über Fledermäuse?
The post Fledermäuse: Einzigartig und gefürchtet first appeared on BioinfoWelten.
]]>The post Virale Mitbewohner im Darm: Mehr als Durchfall und Erbrechen first appeared on BioinfoWelten.
]]>
Die menschliche Darmflora ist ein eigenes Ökosystem. Ein einziges Gramm Darminhalt beherbergt mehr Lebewesen als die Erde Menschen. Die Darmflora hat das Image der Bakterien gerettet. Dabei handelt es sich um mehr als einen Haufen Bakterien, den wir für unsere Verdauung brauchen. Die Darmflora spielt eine entscheidende Rolle für die menschliche Gesundheit und damit natürlich auch für Krankheiten. Die Bezeichnung „Flora“ — also eigentlich Pflanzenwelt — ist dabei ein wenig irreführend und genau genommen ein Relikt aus Zeiten, in denen Bakterien noch dem Pflanzenreich zugeordnet wurden. Heute sprechen wir lieber vom Darmmikrobiom.
Wird über das Darmmikrobiom berichtet, meint man in erster Linie die Bakterien im Darm. Der bakterielle Komponente des Darms hat man bereits viel Aufmerksamkeit geschenkt. Erst gestern habe ich den aktuellen „Spiegel“ in der Hand gehalten, mit einer Titelstory über das Superorgan Darm: „Die Bakterien in unserem Darm entgiften, trainieren die Immunabwehr, regeln die Verdauung.“ Ihre nützliche Funktion bei gesunden Personen ist bekannt und viele Faktoren, die die Zusammensetzung beeinflussen — Ernährung, Alter, Krankheiten, Medikamente — sind bereits gut verstanden. Auch wurde in den letzten Jahren intensive Forschungen betrieben, um dessen Rolle bei Krankheiten zu entschlüsseln. Die bakterielle Komponente des Darms wird mit einer Vielzahl von Krankheiten in Verbindung gebracht, von Magen-Darm- und Autoimmunerkrankungen über Lebererkrankungen bis hin zu Erkrankungen des Zentralnervensystems.
Darmviren: ein Imageproblem
Als Darmmikrobiom bezeichnet man aber eigentlich nicht nur Bakterien, sondern die Gesamtheit der Mikroorganismen, die den Darm von Menschen und Tieren besiedeln. Dazu zählen auch sogenannte Archaeen (ebenfalls einzellige Lebewesen ohne Zellkern) aber auch Eukaryoten (Lebewesen mit Zellkern; hier vor allem Pilze). Die virale Komponente des Mikrobioms (kurz „Darmvirom“) hat bisher fast gar keine Beachtung erhalten. Über die Viren im Darm weiß man kaum etwas und ihre Relevanz für Gesundheit und Krankheit muss erst noch untersucht werden. Im deutschsprachigen Wikipedia-Artikel über die Darmflora werden Viren nicht einmal erwähnt. Googelt man nach Darmviren, so stößt man auf die gängigen bekannten Krankheitserreger, die uns mit Durchfall und Erbrechen plagen. Dabei wissen wir eigentlich, dass die meisten Viren (und Mikroorganismen im Allgemeinen) weder für Menschen noch für Pflanzen oder Tiere krankheitserregend sind. Es wird also Zeit, das Image der Darmviren zu retten.
Exkurs: Metagenomik
Dass man den Viren (im Darm) bisher nicht so viel Aufmerksamkeit geschenkt hat, hatte vor allem technische Gründe. Für die klassische mikrobiologische Forschung mussten die Mikroorganismen zuerst kultiviert werden, um sie danach mittels Sequenzierung identifizieren zu können. Blöderweise lassen sich die meisten Mikroorganismen (Schätzungen liegen bei über 99%) aber gar nicht kultivieren (oder sagen wir besser, es hat noch niemand einen Weg gefunden, wie sie sich kultivieren lassen). Abhilfe schafft die Metagenomik, die erst dank technologischer Fortschritte in der Molekulargenetik möglich ist. Die Idee dahinter: man nehme eine Umweltprobe (Boden, Meerwasser, Windschutzscheibe oder eben Kot) und extrahiere daraus direkt das gesamte genetische Material.
Die Metagenomik brachte auch einen Umschwung in der Virologie mit sich. Interessierte man sich vorher eher sehr spezifisch für die Viren, die einen Krankheitszustand innerhalb eines Organismus auslösten, begibt man sich dank der Metagenomik mit Hochdurchsatzsequenzierung auf Expeditionen in die Virusökologie. Das erste Virusmetagenom wurde 2002 aus einer Ozeanprobe sequenziert. Seitdem hat die Metagenomik eine enorme mikrobielle Artenvielfalt in vielen unterschiedlichen Umgebungen ans Licht gebracht. In Kliniken setzt man Metagenomik zunehmend für schwer diagnostizierbare Fälle ein. Man muss aber auch sagen, dass die experimentellen und bioinformatischen Methoden für die Virusmetagenomik noch keinen Konsens erreicht haben. Selbst Metagenomik-Experten sprechen von „Dunkler Materie“, wenn sie die viralen Sequenzen beschreiben, die sie in Metagenomen finden.
Zurück in den Darm
Die erste Veröffentlichung überhaupt, in der das Darmvirom erwähnt wurde, erschien 2003. Im selben Jahr noch wurden die ersten Bakteriophagen aus menschlichem Kot sequenziert (übrigens von der gleichen Arbeitsgruppe, die auch das erste Virusmetagenom aus der Ozeanprobe sequenziert hat). Bakteriophagen sind Viren, die Bakterien und Archaeen befallen. Sie sind die am häufigsten vorkommenden Bewohner des Darms. Das Darmvirom enthält aber auch eukaryotische Viren, deren Wirte zum Beispiel die Pilze im Darm sind, oder der Mensch selbst. Selbst Viren, die im Rahmen unserer Ernährung den Magen-Darm-Trakt passieren (z.B. Pflanzenviren) zählen zum Darmvirom. Die krankheitserregende Wirkung von eukaryotischen Darmviren ist gut bekannt (Magen-Darm-Grippe durch Noroviren oder Rotaviren). Da Darmviren bei allen (acuh gesunden) Menschen vorhanden sind, wird vermutet, dass auch sie eine wichtige Rolle für das Gleichgewicht des Körpers spielen; nur gibt es bisher dafür kaum Belege.
CrAssphage: Kein Computervirus, aber nach einer Software benannt
Das erste Darmvirus, dass 2014 neuentdeckt wurde und vorher völlig unbekannt war, schlug hohe Wellen. Der so getaufte CrAssphage ist ein Bakteriophage, der Bakterien des Stammes Bacteroidetes befällt, die wiederum im Darm vieler Tiere, einschließlich des Menschen, häufig vorkommen. Bacteriodetes leben im Endbereich des Verdauungstraktes und stehen im Verdacht, eine Rolle bei krankhaftem Übergewicht und anderen Darmkrankheiten zu spielen. Das Virus wurde cooler Weise nach der Bioinformatik Software crAss (Cross-Assembly of Metagenomes) benannt, mittels derer es entdeckt wurde und ist damit möglicherweise der erste Organismus, der nach einem Computerprogramm benannt wurde. Bei der bioinformatischen Untersuchung von Metagenom-Datensätzen aus Stuhlproben, die öffentlich in Datenbanken zugänglich sind (die Datensätze, nicht die Stuhlproben), wurde dieses neue Virus entdeckt und in mehr als der Hälfte der verfügbaren menschlichen fäkalen Virome nachgewiesen. Da das Virus so weit verbreitet ist, ist es höchstwahrscheinlich bereits sehr alt. In den frühen Entwicklungsstufen des Fötus im Mutterleib und bei Säuglingen ist der CrAssphage noch nicht vorhanden. Sehr wahrscheinlich wird das Virus also in der frühen Kindheit aufgenommen. Bisher gibt es noch keine Hinweise darauf, inwiefern der CrAssphage Einfluss auf die menschliche Gesundheit hat.
Während der CrAssphage zum Zeitpunkt seiner Entdeckung im Jahr 2014 keine bekannten Verwandten hatte, wurden im Jahr 2017 eine ganze Reihe verwandter Viren entdeckt und eine neue Familie von CrAss-ähnlichen Phagen beschrieben.
Alle gleich oder doch jeder einzigartig?
Wenn der CrAssphage in einem so großen Teil der Bevölkerung vorkommt, stellt sich natürlich die Frage, ob es eine Art Kernvirom im Darm gibt, das allen Menschen gemein ist. Die Frage ist bisher ungeklärt, aber Fakt ist, dass noch weitere Viren im Darm vieler Menschen zu finden sind, darunter weitere Vertreter der CrAss-ähnlichen Phagen. Bei der vergleichenden Untersuchung des Darmviroms von Erwachsenen hat man jedoch auch entdeckt, dass dessen Zusammensetzung bei jedem Individuum einzigartig ist. Man kennt bereits mehrere Faktoren, die unsere Viromzusammentzung im Darm beeinflussen: Verwandtschaft, Ernährung, Geburtsmodus und natürlich auch Krankheiten. Der Geburtsmodus (das heißt natürlich versus Kaiserschnitt) scheint die Virenzusammensetzung im Darm sogar stärker zu beeinflussen als die Bakterienzusammensetzung.
An die Frage, wie sich das Darmvirom zusammensetzt, schließt sich direkt die Frage über dessen Einfluss auf die Gesundheit eines Menschen an. Die Rolle des Darmviroms bei Krankheiten ist bei weitem noch nicht hinreichend untersucht. Man kennt jedoch schon Zusammenhänge mit einigen Krankheiten, unter anderem chronisch entzündliche Darmerkrankungen, Typ-I-Diabetes und Darmkrebs. Auch Mangelernährung lässt sich am Darmvirom erkennen, es bleibt jedoch noch unklar, ob die veränderte Zusammensetzung Ursache oder Folge der Krankheit ist.
Vom Babydarm zum Erwachsenendarm: Stabilität über die Zeit
Ob der Darm von Neugeborenen völlig steril ist oder nicht, ist immer noch umstritten. Unmittelbar nach der Geburt ist er einer enormen Anzahl von Mikroorganismus ausgesetzt und wird von diesen besiedelt. In den folgenden Wochen und Monaten bildet sich eine stabile Gemeinschaft dieser Organismen. Das Virom verändert sich in den ersten Lebenswochen drastisch: mehr als die Hälfte der Viren aus Stuhlproben in der ersten Lebenswoche, sind in der zweiten schon nicht mehr nachweisbar. Bakteriophagen dominieren die frühe Besiedlung des Darms nach der Geburt und stammen eher aus der Umwelt als von der Mutter oder der Nahrung. Interessanterweise wird die größte Menge und Vielfalt an Phagen in den ersten Lebensmonaten beobachtet und nimmt im Laufe der Zeit signifikant ab. Die bakterielle Komponente des Darmmikrobioms entwickelt sich genau anders herum.
Auch eukaryotische Viren wurden in Stuhlproben von Säuglingen nachgewiesen, auch ohne, dass diese Säuglinge ein Krankheitsbild zeigten. Ihr Reichtum nimmt wiederum mit zunehmendem Alter zu, vermutlich, weil wir diese Viren aus der Umwelt aufnehmen.
Im Gegensatz zu den drastischen Veränderungen im Virom des Säuglingsdarms scheint das gesunde Darmvirom eines Erwachsenen über die Zeit ziemlich stabil zu sein. Trotzdem mutieren die Viren natürlich auch in unserem Darm. So kann es schon vorkommen, dass sie sich innerhalb von zwei Jahren so sehr verändern, dass sie sich zu einer neuen Art entwickeln. Das könnt auch ein Grund für die zwischenmenschlichen Unterschiede im Darmvirom sein.
Bakterien vs Phagen
Wie kommen die Bakterien und die Bakteriophagen in unserem Darm nun eigentlich miteinander klar und wie beeinflussen sie sich gegenseitig? Die mikroskopische Untersuchung von Stuhlproben ergab, dass etwa 108 bis 109 Viren und 109 Bakterienzellen pro Gramm Stuhl zu finden sind. Also etwa ein Verhältnis von 1:1 oder 0,1:1. Die verhältnismäßige Anzahl an Viren ist viel geringer als beispielsweise in Meeresproben. Auch findet sich im Darm kein klassischer „Räuber-Beute“ Zyklus: viele Bakterien > viele Phagen, die die Bakterien infizieren > dadurch Reduzierung der Bakterien > weniger Phagen („Räuber-Beute“ ist in diesem Zusammenhang nicht ganz richtig, aber ihr wisst, was ich meine). Nur im Säuglingsdarm trifft man anfangs einmal auf diesen Zyklus (wie oben schon angesprochen). Die Bakteriophagen in unserem Darm sind also nicht besonders aggressiv, sondern führen einen eher „gemäßigten Lebensstil“ (wenn ich das so sagen darf, für etwas, was man nicht mal als Lebewesen betrachtet). Daher sind Phagen im Darm mehr als nur „Raubtiere“. In einigen Fällen helfen sie sogar ihrem bakteriellen Wirt, sich in dem Ökosystem, in dem sie sich befinden (also in diesem Fall im Darm), einen Wettbewerbsvorteil zu verschaffen. Das bedeutet aber auch, dass die Wechselwirkungen zwischen Bakterien und Bakteriophagen im Darm für die bisher bekannten Modelle, die die Dynamik von Phagen und Bakterien in anderen ökologischen Umgebungen beschreiben, zu komplex sind. Hier sind neue Modelle erforderlich, insbesondere um diese Dynamik im Hinblick auf Krankheiten zu untersuchen.
Warum sollte man ein mehrdimensionales Ökosystem untersuchen, indem man sich nur auf eine Dimension konzentriert?
Bleibt zu sagen, dass wir noch fast nichts wissen über unser Darmvirom. Was wir brauchen, sind größere Längsstudien, die sich sowohl auf die bakterielle als auch auf die virale Komponente des Darmmikrobioms konzentrieren. Und wir brauchen bessere viren-bioinformatische Analysen. Die meisten Virussequenzen in Metagenomstudien bleiben noch immer unidentifiziert („Dunkle Marterie“). Dementsprechend sind auch die Auswertungen nicht vollständig und es kommt immer wieder zu Widersprüchen in den Forschungsergebnissen. Wichtig für die Zukunft ist, dass wir nicht nur weiter die Bakterien im Darm untersuchen, sondern vor allem auch die Rolle der Phagen im Blick behalten: Wie verändern Bakteriophagen die Zusammensetzung und Funktion der bakteriellen Komponente des Darms und welchen Einfluss haben sie dadurch auf unsere Gesundheit?
What is (not) known about the dynamics of the human gut virome in health and disease.
Beller L, Matthijnssens J.
Curr Opin Virol. 2019;37:52-57.
The post Virale Mitbewohner im Darm: Mehr als Durchfall und Erbrechen first appeared on BioinfoWelten.
]]>The post Apokalypse-Virus: Hollywood oder Realität? first appeared on BioinfoWelten.
]]>
Ich gehe davon aus, dass jeder von euch mindestens einen der Viren-Zombieklassiker, zum Beispiel „28 Days Later“ oder „I Am Legend“, gesehen hat. Und egal wie Hollywood-like die Umsetzung dieser Filme sein mag, das Szenario ist nicht unrealistisch. Weniger der Teil mit den Zombies, eher der Teil mit dem Virus, das die Menschheit ausrottet. Zu den bedrohlichsten Viren der Welt zählen vor allem die Viren, bei denen kurzfristig ein größerer Ausbruch erfolgen könnte und die sich derzeit kaum erfolgreich behandeln lassen. Dazu gehören bereits bekannte Viren, wie Ebola-, SARS- und Zika-Viren; die nächste schwere Epidemie könnte jedoch auch von einem derzeit unbekannten Virus verursacht werden.
Abhilfe kann da wohl, wenn überhaupt, nur die Forschung schaffen. Dazu gehört nicht nur die intensive Forschung an bekannten und bisher unbekannten Viren und potentiellen Medikamenten und Impfungen gegen diese, sondern auch ein Forschungszweig, der sich explizit mit der Ausbreitung von Infektionskrankheiten beschäftigt, die sogenannte Epidemiologie.
Das Zeitalter der Epidemien
Nun leben wir in einem Zeitalter, in dem die medizinische Forschung weit vorangeschritten ist und sich unsere Lebenserwartung um einige Jahre verlängert hat. Und doch wird die Menschheit immer wieder von Epidemien heimgesucht. Erst sind es nur einzelne sporadische Fälle; doch rasch wird daraus ein lokaler Ausbruch und greift man nicht sofort ein, breitet sich die Infektion rasant aus. Von einer Epidemie spricht man, wenn eine Krankheit lokal (und zeitlich) begrenzt vermehrt auftritt. Viele Ausbrüche enden auf natürliche Weise oder können schnell kontrolliert werden. Breitet sich die Krankheit aber gar über Länder oder Kontinente hinweg aus, spricht man von einer Pandemie. Die Ursachen für die steigende Zahl an Epidemien sind vielfältig und reichen vom Bevölkerungswachstum, über unsere Vorliebe für Reisen in ferne Länder, unsere Ernährungsgewohnheiten, bis hin zum Klimawandel. Diese Faktoren verstärken vor allem den Kontakt zwischen Menschen und sogenannten Reservoirwirten, häufig Säugetieren oder Insekten, die Infektionskrankheiten auf den Menschen übertragen. Angesichts der heutigen Mobilität der menschlichen Bevölkerung könnte sich ein Virus innerhalb von Tagen oder Wochen auf entfernte und stark bevölkerte Regionen ausbreiten.

Epidemien und Pandemien gab es in den letzten beiden Jahrzehnten viele (zum Teil von bis dato völlig unbekannten Viren): zum Beispiel die SARS-Pandemie 2002/2003 mit etwa tausend Todesopfern, die Schweinegrippe-Pandemie 2009/2010 mit über 18000 Toten, die Ebola-Epidemie 2014–2016 in Westafrika mit über 11000 Todesopfern, oder erschreckenderweise neuerdings auch immer wieder Masern-Epidemien.
„Next Level“-Epidemiologie
Lange Zeit stützte man sich in der Epidemiologie hauptsächlich auf die Analyse von Falldaten, die im Verlauf eines Ausbruchs gesammelt wurden. Aus diesen Daten hat man die wichtigsten epidemischen Parameter (zum Beispiel die Übertragungsrate) geschätzt. Im 21. Jahrhundert wird auch diese Wissenschaft auf die „Big Data“-Ebene gehoben. Die wichtigsten Fragen werden heute durch die Sequenzierung viraler Genome und die bioinformatische Analyse dieser Sequenzdaten untersucht, um sie mit molekularer Präzision zu beantworten:
- Welches Virus verursacht den Ausbruch? Ist das Virus neu oder ein wiederauftretendes bekanntes Virus?
- Wie wird das Virus übertragen?
- An welchem Ort hat der Ausbruch begonnen? Von welchem Wirt stammt das Virus?
- Welche ökologischen Faktoren unterstützen seine Entstehung?
- Wie viele Übertragungen von Tier auf Mensch hat es gegeben und zu welchem Zeitpunkt?
- Wann begann der Ausbruch? Gab es vor dem ersten gemeldeten Fall einen Zeitraum der unentdeckten Übertragung?
- Hängt der Ausbruch mit einem früheren Ausbruch zusammen?
- Wie entwickelt sich das Virus weiter? Gibt es Hinweise auf eine lokale Anpassung der Viren?
Sequenzierdaten sind deswegen so interessant, weil sich Viren (insbesondere RNA-Viren) schnell vermehren und ihre Genome sich rasant verändern können, sodass am Ende eines Ausbruchs nicht mehr die gleiche Genomsequenz vorliegt, wie zu Beginn. Diese Veränderungen lassen sich mittels Sequenzierdaten nachvollziehen und die Ausbreitung der Viren dadurch besser verstehen. Heutige Sequenziertechniken sind dazu in der Lage, virale Genome in Echtzeit (und zu relativ geringen Kosten) zu erfassen.
Trotz allen Fortschritts ist es uns aber noch immer unmöglich (und es wird wohl auch noch lange so bleiben), die nächste Virus-Epidemie vorherzusagen. Umso wichtiger ist es deshalb, im Falle eines Falles wissenschaftlich fundiert und effizient zu reagieren. Die folgenden Schritte helfen, Epidemien besser zu verstehen und schneller zu bekämpfen:
Den Ausbruch erkennen: Womit haben wir es eigentlich zu tun?
Die meisten Ausbrüche von Infektionskrankheiten beginnen damit, dass Ärzte ungewöhnliche Krankheitsmuster bemerken. Zu Beginn eines Ausbruchs ist es die wichtigste Aufgabe, den Erreger (nicht zwangsläufig ein Virus) zu identifizieren. In der Vergangenheit musste man dafür zum Beispiel zielgerichtet nach bestimmten Proteinen suchen, oder gar mit nichtmolekularen Techniken wie Mikroskopie arbeiten. Dank der Metagenomik benötigen wir nun gar kein Vorwissen über den Erreger und können ihn stattdessen direkt in einem Schritt mittels Sequenzierung identifizieren. Der große Vorteil: damit lassen sich auch neuartige oder unerwartete Viren erkennen. Zudem können sofort einige grundlegende Fragen zum Virus selbst beantwortet werden, zum Beispiel ob wir bereits wirksame Medikamente und/oder Impfstoffe zur Verfügung haben. Basierend auf den Sequenzdaten ist es unter anderem möglich, die evolutionäre Verwandtschaft zu anderen (bekannten) Viren zu untersuchen, die Verbindungen zu früheren Ausbrüchen aufzudecken oder potentielle Wirte zu erkennen.
Den Ursprung aufzeigen: Wie hat alles begonnen?
Unmittelbar nach dem Ausbruch ist die Datenlage oft undeutlich, aber eigentlich ist genau dieser Zeitraum besonders wichtig, um effizient zu reagieren. Eines der Hauptanliegen besteht darin, die Veränderungsrate des Virus und die Ausbreitungsrate in der menschlichen Bevölkerung zu verstehen. Hier hilft die Sequenzierung, indem man sofort die genetische Vielfalt der zirkulierenden Viren untersuchen kann; quasi eine Momentaufnahme der Virusgenomsequenzen der ersten Krankheitsfälle. Je vielfältiger das Virus schon am Anfang eines Ausbruchs ist, desto schneller verändert es sich und desto gefährlicher ist es in der Regel. Die Daten geben auch wichtige Einblicke in die Frage, ob das Virus eher wiederholt von Tier auf Mensch übertragen wurde oder von Mensch zu Mensch weitergegeben wurde.
Die Übertragungsmuster aufklären: Wer infiziert wen?
Die Virusgenomsequenzierung bietet ein enormes Potenzial für die Bestimmung von Übertragungsketten. Die Verfolgung von Übertragungsketten liefert wichtige Informationen, mit denen die Verbreitung von Viren unterbrochen und das Ausmaß eines Ausbruchs verringert werden kann. Traditionell hat man hierfür die Erkrankten nach ihren Kontakten befragt. Das Unterfangen ist nicht nur schwierig, weil es sehr aufwendig ist; es beruht vor allem auch auf der Bereitwilligkeit der Erkrankten, sich befragen zu lassen, deren Ehrlichkeit und Gedächtnis. Die Analyse der Virusgenome liefert wesentlich detailliertere Informationen über die Verzweigungsmuster der Übertragung.
Den Ausbruch kartieren: Wie breitet sich das Virus aus?
Evolutionäre Schlussfolgerungen aus Virusgenomen werden verwendet, um die Ausbreitung des Virus zu analysieren und abzuschätzen, wie sich eine Epidemie über Zeit und Raum entwickeln wird. Dabei werden die räumlichen Muster der Virusausbreitung aufgedeckt und die räumliche Vorgeschichte rekonstruiert. Wichtig ist es vor allem auch, Faktoren zu erkennen, die die Ausbreitung des Virus beeinflussen, insbesondere in Hinblick auf unser globales Reiseverhalten.
Das große Bild erfassen: Wie hängen verschiedene Ausbrüche zusammen?
Die Analyse von Virussequenzdaten über verschiedene Ausbrüche hinweg gewährt Einblicke in die Evolutionsmuster zwischen Epidemien. Die grundlegendste Frage ist wohl, ob das Virus in der Lage war, zwischen den Ausbrüchen in der menschlichen Population zu überleben, oder der erneute Ausbruch wieder durch eine Übertragung vom Tier ausgelöst wurde. Die Ebola-Epidemien, die seit den 1970er Jahren relativ häufig aufgetreten sind, begannen zum Beispiel alle durch Übertragung von Tieren (vermutlich Fledermäusen).
„Big Data“ und „Open Science“
Damit ein Virenausbruch so gründlich und effizient untersucht werden kann, wie eben beschrieben, sind die Forscher vor allem auf den rechtzeitigen Zugang zu klinischen Proben und Daten angewiesen. Dafür ist es notwendig, dass Kliniken, Gesundheitsbehörden, lokale Einsatzkräfte und Wissenschaftler Hand in Hand arbeiten. Dabei sind die reinen Virensequenzen nur ein Bruchteil der benötigten Information. Um eine klinische Probe sinnvoll analysieren und in den Kontext einordnen zu können, braucht es einen Mindestsatz von Metadaten, insbesondere das Datum und den Ort der Probenentnahme und/oder des ersten Auftretens der Symptome. Für die Untersuchung der räumlich-zeitlichen Geschichte und die Ausbreitung eines Ausbruchs helfen Daten über die Reise- und Kontakthistorie der Erkrankten, die vermutete Infektionsquelle, die zeitliche und räumliche Verteilung der Erkrankungen, die zugrundeliegenden ökologischen Bedingungen und Umweltfaktoren. Auch Informationen wie Alter, Geschlecht und wirtschaftlicher Status können dazu beitragen, Risikofaktoren der Infektion aufzudecken.
Besonders wichtig ist in diesem Zusammenhang das „Open Science“-Konzept. Ein Virus sofort sequenzieren zu können hilft nur, wenn die in verschiedenen Laboren sequenzierten Genome auch miteinander verglichen und gemeinsam analysiert werden können. Es ist also dringend erforderlich, dass Daten während laufender Epidemien unmittelbar verbreitet werden und nicht erst nachdem eine entsprechende wissenschaftliche Publikation veröffentlicht wurde. Genau genommen nicht nur die Daten, sondern auch die (informatischen) Methoden, die zu deren Analyse entwickelt wurden. Offene Wissenschaft führt nicht nur zu genaueren wissenschaftlichen Einsichten, sondern hilft auch, die relevanten Informationen schnell in die Hände von Entscheidungsträgern zu befördern. Oder anders gesagt: Wem nützt schon die Nature/Science-Publikation, wenn wir letztlich alle dem Apokalypse-Virus zum Opfer fallen?
Tracking virus outbreaks in the twenty-first century.
Grubaugh ND, Ladner JT, Lemey P, Pybus OG, Rambaut A, Holmes EC, Andersen KG.
Nat Microbiol. 2019;4(1):10-19.
The post Apokalypse-Virus: Hollywood oder Realität? first appeared on BioinfoWelten.
]]>The post Die Geschichte der Erforschung des chemischen Universums first appeared on BioinfoWelten.
]]>Um die wissenschaftlichen Entdeckung der Chemie aus mehr als 200 Jahren zu analysieren, haben die Autoren natürlich nicht tausende Veröffentlichungen gewälzt, sondern die Geschichte der Chemie mit einem vollständig datengetriebenen Ansatz aufgerollt. Soll heißen, sie haben sich die größte Reaktionsdatenbank geschnappt, die bis ins 19. Jahrhundert zurückreicht und in der sich etwa 42 Millionen Reaktionen mit über 20 Millionen Substanzen befinden, und darauf eine Menge Statistiken berechnet.
Das „chemische Universum“ umfasst alle möglichen chemischen Strukturen, von kleinen Molekülen wie Wasser, bis zu riesigen Molekülen wie Proteinen. Dazu zählen sowohl Substanzen, die auf natürliche Weise vorkommen, aber auch Substanzen, die chemisch synthetisiert werden müssen, das heißt durch eine Reaktion von zwei oder mehreren Verbindungen hergestellt werden. Jedes Jahr dehnt sich das „chemische Universum“ um 4,4 Prozent aus, das heißt, jedes Jahr werden 4,4 Prozent neue chemische Strukturen entdeckt; davon etwa die Hälfte durch Synthese. Und das relativ konstant seit 1800. „Relativ“, weil dieses Wachstum natürlich auch Schwankungen unterlag, unter anderem durch gesellschaftliche, aber auch durch wissenschaftliche Ereignisse.
Die drei Zeitalter der Strukturchemie
Wissenschaftlich lassen sich in den Daten drei verschiedene Perioden erkennen, deren Übergänge sich überraschenderweise ziemlich scharf abtrennen lassen: das protoorganische, das organische und das organometallische „Zeitalter“. Während der Übergänge zwischen den Zeitaltern waren die Wachstumsraten leicht gestört, aber die Chemie kehrte schnell zu ihrem Wachstumstrend von 4,4 Prozent zurück.
Im protoorganischen Zeitalter (1800–1860) und vor allem in den ersten Jahren, schwankte die jährliche Wachstumsrate noch recht stark. In diesem Zeitalter dominierten anfangs Kohlenstoff- und Wasserstoff-Verbindungen, später Verbindungen auf Kohlenstoff-, Wasserstoff-, Stickstoff-, Sauerstoff- und Halogenbasis. In dieser Zeit wurde der chemische Raum noch hauptsächlich durch Extraktion von Substanzen aus tierischen und pflanzlichen Produkten erweitert; Synthese fand wenn, dann basierend auf typisch anorganischen Verbindungen statt.
Im zweiten Zeitalter, dem organischen Zeitalter (1861–1980), wurden neue Substanzen bereits mit einer viel größeren Regelmäßigkeit entdeckt. Diese Regelmäßigkeit lässt sich wissenschaftlich auch mit der Einführung der Valenz- und Strukturtheorie in Verbindung bringen, die die Forschung in der organischen Chemie um 1860 veränderte. Ab da gingen die Chemiker in ihrer Arbeit wesentlich planmäßiger vor und die Neuentdeckungen waren dadurch weniger vom Zufall bestimmt als in der Epoche zuvor.
Im organometallischen Zeitalter (1981-heute) erlebten die Metallverbindungen ein Revival, sowohl als Ausgangsstoffe als auch als Endprodukte chemischer Reaktionen. Zehn Prozent der neuen Verbindungen basierten auf Platinmetallen. Siliciumverbindungen, bisher kaum beachtet in der Geschichte der Chemie, wurden zu Stars. Noch stärker als in der vorherigen Epoche wurde regelmäßig eine Verbindung nach der anderen synthetisiert. Ab etwa 1995 gewannen vor allem bioorganische Verbindungen an Interesse.
Das „Abgrasen“ des chemischen Universum
Interessanterweise wurden nicht nur neue Strukturen entdeckt, sondern auch neue Stoffzusammensetzungen, also die Menge an Elementen, aus denen die Moleküle bestehen (unabhängig von deren Verhältnis, vgl. Summenformel). Unangefochten auf Platz 1 stehen seit 1890 die Substanzen, die sich rein aus Kohlenstoff, Wasserstoff, Stickstoff und Sauerstoff zusammensetzen. Alles in allem wurde das „chemische Universum“ also bisher eher ohne rechten „Plan“ abgegrast. Nur wenige der Stoffzusammensetzungen sind überhaupt ausführlich untersucht.
Einfluss gesellschaftlicher Ereignisse: Chemie in Zeiten der Weltkriege
Wie zu erwarten, hatten die beiden Weltkriege einen drastischen Einfluss auf die Wissenschaft und führten zum vorübergehenden Einbruch in der Anzahl der neu entdeckten chemischen Substanzen. Die Auswirkungen des Ersten Weltkriegs waren besonders verheerend, insbesondere weil sich die chemische Industrie und Forschung in der Zeit vor dem Ersten Weltkrieg auf Deutschland konzentrierte. Im Nachhinein führte der Krieg zu einem raschen Aufstieg der Chemie in anderen Ländern, insbesondere den USA. Vielleicht auch deshalb waren die Auswirkungen des Zweiten Weltkrieges auf die Anzahl chemischer Neuentdeckungen weniger stark zu spüren. Nach beiden Kriegen erholte sich die chemische Forschung (so wie auch andere Forschungsgebiete) von diesen Rückschlägen relativ schnell und kehrte zu ihrer Wachstumskurve von etwa 4,4 Prozent pro Jahr zurück.
Die Kriege führten aber auch zu einer Verlagerung der chemischen Forschung. Während des Ersten Weltkriegs nahm unter anderem die Bedeutung von Arsen-, Antimon- und Bismut-Verbindungen zu, während die von Aluminium, Gallium, Indium und Thallium abnahm. Das Interesse an Arsen-Verbindungen erklärt sich vermutlich durch die verschiedenen im Ersten Weltkrieg entwickelten Arsen-Kampfstoffe. Während des Zweiten Weltkrieges wurden Stickstoffverbindungen und Alkalimetalle zunehmend uninteressant, während Schwefel, Bor, Phosphor und Silicium an Interesse gewannen. Phosphorverbindungen wurden vor allem relevant, als ihr Rolle in alltäglichen Anwendungen und als neuartige Insektizide und andere industrielle Materialien bekannt wurde.
Die Lieblinge der Chemiker
Interessanterweise, waren und sind die Chemiker recht konservativ bei der Wahl ihrer Ausgangsstoffe. Die meisten Substrate werden nur ein einziges Mal als Ausgangsstoff verwendet; die „Lieblingsstoffe“ jedoch immer wieder. Ein möglicher Grund ist sicher die leichte Verfügbarkeit dieser Substanzen. In der Tat umfassen die meisten Reaktionen typischerweise zwei Ausgangsstoffe: eine weniger bekannte Substanz und einen „Klassiker“ aus dem Synthesewerkzeugkasten. Zu Beginn des 19. Jahrhunderts waren vor allem starke Säuren und Basen beliebt, später vor allem organische Substanzen. Einer der Topstars ist Essigsäureanhydrid, das 1852 synthetisiert wurde und seit 1880 besonders gern für Acetylierungsreaktionen verwendet wird. Eine Acetylierung ist der Austausch von einem Wasserstoffatom durch eine Acetylgruppe (C2H3O), wobei entsprechende Verbindungen entstehen (zum Beispiel Aceton, Heroin oder Himbeerketon, die Hauptgeruchskomponente von Himbeeren).
Wie geht’s weiter?
Alles in allem wirft die Studie die Frage auf, warum die Chemie trotz gesellschaftlicher und wissenschaftlicher Störfaktoren eine so stabile Wachstumsrate von 4,4 Prozent beibehält? Die Forscher basteln derzeit an formalen Modellen, um diese Frage weiter zu untersuchen. Ich bin gespannt!
Exploration of the chemical space and its three historical regimes.
EJ Llanos, W Leal, DH Luu, J Jost, PF Stadler, G Restrepo.
Proc Natl Acad Sci USA, pii: 201816039, 2019
The post Die Geschichte der Erforschung des chemischen Universums first appeared on BioinfoWelten.
]]>The post Auf der Suche nach einem Wirkstoff gegen das Hepatitis-E-Virus first appeared on BioinfoWelten.
]]>
Liebe Freunde der Bioinformatik, lange Zeit habe ich nichts von mir hören lassen. Das Problem: Zeitmangel! Wobei die mangelnde Zeit weniger das Schreiben an sich betrifft. Das fällt mir leicht und geht recht schnell. Aber die Recherchearbeit, die hinter den meisten meiner bisherigen Blogbeiträge steckt, passt zeitlich einfach nicht mehr in meinen Berufs- und Familienalltag.
Trotzdem möchte ich den Blog nicht sterben lassen, denn er ist mir immer noch eine Herzensangelegenheit. Wissenschaftskommunikation finde ich extrem wichtig; denn was nützen die spannendsten wissenschaftlichen Erkenntnisse, wenn sie immer nur einem kleinen Kreis bekannt sind? Und mit diesem kleinen Kreis meine ich nicht einmal Wissenschaftler allgemein, sondern nur genau die Menschen, die am selben Thema forschen. Das ist einfach zu wenig!
Deswegen habe ich mir vorgenommen, hier häufiger Zusammenfassungen aktueller Publikationen zu schreiben, die sowieso auf meinem Lesestapel liegen. Hauptsächlich werde ich nun also über Viren (nicht die aus dem Computer, sondern die realen) und Viren-Bioinformatik schreiben. Vorteil für euch: Die Themen sind brandaktuell!
Hepatitis: Entzündung der Leber
Los geht’s heute mit einem Review Paper über das Hepatitis-E-Virus. Reviews sind Übersichtsartikel, die den allgemeinen Stand der Forschung zusammenfassen. Dankenswerterweise machen sich Forscher hier und da die Mühe, solche Übersichten zu verfassen und ersparen damit anderen Forschern eine Menge Recherchearbeit. In der Publikation, die ich eben gelesen habe, geht es um den Stand der Entwicklung von Wirkstoffen gegen das Hepatitis-E-Virus.
Das Hepatitis-E-Virus (kurz HEV) verursacht (wie der Name schon andeutet) eine Hepatitis, also eine Entzündung der Leber. HEV verursacht mehr Fälle von akuter Hepatitis als jedes andere humane Hepatitis Virus (Hepatitis A, B, C, D). HEV wird hauptsächlich über kontaminiertes Trinkwasser übertragen, aber auch durch unzureichend gekochtes Fleisch oder durch Kontakt mit infizierten Tieren wie Schweinen, Wildschweinen und Rehen. In Deutschland haben etwa 17% der Menschen Antikörper gegen HEV, können sich also nicht mit einer Hepatitis infizieren. Die meisten HEV-Infektionen verlaufen ohne wesentliche Symptome. Es gibt aber auch Risikogruppen und zwar, wie bei den meisten Infektionen, Menschen mit geschwächtem Immunsystem und Schwangere. Bei Schwangeren führt eine Infektion in rund einem Viertel der Fälle zum Tod. Die derzeitigen Therapiemöglichkeiten gegen HEV beschränken sich auf die Anwendung unspezifischer Virostatika, also Medikamente, die die Vermehrung von Viren allgemein hemmen.

Was können wir tun, um neue Medikamente, die ganz gezielt gegen das Hepatitis-E-Virus wirken, zu finden?
Es gibt mehrere Wege auf der Suche nach einem wirksamen Mittel gegen HEV: (1) die Suche nach völlig neue Wirkstoffen, (2) das Testen bereits vorhandener Medikamente gegen andere Infektionen auf ihre Wirksamkeit gegen HEV und (3) die Suche nach möglichen „Angriffspunkten“ im Virus oder im Wirt, um daraufhin gezielte Medikamente zu entwickeln.
Von Neuem und Altbekanntem
Auf der Suche nach neuen Wirkstoffen, stießen Forscher zum Beispiel auf die antivirale Aktivität von Ethanolextrakten aus Pflanzen (einer ostasiatischen Primelart und einem koreanischen Spargelgewächs) gegen HEV. Welcher Wirkstoff genau gegen die Viren wirkt, hat man jedoch nicht untersucht, ebenso wenig Giftigkeit, die Möglichkeit der Resistenz gegen das Mittel, geschweige denn die Wirksamkeit im lebenden Organismus.
Beim Testen bereits bekannter Wirkstoffe ist es naheliegend, zuerst einmal auf Mittel gegen andere Hepatitisinfektionen zurückzugreifen. Sofosbuvir zum Beispiel ist ein Wirkstoff zur Behandlung der chronischen Hepatitis C, und ist derzeit der einzige Kandidat in klinischen Studien gegen HEV. Vorläufige Ergebnisse deuten aber darauf hin, dass dies kein Durchbruch in der HEV-Therapie sein wird. Seine antivirale Wirksamkeit ist mäßig, es könnte aber in Kombination mit den oben genannten unspezifischen Virostatika weiter untersucht werden.
Silvestrol ist ein Naturstoff, der ausschließlich in Mahagonigewächsen vorkommt. Silvestrol ist eigentlich aus der Krebstherapie bekannt, wurde aber auch schon als Virenhemmer beschrieben. Silvestrol blockiert die Translation der Viren. Der Wirkstoff ist vergleichsweise gut charakterisiert und ein vielversprechender Kandidat in der Behandlung gegen HEV; besonders in Fällen, in denen die eingangs genannten unspezifischen Virostatika bereits unwirksam sind. Ein weiterer Schritt ist nun zum Beispiel die Erforschung möglicher Resistenzen.
Das Ziel ist der Weg
Ein weitaus vielversprechenderer Weg um neue Medikamente zu finden, ist, zuerst einmal nach möglichen „Angriffspunkten“ für diese Medikamente zu suchen. Das können sowohl Angriffspunkte am Virus selbst sein, aber auch wirtseigene Faktoren, die für den viralen Lebenszyklus notwendigen sind. Denn Viren haben in der Regel sehr kleine Genome (also sehr wenig „Lebensinformation“) und sind daher stark von ihren Wirten abhängig, um ihren Lebenszyklus zu vervollständigen. Diese Abhängigkeit vom Wirt ist ein möglicher Angriffspunkt. So kann man zum Beispiel versuchen zu verhindern, dass die Viren überhaupt in die menschlichen Zellen eindringen.
Das oberste Ziel wäre es, Wirkstoffe zu entdecken, die spezifisch auf die viralen Enzyme abzielen, zum Beispiel auf die HEV-Polymerase, die zur Vermehrung des Virus unabdingbar ist. Diese sogenannten „direkt wirkenden Virostatika“ sind hochspezifisch und waren zum Beispiel bei der Behandlung von Hepatitis C ein Durchbruch mit hohen Heilungsraten. Um einen solchen Wirkstoff zu entwickeln, ist es jedoch unabdingbar, die Struktur des Enzyms genau aufzuklären. Leider wurde bisher keiner der potentiellen Anti-HEV-Wirkstoffe auf der Grundlage einer solchen Enzymstruktur entworfen.
Ein weiterer Eckpfeiler bei der Bekämpfung von HEV wird die Identifizierung neuer Wirtsfaktoren sein, denn auch hier sind bisher nur wenige bekannt. Hier müssen alle „omics“ Bereiche untersucht werden, um die veränderte zelluläre Umgebung während einer HEV-Infektion zu entschlüsseln. Auf der Suche nach möglichen „Angriffspunkten“ ist die Bioinformatik ein unerlässliches Instrument, von der Aufklärung der Enzymstrukturen der Viren bis hin zum Verständnis der Immunreaktion des Menschen.
Impfen
Ein Möglichkeit, die ich bisher noch gar nicht erwähnt habe, wäre, einen Impfstoff gegen HEV zu entwickeln. Ein Impfstoff befindet sich bereits in klinischer Erprobung und wurde in China sogar bereits zugelassen. Es gibt aber auch hier noch viele offenen Fragen, allen voran die Wirksamkeit bei Risikopatienten und ob man sich zur Bekämpfung einer HEV-Epidemie ausschließlich auf einen Impfstoff verlassen kann.
Am Rande sei noch erwähnt, dass keiner der in diesem Artikel vorgestellten Medikamentenkandidaten für die Anwendung bei schwangeren Frauen zugelassen ist.
Publikation: Hepatitis E Virus Drug Development. V Kinast, T L Burkard, D Todt, E Steinmann. Viruses 2019, 11(6), 485.
The post Auf der Suche nach einem Wirkstoff gegen das Hepatitis-E-Virus first appeared on BioinfoWelten.
]]>