Jedną z popularniejszych technik wektoryzacji tekstu jest algorytm TF-IDF (Term Frequency – Inverted Document Frequency).
Jaka jest zasada jego działania?
Celem działania algorytmu jest przedstawienie dokumentu w formie liczbowej, wektora wag przedstawiającego wpływ konkretnych słów zawartych w dokumencie na jego znaczenie merytoryczne, semantyczne. Algorytm wyznacza wektor opisujący dokument na podstawie tekstu przy czym każde słowo w tekście ma swoją wagę, zależną od częstotliwości występowania słowa w dokumencie oraz liczbie dokumentów w zbiorze w jakiej znajduje się słowo. Sam algorytm to tak naprawdę połączenie dwóch metod.
Term Frequency odpowiada za zliczanie występowania słowa w dokumencie. Działanie kroku Term Frequency pozwala także na odsianie pewnych słów z procesu wektoryzacji na podstawie częstotliwości ich występowania w dokumencie lub zbiorze, np. pod uwagę mogą nie być brane słowa, które występują w ponad 30% artykułów.
Celem takiej filtracji jest odsianie tzw. stop-words, słów które nie mają większego znaczenia semantycznego w tekście, są tylko spójnikami w zdaniach pomiędzy podmiotem i orzeczeniem, pomiędzy wyrazami stanowiącymi o sensie zdania.
Przykład z tego tekstu:
Działanie kroku Term Frequency pozwala także na odsianie pewnych słów z procesu wektoryzacji na podstawie częstotliwości ich występowania w dokumencie lub zbiorze
Zastanowić się należy jakie wyrazy mają lub jakie wyrazy nie mają wartości semantycznej w tym zdaniu. Pierwszą kategorią odsianych słów byłyby spójniki, zaimki i przyimki, z cytowanego zdania w pierwszej kolejności mogłyby zostać odsiane słowa: na, z, ich, w, lub, także. Zdanie zostałoby więc podzielone na następujące wyrazy:
[Działanie, kroku, Term, Frequency, pozwala, odsianie, pewnych, słów, procesu, wektoryzacji, podstawie, częstotliwości, występowania, dokumencie, zbiorze]
A wektor częstotliwości wyglądałby podobnie jak tutaj:
[1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1]
Oczywiście, wektor częstotliwości zależny byłby nie tylko od zdania ale od całego tekstu oraz wszystkich dopuszczonych wyrazów w procesie wektoryzacji. Metoda ta jest także wrażliwa na odmiany wyrazów a w języku polskim odmianie podlegają nawet nazwy własne, imiona, nazwiska itp.
Inverted Document Frequency ma za zadanie obliczenie znaczenia wybranego słowa w dokumencie na podstawie ilości dokumentów zawierających to słowo.
Mówiąc w prostych słowach, większy wpływ na znaczenie semantyczne danego dokumentu tekstowego ma wyraz, który znajduje się w mniejszej liczbie dokumentów. Słowo, znajdujące się w wielu dokumentach może być wzięte właśnie za stop-word.
Wzór z którego przeważnie wyliczana jest waga słowa jest następujący:
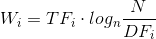
a można go rozszyfrować następująco:
Waga i-tego słowa Wi równa jest częstotliwości występowania i-tego słowa w dokumencie i mnożona razy logarytm o podstawie n z ilorazu wielkości zbioru dokumentów przez częstotliwość występowania słowa w dokumencie.
Logarytm jest opcjonalny i stosowany tutaj w celu zwiększenia znaczenia wartości Term Frequency na wagę słowa.
I to właściwie tyle ile można napisać o Inverted Document Frequency. Można tutaj dodać fakt, że ta metoda pozwala na odsianie słów występujących w zbyt wielu dokumentach.
Wracając jeszcze do metody Term Frequency i ogólnie tworzenia słownika słów biorących udział w procesie wektoryzacji.
Niektóre wyrażenia używane w języku mają większy sens i znaczenie występując razem, w parach, trójce czy dłuższych. Mogą to być tytuły, nazwy firm, marek, imiona wraz z nazwiskami, jakieś zwroty potoczne.
n-gramy są to w skrócie zbiory kolejno występujących po sobie słów z szyku zdania. 1-gramy (unigramy) będą pojedynczymi słowami, 2-gramy (bigramy), będą parami słów, 3-gramy (trigramy) trójkami itd.
Z pewnością korzyść na jakość procesu wektoryzacji może mieć znalezienie poprawnych n-gramów w tekście.
Metoda wyszukiwania n-gramów działa trochę naiwnie, tworząc n-ramy z kolejnych możliwych słów, co nie wpływa ani na wydajność procesu ani na jego precyzję. Szacowane jest jednak prawdopodobieństwo tego, czy dana para lub inna zbitka wyrazów tworzy razem jakieś znaczenie i odrzucane są n-gramy, które są poniżej pewnego określonego progu.
Zainteresowanych procesem wyznaczania prawdopodobieństwa dla n-gramów odsyłam do wikipedii jako dobry start to zrozumienia tej metody.
Inną rzeczą o której warto wspomnieć przy wektoryzacji, jeśli o czymś nie zapomniałem jest normalizacja utworzonych wektorów wag. Jako, że dokumenty nie będą zawierać wszystkich branych pod uwagę w tym procesie słów a zdecydowanie częściej nie będą zawierać większości z nich, w tych miejscach będą wpisywane zwyczajnie zera. Jaki z tym problem? Ano taki, że te zera będą miały duży wpływ na odległość wektorów nie ze względu na treść a ze względu na podobnie małą ilość tekstu w tych dokumentach. Dlatego proces normalizacji ma zwiększyć znaczenie pozycji niezerowych w utworzonych wektorach. Zainteresowanych metodami normalizacji, odsyłam do wikipedii do hasła o p-normach, używanych do normalizacji w środowisku Apache Mahout o którym wspomnę w przyszłości jak i prawdopodobnie jeszcze o p-normach i normalizacji.
]]>What does Document Clustering is about?
So, to explain Document Clustering it is good idea to define what is Clustering in general before.
Human is a being that likes to join things like objects, facts persons into groups or categories (here let’s call their clusters) to better or easier understand a world around. Let’s get people as an example. Imagine that you go the street and describe people you pass by sentences like: old man, another old man, nice girl, not very nice girl etc. We could describe them by their age, height, hair colour, style of wearing etc. In short, we could find many informations their would be categorised by.
So, what is this Clustering?
By definition we could say, clustering is a process of assignment of objects into groups where object in group is more similar to objects in this group than to all other groups. Result of this process are object of upper class (of abstraction), groups in which objects should be homogeneous or at least similar to each others.
What does that definition tell us?
So, having a set that contais some undefined strictly number of people we want to cluster, result should be groups where in range of group people would be related by some attribute that was used to describe them. Did we describe people by their hobbys, here we are, the result going to be groups related to same or similar hobby.
How does it look in practice?
Clustering is operation on a points.
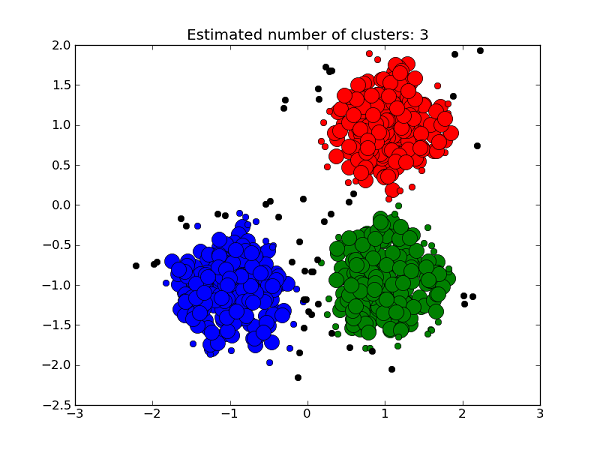
Exacly. Points are grouped by distance between them and that’s how they are assigned to clusters. In most cases there is estimated a center point of cluster, centroid and then points are assigning to the nearest centroids.
Coming back to our example with people. How could we „clusterize” people if clustering algorithms work on points, numbers?
The way to do that is called vectorization. It is a proccess that converts more abstract objects like documents (or people as in example) into form of numbers. Products of this process, vectors are matrices with one column (or row if matrix is transformed). Each element of vector is related to one property’s numeric representation. Value of element means a weight, a extent of related attribute with object.
Let’s say we want to describe some group of people with wectors. We get 3 properties describing them, the easiest properties to vectorize would be: age, height and weight as they are numbers.
So, vector looks like:
[age, height, weight]
For example: [18, 182, 85], [25, 164, 58], [35, 170, 89], [53, 179, 88].
We’ve got a point in 3D space that describes people by mentioned attributes then it should not be a problem to create groups with similarities of age, height or weight. Obviously 4 points are not enough to do this effectively, so we need it more.
But wait.
As we know, clustering bases on distances. Having unregular data like that, I mean, influence of height or weight would be much bigger than influence of age on distribution of points, distances between them. Good idea would be weighting of values. For instance a value of element would be a quotient of some maximum value or value’s probability from normal distribution.
How does it work with documents?
It is very similar way to clustering documents that present as example before. Documents are converted into vectors by weight of word inside, calculated from analysis whole set of documents. Next, the multidimensional points are assigned to clusters by distances from each others. Description of algorithms to create vectors from text and to clustering are topics for another post.
]]>Jest to mój pierwszy wpis w którym chciałbym przedstawić podstawy teoretyczne klasteryzacji dokumentów, tematu w ostatnim czasie mi bliskiemu.
Czym jest owa klasteryzacja dokumentów?
Aby ją opisać, pierw należy zdefiniować czym jest sama klasteryzacja.
Człowiek z natury ma skłonność do grupowania pewnych obiektów, rzeczy, faktów a także ludzi w większe klasy, grupy, kategorie lub zgodnie z tytułem nazwijmy je klastrami. Niech przykładem w tym artykule będą ludzie. Idąc ulicą i opisując kolejnych ludzi których mijamy moglibyśmy rzucać stwierdzeniami typu: starszy pan, następny starszy pan, ładna kobieta, brzydka kobieta, kuc i tak dalej. Moglibyśmy opisywać ich według ich wieku, wzrostu, koloru włosów, typu ubrania. Słowem znaleźlibyśmy wiele dziedzin w jakich moglibyśmy skatalogować ludzi.
Czym jest więc klasteryzacja?
Jeśliby przedstawić jej definicję, można stwierdzić, że klasteryzacja to proces takiego przydziału obiektów do grup do których skatalogowany obiekt należy do klastra do którego należy w większym stopniu niż do pozostałych. Wynikiem procesu klasteryzacji są obiekty wyższego rzędu, grupy, skupiające wewnątrz jednorodne grupy obiektów.
Co nam mówi ta definicja?
Cóż, mając zestaw zawierający pewną liczbę osób, którą chcemy poddać klasteryzacji, wynikiem byłyby grupy osób, które w ramach grupy łączyłaby wspólna cecha, taka która zostałaby użyta do oceny konkretnej osoby. Czy osoby opisane są poprzez zainteresowania? Proszę bardzo, wynikiem będą grupy ludzi o tych samych / podobnych zainteresowaniach.
Jak to wygląda w praktyce?
Klasteryzacja jest działaniem na punktach.
Dokładnie. Punkty grupowane są według odległości od siebie i według odległości przypisywane do klastrów. Przeważnie wyznaczany jest pewien punkt środkowy klastra, tzw. centroid, i wszystkie punkty przypisywane są do najbliższych centroidów, stąd każdy punkt w klastrze jest bliżej środka własnego klastra niż pozostałych środków.
Wróćmy do naszego przykładu z ludźmi. Jak niby mamy „sklasteryzować” ludzi, jeśli klasteryzacja działa tylko na punktach.
Da się ich jakoś zamienić?
Oczywiście, że się da. I ludzi i dokumenty tekstowe, które też punktami nie są a klasteryzowalne są. Proces odpowiedzialny za zamianę bardziej abstrakcyjnych na formę liczbową nazywany jest wektoryzacją. Wektory, czyli produkty tego procesu są macierzami o jednej kolumnie (a po transformacji o jednym wierszu). Każdy wiersz, czy może ściślej, każdy element wektora przyporządkowany jest jednej cesze. Wartość wektora w danym miejscu odpowiada zwyczajnie wadze, stopniu przynależności do tych cech.
Posłużę się znów moimi obiektami doświadczalnymi.
Załóżmy, że chcemy zamienić cechy określonej grupy ludzi na wektory. Niech będą to 3 cechy, które łatwo można określić liczbami, przyjmijmy, że pierwszy element wektora będzie oznaczał wiek, drugi wzrost, trzeci wagę.
[wiek, wzrost, waga]
I stwórzmy przykładowe wektory ludzi:
[18, 182, 85], [25, 164, 58], [35, 170, 89], [53, 179, 88].
Tak więc mamy punkty określające ludzi, a przynajmniej pewne ich cechy. Mając takich wektorów więcej można przeprowadzić klasteryzację wektorów i pogrupować ludzi według ich wagi, wzrostu i wieku.
Ale ale, nie tak szybko.
Wiedząc, że klasteryzacja działa w oparciu o odległości pomiędzy punktami, mając tak nieregularne dane, wpływ wzrostu lub wagi może mieć większy wpływ na wygląd zbioru niż wieku. Stąd dobrym pomysłem jest wpisywanie konkretnych wag do wektorów zamiast konkretnych wartości. Przykładowo mogą to być ilorazy wartości i predefiniowanej maksymalnej wartości. Innym pomysłem mogłoby być prawdopodobieństwo wynikające z rozkładu normalnego dla danej wartości.
Jak to wygląda w przypadku dokumentów?
Bardzo podobnie. Dokumenty zamieniane są na wektory a wartościami wektorów są konkretne wagi dla słów (i/lub) zwrotów znajdujących się w dokumencie wyliczanych na podstawie analizy całego zbioru dokumentów. Następnie tak utworzone wielowymiarowe punkty są klasteryzowane według odległości punktów od siebie. Opis algorytmów tworzących wektory dokumentów i klasteryzacji to już temat na inny wpis.
]]>