--shell bestimmt werden.
Die Warnungen von ShellCheck bei Bash-Scripten sind eher konservativ gehalten, so dass eine Behebung der angezeigten Fehler nicht unnötigerweise „Bashismen“ erzeugt. Ein moderner Coding-Style mit doppelten statt einfacher Klammern, wie z. B. im Shell Style Guide von Google gefordert, ließe sich aber mit dem optionalen Check require-double-brackets forcieren. Mit der Option --list-optional können die in der jeweiligen Version von ShellCheck verfügbaren optionalen Checks inklusive Beschreibung und Beispiel-Code mit Fix aufgeführt werden, beispielsweise für die Version 0.11.0:
$ shellcheck --version
ShellCheck - shell script analysis tool
version: 0.11.0
license: GNU General Public License, version 3
website: https://www.shellcheck.net
$ shellcheck --list-optional
name:    add-default-case
desc:    Suggest adding a default case in `case` statements
example: case $? in 0) echo 'Success';; esac
fix:     case $? in 0) echo 'Success';; *) echo 'Fail' ;; esac

name:    avoid-negated-conditions
desc:    Suggest removing unnecessary comparison negations
example: [ ! "$var" -eq 1 ]
fix:     [ "$var" -ne 1 ]

name:    avoid-nullary-conditions
desc:    Suggest explicitly using -n in `[ $var ]`
example: [ "$var" ]
fix:     [ -n "$var" ]

name:    check-extra-masked-returns
desc:    Check for additional cases where exit codes are masked
example: rm -r "$(get_chroot_dir)/home"
fix:     set -e; dir="$(get_chroot_dir)"; rm -r "$dir/home"

name:    check-set-e-suppressed
desc:    Notify when set -e is suppressed during function invocation
example: set -e; func() { cp *.txt ~/backup; rm *.txt; }; func && echo ok
fix:     set -e; func() { cp *.txt ~/backup; rm *.txt; }; func; echo ok

name:    check-unassigned-uppercase
desc:    Warn when uppercase variables are unassigned
example: echo $VAR
fix:     VAR=hello; echo $VAR

name:    deprecate-which
desc:    Suggest 'command -v' instead of 'which'
example: which javac
fix:     command -v javac

name:    quote-safe-variables
desc:    Suggest quoting variables without metacharacters
example: var=hello; echo $var
fix:     var=hello; echo "$var"

name:    require-double-brackets
desc:    Require [[ and warn about [ in Bash/Ksh
example: [ -e /etc/issue ]
fix:     [[ -e /etc/issue ]]

name:    require-variable-braces
desc:    Suggest putting braces around all variable references
example: var=hello; echo $var
fix:     var=hello; echo ${var}

name:    useless-use-of-cat
desc:    Check for Useless Use Of Cat (UUOC)
example: cat foo | grep bar
fix:     grep bar foo
Optionale Checks können mit der Direktive enable in der User-Konfigurationsdatei ~/.config/shellcheckrc aktiviert werden, so dass ShellCheck diese künftig automatisch mit berücksichtigt, so z. B.:
enable=avoid-negated-conditions
enable=avoid-nullary-conditions
enable=deprecate-which
enable=require-double-brackets
enable=useless-use-of-cat
Von Vorteil sind diese vor allem, da der EditorConfig-Standard zwischenzeitlich von vielen Editoren unmittelbar oder mittels eines Plugins unterstützt wird und so in einem Projekt-Team mit unterschiedlichen Editoren für einheitliche Coding-Styles sorgen kann. In vim 9.1, welches im Repository von Debian Trixie enthalten ist, muss nicht einmal mehr ein Plugin installiert werden, .editorconfig Dateien werden direkt unterstützt. Für ältere vim Versionen existiert das Plugin vim-editorconfig.
Allgemein gehe ich so vor, dass ich globale Coding-Styles, die vor allem für die Bearbeitung von Shellscript- und Konfigurations-Dateien (v.a. durch root) relevant sind, weiterhin in der systemweiten Konfigurationsdatei /etc/vim/vimrc.local definiere:
set autoindent
set expandtab
set tabstop=2
set shiftwidth=2
Ich habe hier eine automatische Einrückung von zwei Leerzeichen gewählt, da dies auch bei vielen Dateien unterhalb von /etc der Fall ist.
In den jeweiligen Projektordnern liegen dann .editorconfig Dateien, deren Anweisungen von vim als vorrangig gegenüber denen der /etc/vim/vimrc oder ~/.vimrc behandelt werden. Beispiel einer .editorconfig Datei für ein Python-Projekt, mit einer automatischen Einrückung von vier Leerzeichen:
root = true

[*]
charset = utf-8
end_of_line = lf
insert_final_newline = true
trim_trailing_whitespace = true
indent_style = space
indent_size = 4
In der .editorconfig Datei für ein WordPress-Plugin kommt dagegen der für WordPress übliche Standard von Einrückung mittels Tabs zum Zuge:
root = true

[*]
charset = utf-8
end_of_line = lf
insert_final_newline = true
trim_trailing_whitespace = true
indent_style = tab
]]>
_dmarc 3600 IN TXT "v=DMARC1;p=quarantine;rua=mailto:dmarc@example.org"
Die Berichte werden als XML-Dateien im Anhang versandt. Der Paketmanager von Debian bietet gleich drei verschiedene Tools zur Installation an, welche die XML-Dateien parsen können: dmarc-cat, dmarc-srg und dmarcts-report-parser. Mit letzterem kann auch direkt auf das IMAP-Konto zugegriffen werden, in welchem die Berichte landen. Die extrahierten Daten werden dabei in einer Datenbank gespeichert.
Da dmarcts-report-parser im Repository von Debian Trixie enthalten ist, ist die Installation einfacher als auf der Github-Seite angegeben:
# apt install dmarcts-report-parser
Nach der Installation muss manuell eine MariaDB oder PostgreSQL Datenbank angelegt werden. In der Datei /etc/dmarcts-report-parser.conf werden dann die Zugangsdaten zu dieser Datenbank eingetragen, ebenso die Zugangsdaten zum IMAP-Konto sowie ggf. – entsprechend den erläuternden Kommentaren – weitere Einstellungen. Bei der Angabe von Unterordnern funktionierte in meinem Fall (Dovecot mit Maildir auf dem Server) die Trennung mit einem Slash nicht, stattdessen mit einem Punkt:
$imapmovefolder = 'dmarc.processed';
Nachdem die Konfigurationsdatei fertiggestellt ist, kann ein erster Prozess angestoßen werden:
# dmarcts-report-parser -i
In der Datenbank sollten dann die Tabellen rptrecord und report mit den geparsten Einträgen gespeichert sein. Wenn alles ordnungsgemäß verlaufen ist, kann in der Datei /etc/default/dmarcts-report-parser der täglich laufende Cronjob bzw. Timer, der bereits bei der Installation von dmarcts-report-parser eingerichet wurde, „scharf geschaltet“ werden:
# This tool/script is run via CRON only if the below IS_CONFIGURED variable is set to "1"
IS_CONFIGURED="1"
Um die Daten der Datenbanktabellen besser zu erfassen, können entsprechende Views eingerichtet werden. So z. B. die neuesten Einträge zuoberst, beschränkt auf die Auswertungsdaten der empfangenden Mailserver:
CREATE VIEW view_dmarc AS
SELECT DATE(rep.maxdate) AS rep_date, rep.domain,
    IF(rec.ip IS NULL, INET6_NTOA(rec.ip6), INET_NTOA(rec.ip)) AS ip, rep.org,
    rec.dkimresult AS dkim, rec.dkim_align, rec.spfresult AS spf, rec.spf_align,
    rec.disposition
FROM rptrecord AS rec
INNER JOIN report AS rep
ON rec.serial = rep.serial
ORDER BY rep_date DESC
Mit einem ergänzendem Statement WHERE disposition != "none" ließe sich der View auch auf die problematischen Einträge beschränken, bei denen Emails geblockt oder in die Quarantäne verschoben wurden.
dovecot expunge ausführt:
#!/bin/bash

/usr/bin/doveadm expunge -u 'joe' mailbox 'xyz' savedbefore 30d
Die Kontrolle in Thunderbird am nächsten Tag ergab, dass zwar die meisten Mails aus dem Ordner ‚xyz‘ mit einem Datum älter als 30 Tage gelöscht waren, eine Mail aus dem letzten Jahr aber noch im Ordner verblieben war. Wie konnte das sein?
Das Schlüsselwort savedbefore bezieht sich auf das Speicherdatum der Mails, welches folgendermaßen von doveadm für die Mails des betreffenden Ordners ausgegeben werden kann:
doveadm -f tab fetch -u 'joe' "uid date.saved" mailbox 'xyz'
Und in der Tat werden dabei keine Datumsangaben älter als 30 Tage angezeigt, doveadm-expunge hat hier also korrekt gearbeitet. Thunderbird zeigt nun nicht das Speicherdatum, sondern das Empfangsdatum der Mails an und dieses lässt sich folgendermaßen von doveadm ausgeben:
doveadm -f tab fetch -u 'joe' "uid date.received" mailbox 'xyz'
Bein einem Vergleich fällt hier die Mail mit der UID 9358 auf:
# doveadm -f tab fetch -u 'joe' "uid date.saved" mailbox 'xyz'
uid	date.saved
....	....
9358	2026-02-03 09:10:01
....	....
# doveadm -f tab fetch -u 'joe' "uid date.received" mailbox 'xyz'
uid	date.received
....	....
9358	2025-05-06 16:53:23
....	....
Empfangen wurde sie bereits im letzten Jahr, gespeichert erst am 03.02. diesen Jahres. Des Rätsels Lösung war letztendlich, dass diese Mail am 03.02. aus einem anderen Ordner in den Ordner ‚xyz‘ verschoben wurde und bei diesem Vorgang wird eine Mail erneut gespeichert!
doveadm bezieht sich mit dem Schlüsselwort savedbefore auf die letztmalige Speicherung der Mails und bei dem Trash-Ordner beispielsweise macht dies ja durchaus Sinn:
/usr/bin/doveadm expunge -u 'joe' mailbox 'Trash' savedbefore 7d
Damit werden Mails gelöscht, nachdem sie sieben Tage im Trash-Ordner verblieben sind (und nicht bereits sieben Tage, nachdem sie erstmalig empfangen wurden)
]]>In einem klassischen Layout mit Header, Sidebar, Footer sollen im Hauptinhaltsbereich (im Element main) zwei Textboxen untergebracht werden. Ist der Hauptinhaltsbereich breiter als 480px, sollen die Textboxen nebeneinander, andernfalls untereinander dargestellt werden. Hinzu kommt, dass die Sidebar nur oberhalb einer Breite von 640px neben dem Hauptinhalt, andernfalls unterhalb angezeigt wird, so wie es in einem responsiven Layout sinnvoll ist.
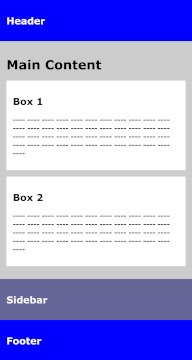
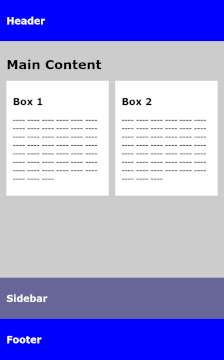
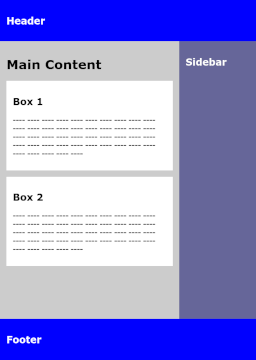
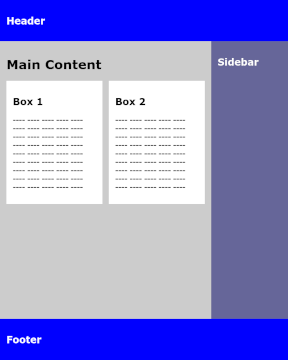
Die folgenden Bilder illustrieren dies. Bei einem sehr schmalen Viewport werden die Textboxen untereinander angezeigt (erstes Bild), bei etwas mehr Breite passen die Textboxen nebeneinander (zweites Bild), bevor die Sidebar den Hauptinhaltsbereich einzwängt (drittes Bild) und erst eine größere Gesamtbreite wieder genug Platz lässt für zwei Textboxen nebeneinander (viertes Bild):
Der HTML-Code des Hautpinhaltes könnte so ausschauen:
<main>
    <h1>Main Content</h1>
    <div id="boxes">
        <div>
            <h2>Box 1</h2>
            <p>...</p>
        </div>
        <div>
            <h2>Box 2</h2>
            <p>...</p>
        </div>
    </div>
</main>
Früher wäre eine sehr komplexe Media-Query mit min-width und max-width notwendig gewesen, um die Bereiche zu erfassen, in denen das Elternelement (hier: div#boxes) als Flexbox definiert wird, so dass die Text-Boxen nebeneinander dargestellt werden:
@media screen and (
  (
    (min-width: 30em)
    and
    (max-width: 39.9375em)
  )
  or
  (min-width: 42em)
) {
  #boxes {
    display: flex;
    gap: 1em;
  }
  #boxes > div {
    flex-grow: 1;
  }
}
Wir haben hier drei Breakpoints. Die mühsam errechneten Angaben müssen mit den logischen Operatoren and und or verknüpft sowie korrekt geklammert werden.
Mit einer Container-Query geht dies sehr viel einfacher. Der Hauptinhaltsbereich (main) wird hier als Container mit dem Namen main definiert:
main {
  container-name: main;
  container-type: inline-size;
}
Anschließend kann eine Container-Query diesen Namen referenzieren:
@container main (width >= 30em) {
  #boxes {
    display: flex;
    gap: 1em;
  }
  #boxes > div {
    flex-grow: 1;
  }
}
Hier können dann ganz einfach die 30em (~ 480px) als Breakpoint gesetzt werden.
]]>systemctl status mariadb gab folgende Fehler aus:
Reading datadir from the MariaDB server failed. Got the following error when executing the 'mysql' command line client

ERROR 1698 (28000): Access denied for user 'root'@'localhost'

FATAL ERROR: Upgrade failed
Schon seit einigen Debian-Versionen erfolgt die Authentifizierung des MariaDB-Users root nicht mehr über eine Passwortabfrage, sondern über einen Unix-Socket. Der Socket war auch aktiv:
Version: '11.8.2-MariaDB-1 from Debian' socket: '/run/mysqld/mysqld.sock' port: 3306 --
Der Linux-Root sollte sich demnach ohne Passwort als MariaDB-User root einloggen können. Genau das funktionierte hier nicht mehr:
$ su -
Password:
# mysql
ERROR 1698 (28000): Access denied for user 'root'@'localhost'
Andere User dagegen können sich problemlos per Passwort einloggen.
Vor dem Debian-Upgrade hatte ich, wie in den Release-Notes empfohlen, den MariaDB-Server gestoppt. Trotzdem schien hier irgendwas schief gelaufen zu sein. Um die Situation als root zu begutachten und ggf. zu bereinigen, startete ich MariaDB über mariadbd-safe mit der Option –skip-grant-tables. Danach war ein passwortloser Login mit dem mysql Client möglich:
# systemctl stop mariadb.service
# mariadbd-safe --skip-grant-tables &
[1] 171235
250902 15:22:55 mysqld_safe Starting mariadbd daemon with databases from /var/lib/mysql
# mysql
Welcome to the MariaDB monitor.  Commands end with ; or \g.
Your MariaDB connection id is 3
Server version: 11.8.2-MariaDB-1 from Debian -- Please help get to 10k stars at https://github.com/MariaDB/Server

Copyright (c) 2000, 2018, Oracle, MariaDB Corporation Ab and others.

Type 'help;' or '\h' for help. Type '\c' to clear the current input statement.
Eine Abfrage nach dem Authentifizierungs-Plugin von root@localhost ergab, dass wie bisher das Plugin unix_socket genutzt wird:
MariaDB [(none)]> FLUSH PRIVILEGES;
MariaDB [(none)]> USE mysql;
Reading table information for completion of table and column names
You can turn off this feature to get a quicker startup with -A

Database changed
MariaDB [mysql]> SELECT Host, User, plugin FROM user WHERE User = 'root';
+-----------+------+-------------+
| Host      | User | plugin      |
+-----------+------+-------------+
| localhost | root | unix_socket |
+-----------+------+-------------+
1 row in set (0.003 sec)
Das FLUSH PRIVILEGES am Anfang ist notwendig, um folgende Änderungen vornehmen zu können. Eine Änderung auf das Plugin mysql_native_password wäre möglich (wobei dann unbedingt auch ein Passwort für root gesetzt werden muss!). Aber ich wollte die Authentifizierungsmethode unix_socket beibehalten. Mein Reparaturversuch sah dann so aus, dass ich die Authentifizierungsmethode zweimal änderte:
MariaDB [mysql]> ALTER USER 'root'@'localhost' IDENTIFIED WITH mysql_native_password;
MariaDB [mysql]> FLUSH PRIVILEGES;
MariaDB [mysql]> ALTER USER 'root'@'localhost' IDENTIFIED WITH unix_socket;
MariaDB [mysql]> FLUSH PRIVILEGES;
MariaDB [mysql]> quit
Nachdem die Instanz von mariadbd-safe beendet und der MariaDB-Server neu gestartet wurde, konnte root sich wieder in MariaDB einloggen – der Reparaturversuch war anscheinend geglückt:
# pkill mariadb
# systemctl start mariadb
# mysql
Welcome to the MariaDB monitor.  Commands end with ; or \g.
Your MariaDB connection id is 3
Server version: 11.8.2-MariaDB-1 from Debian -- Please help get to 10k stars at https://github.com/MariaDB/Server

Copyright (c) 2000, 2018, Oracle, MariaDB Corporation Ab and others.

Type 'help;' or '\h' for help. Type '\c' to clear the current input statement.
Und auch systemctl status mariadb vermeldete statt der vorherigen Fehler den bedarfsweisen Upgrade der Tabellen:
]]>
Upgrading MariaDB tables if necessary.
ERROR 1075 (42000): Incorrect table definition; there can be only one auto column and it must be defined as a key
Vereinfacht war der Aufbau der MyIsam-Tabelle wie folgt:
CREATE TABLE foo_table (
  foo_group tinyint(3) unsigned NOT NULL,
  foo_id int(10) unsigned NOT NULL AUTO_INCREMENT,
  foo_description varchar(255) NOT NULL,
  PRIMARY KEY(foo_group, foo_id)
) ENGINE=MyISAM DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_general_ci;
Der Primary Key der Tabelle foo_table umfasste als Composite Key zwei Spalten: foo_group und foo_id, wobei für foo_id ein auto_increment definiert war.
Eine Abfrage verdeutlicht dies:
MariaDB [foo_db]> select foo_group, foo_id from foo_table;
+-----------+--------+
| foo_group | foo_id |
+-----------+--------+
|         1 |      1 |
|         1 |      2 |
|         1 |      3 |
|         2 |      1 |
|         2 |      2 |
|         3 |      1 |
|         3 |      2 |
|         3 |      3 |
+-----------+--------+
MariaDB [foo_db]>
Der Auto-Increment für foo_id erfolgt demnach nicht global, sondern nur für die jeweilige Gruppe, die durch foo_group definiert ist. Diese Funktionalität ist in InnoDb nicht direkt vorhanden, lässt sich aber mit einem Trigger nachbilden.
Bei einer Konvertierung nach InnoDB muss auch der Auto-Increment entfernt werden, indem foo_id ohne auto_increment neu definiert wird:
ALTER TABLE foo_table
CHANGE foo_id foo_id int(10) unsigned NOT NULL AFTER foo_group,
ENGINE='InnoDB';
Danach kann ein Trigger eingerichtet werden, der bei einem Insert für pro_id den bislang höchsten Wert der entsprechenden Gruppe um 1 erhöht, oder falls noch kein Wert für die Gruppe vorhanden eine 1 zuweist:
DELIMITER $$

CREATE TRIGGER foo_bi BEFORE INSERT ON foo_table
FOR EACH ROW BEGIN
  SET NEW.foo_id = (
    SELECT IFNULL(MAX(foo_id), 0) + 1
    FROM foo_table
    WHERE foo_group = NEW.foo_group
  );
END $$

DELIMITER ;
Beim Einfügen eines Datensatzes über das Datenbank-Tool Adminer gab es allerdings noch ein kleines Problem. Wenn ich das Eingabefeld foo_id überspringe, sendet Adminer einen leeren String, was zu einer Fehlermeldung führt:
Incorrect integer value: '' for column `test1`.`foo_table`.`foo_id` at row 1
Hier hilft ein Default-Wert 0 für foo_id:
ALTER TABLE foo_table
CHANGE foo_id foo_id int(10) unsigned NOT NULL DEFAULT 0 AFTER foo_group;
Der Trigger überschreibt die 0 dann mit dem korrekten Auto-Increment-Wert.
Update:
Jens T. hat mich in den Kommentaren darauf aufmerksam gemacht, dass ein nachträglicher Wechsel von foo_group so nicht möglich ist. Hierzu muss zusätzlich ein entsprechender Trigger für die Updates erstellt werden:
DELIMITER $$

CREATE TRIGGER foo_bu BEFORE UPDATE ON foo_table
FOR EACH ROW BEGIN
  SET NEW.foo_id = (
    SELECT IFNULL(MAX(foo_id), 0) + 1
    FROM foo_table
    WHERE foo_group = NEW.foo_group
  );
END $$

DELIMITER ;
]]>Skip links are not focusable
Lighhouse verwies hierbei auf folgenden Skip-Link:
<a class="skip-link screen-reader-text focusable" href="#main">↓ Skip to Main Content</a>
Ich rätselte eine Weile darüber, inwieweit dieser Skip-Link selbst nicht fokussierbar war. Das Problem lag aber woanders, nämlich am nicht vorhandenen Linkziel: ein HTML-Element mit der ID „main“ gab es schlichtweg nicht. Möglicherweise wurde das betreffende HTML-Element irgendwann bei einer Anpassung des Themes entfernt oder umbenannt. Eine Überprüfung auf Barrierefreiheit wurde dabei üblicherweise nicht unternommen. Mit dem Barrierefreiheitsstärkungsgesetz, welches in drei Wochen in Kraft tritt, wird auch die Zugänglichkeit von Webseiten inzwischen ernster genommen.
Nachdem das Linkziel auf den vorhandenen Inhalte-Container umgebogen wurde, hat auch Lighthouse diesen Punkt nicht mehr bemängelt.
]]>Nur Thunderbird und Firefox verhielten sich da merkwürdig: vor dem kopierten Textabschnitt wurde jeweils ein „> “ eingefügt. Bei anderen Programmen gab es dieses Problem jedoch nicht. Ich behalf mich damit, die überflüssigen Zeichen nach dem Pasten zu entfernen, auf Dauer nervte das Verhalten aber. Nach einiger Recherche kam ich dann auf die simple Ursache: xdotool übersetzt den Shortcurt nicht nur in einen Mausklick, sondern reicht auch die übersetzten Tastatureingaben weiter. Bei den jeweiligen Programmen kam also an: mittlerer Mausklick + Ctrl + Insert. Die beiden Mozilla-Anwendungen haben nun die Eigenart, dass bei einem Einfügen mit mittlerer Maustaste und gedrückter Ctrl- bzw. Strg-Taste ein „> “ mit eingefügt wird, um Zitate zu kennzeichnen.
Gelöst habe ich das Problem schließlich dadurch, dass ich in den Tastatur-Einstellungen von Xfce dem Befehl „xdotool click 2“ den einfachen Shortcut Insert (ohne Ctrl) zugewiesen habe. Da ich die Insert-Taste ansonsten nie in Gebrauch habe, war das für mich praktikabel.
]]>Mit einem „Null MX Record“ im Zonefile kann klar zum Ausdruck gebracht werden, dass es keinen empfangenden Mailserver gibt, so dass solche überflüssigen Versuche an anderer Stelle künftig ausbleiben:
@ IN MX 0 .
Wenn unter der betreffenden Domain keine Mails versendet werden, dann kann mit Einträgen im Zonefile auch das Absender-Spoofing durch Dritte effektiver unterbunden werden, sofern die folgenden Records von empfangenden Mailservern berücksichtigt werden. Mit einem SPF-Reford werden global alle Hosts als Sender ausgeschlossen:
@ IN TXT "v=spf1 -all"
Zusätzlich kann eine DMARC-Policy „reject“ klarstellen, dass Mails entsprechend dem SPF-Record und mangels DKIM-Record unbedingt zurückzuweisen sind.
_dmarc IN TXT "v=DMARC1; p=reject"]]>