sudo apt -y -U upgrade
sudo apt install -y apache2 php mysql-server
sudo apt install -y nodejs
sudo apt install -y composer
sudo apt install -y php-xml php-gd php-bcmath
sudo apt install -y mysql-client php-pdo-mysql
sudo apt install -y postgresql php-pgsql
sudo apt install -y sqlite3 php-sqlite3
Apache、PHP、MySQLのインストールは特に説明はありません。それぞれ、Ver.2.4.66、Ver.8.5.4、Ver.8.4.8がインストールされます。Node.jsのインストールは必要ではなく念のためです。composerは2.9.5がインストールされます。その後、PHPのモジュールでインストールが必要なものを入れますが、Ubuntsu 24ではbcmathは不要だったのですが、今回は指定する必要があるようです。データベースはどれか1つでも構いませんが、PDOあるいはデータベース向けライブラリを入れることになります。
Apache2の稼働ユーザーは、www-dataで昔から変わりません。そのユーザーのホームフォルダーは、/var/wwwなのですが、www-dataがホームへの書き込み権限がないので、いかようにコマンドを入れて、ホームフォルダへの書き込みを可能にしてください。
sudo chown -R www-data:adm /var/www
sudo chmod -R g+rw /var/www
sudo systemctl restart apache2
INTER-Mediatorのレポジトリには以前はサンプルファイルもあったのですが、サンプルファイルは別のレポジトリとしました。URLは以下の2行目をご覧ください。サンプル自体がINTER-Mediatorアプリケーションになっているので、それをインストールすれば、INTER-Mediator自体もインストールされます。
cd /var/www/html
git clone https://github.com/INTER-Mediator/INTER-Mediator_Samples.git
cd INTER-Mediator_Samples/
composer update
なお、composer updateの中で、MySQLのサンプルスキーマを読み込みます。データベースのスキーマを適用するかを聞かれたら、YESと答えれば基本的にはOKです。それで、「http://サーバーのIP/INTER-Mediator_Samples/」で、サンプルデータベースのメニューページに入ります。
なお、単にINTER-Mediatorを試用したいというのであれば、「トライアル環境」と呼ぶアプリケーションがあり、レポジトリは、「https://github.com/INTER-Mediator/IMApp_Trial.git」です。こちらは、Dockerを利用してINTER-Mediatorのサンプルやあるいはページを作ってみるためのオンラインエディタなどが含まれているので、Dockerさえ動けば環境依存による対処は不要になると思います。こちらの利用もご検討ください。
]]>2つのテーブル、mainとsubがあって、それぞれ、こんなデータです。main_valueとsub_valueフィールドは数値型フィールドです。s_main_valueとs_sub_valueは、それぞれmain_value、sub_valueフィールドの合計を求める集計型フィールドです。


これら2つのテーブルの間ではリレーションシップが設定されているとします。ここでは、簡単化のためテーブル名=TO名にしてあります。

改めてsubレイアウトのsubテーブルの内容を見ていただきたいのですが、外部キーフィールドと、mainの主キーフィールドが多対1の関係でリレーションシップを設定しています。subの1行目のレコードはmainの2行目、subの2,3行目のレコードは、mainの3行目のレコードと関連があるということです。意図的に1行、2行のリレーションシップを作ってあります。
集計の方針として、レイアウトにはmainを割り当てて、sub_valueの合計を取りたいという場合を考えてみます。TOのmainが割り当てられているレイアウトに、sub::sub_value、sub::s_sub_valueを配置してみました。

集計とは関係ない話になるものの、sub_valueフィールドの振る舞いを見てみますが、mainの2行目とは1レコードが対応するので、そのレコードの数値1000が見えているのはいいとして、mainの3行目とは2レコードが対応しています。ここで、リレーションシップの先のsubの関連しているレコードの「最初のレコード」としてここでは2000が見えています。今回はリレーションシップにソートの設定をしていませんが、意図的にいずれかのレコードを見えるようにしたい場合はソートの設定をきちんと行うことが必要になるでしょう。
さて、sub側の集計フィールドであるsub::s_sub_valueは、1000と5000です。それぞれ、関連レコードのsub_valueフィールドの合計になっているという点では、うまく動いています。この動作により、ポータルに配置した集計フィールドは、おそらく期待通りの動き、つまり、「ポータルで見えているレコードの集計」を実行するようになるということではないかと思います。
しかしながら、ここで欲しいのは、main側でのレコードの集合に対して、対応するsubのsub_valueの合計である6000だとします。じゃあ、合計を取ればいいじゃんと思いますが、残念ながらExcelではないので、ここでの合計はFileMaker的な戦略が必要になり単純ではありません。SUM関数で式を定義というのは必ずしもできるとは限りません。
1つの方法は、mainテーブルに、s_sub_valueの値を参照する計算型フィールドを定義します。ここでは、ref_s_sub_valueフィールドとしますが、計算式は、単純に「=sub::s_sub_value」とします。もちろん、mainを基準にした計算式にします。そして、さらにmainテーブルに、集計型のフィールドs_ref_s_sub_valueを定義します。このフィールドは、ref_s_sub_valueフィールドの合計を求める集計型フィールドです。こうすれば、s_ref_s_sub_valueは、sub::sub_valueの総合計を求めるフィールドとなりました。

つまり、計算および集計型の2つのフィールドを定義しないといけません。いきなりmainにsub::s_sub_valueを集計するフィールドを作ればいいかと思うかもしれませんが、ここでFileMakerの制約に引っ掛かります。集計対象のフィールドは、同一のテーブルでないといけません。別のテーブルは参照できないのです。なので、一旦計算フィールドで参照しているテーブルの値を取り出して、それを集計するという2段階が必要になります。

なお、リレーションシップ先のレコードとの関連が1対1なら、main側で集計結果を参照する式として「=sub::s_sub_value」でなくて、「=sub::sub_value」でも構わないでしょう。そうすれば、subテーブルでのテーブル定義が1つ減ります。
ちなみにmainのTOとデカルト積でリレーションシップを取ったテーブルを用意して、そこから、=SUM(sub_value)、あるいは=SUM(s_sub_value)を取るという方法もあるかと思いますが、結果としては前者は6000、後者は18000になります。後者は6000の3レコード分ですから間違いというか、集計してさらに集計しているので違う数値になるのです。とりあえず、前者の方法でここではうまくいくようですが、2つ先のリレーションであることを意識する必要があります。
リレーションシップはもちろん便利なのですが、このように集計が絡むと、制約が見えている場合もあります。結果的にフィールドをたくさん定義してわけが分からないようにも成りかねないので、フィールドの命名規則は最低限でも統一したものを作っておきたいところです。
]]>

ところで、実用的にはこれは、「マスターがややこしい伝票」と考えればいいです。Aテーブルがまず伝票1枚に対するテーブルで、Bテーブルは伝票の明細です。そして、Cテーブルは商品マスターです。伝票の明細であるBテーブルへの商品記録は、商品マスターの主キー値をc_idフィールドに記録して、その他の値は別途取ってくるという状況のようです。ちなみに、Dは何かといえば、例えば「単価マスター」と考えてみましょう。商品マスターと単価マスターが別々というところで、単純には1対1でうまく管理すれば問題ないと最初は思います。
しかし、作り込んで行くに従って、謎なことが発生します。これらのデータを、AテーブルのTOをレイアウトのTOに指定したレイアウトで見てみると、こんな感じです。ややこしいですが、頑張って数字を追ってください。a_id=101は素直なデータという感じですが、102と103はC、Dテーブルがなんかおかしいかなという感じで、すぐに詳しく説明します。
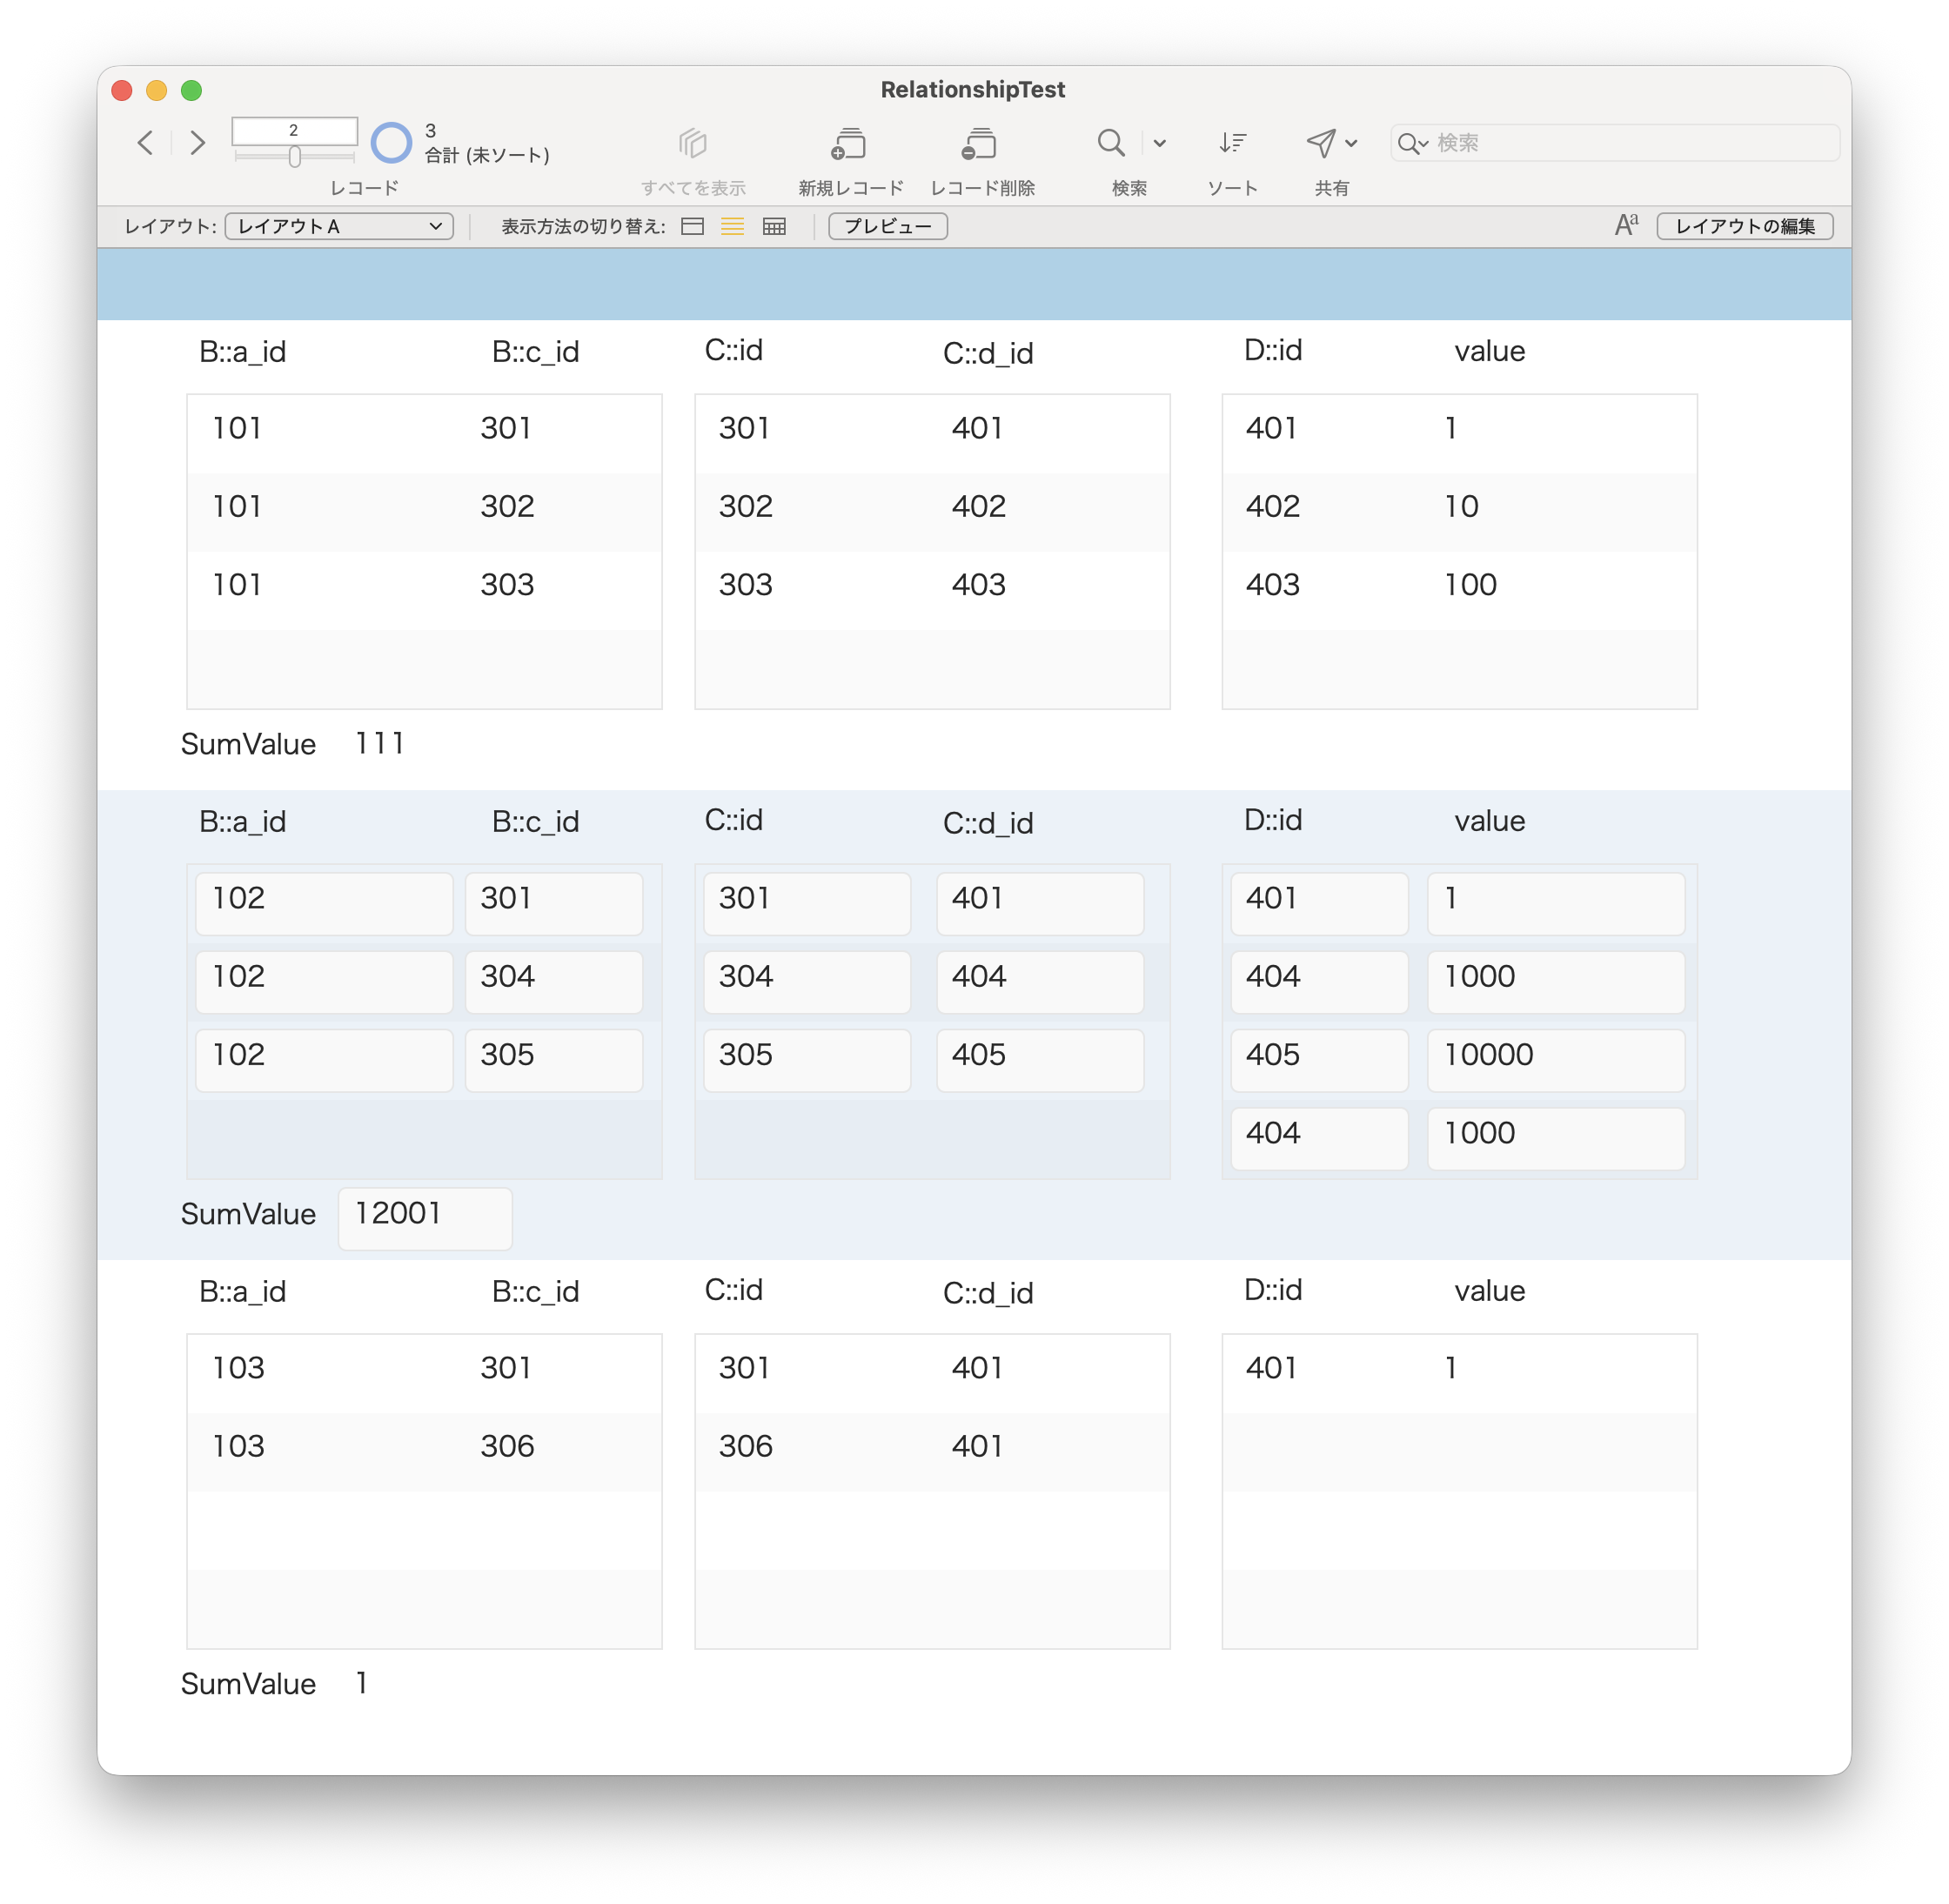
ここで、SumValueというフィールドが見えています。このフィールドは、Aテーブルに計算フィールドとして作ったものです。「SUM( D::value )」と定義しています。先ほどの伝票で言えば、伝票上の商品の単価合計みたいなものでしょうか? 実用上、そういう計算をすることはまずないですが、わかりやすく説明するためにあえてそういう言い方をします。
a_id=101つまり、最初のレコードは、SumValueフィールドの値は111です。右端のDテーブルのポータル展開した結果を見ても、思った通りに計算できているようです。
ところがa_id=102はどうでしょうか?もちろん、Dテーブルのポータルに見えているvalueフィールドの値が全部加算されて、12001となっています。a_id=103つまり3つ目のテーブルも同様です。これは、これで正しいのですが、もし、Bテーブルのレベルで見えているレコードに対する加算をしたかったとしましょう。つまり、BテーブルのポータルにDテーブルのvalueフィールドを配置した場合に、その合計が欲しかったとしたらどうでしょう? つまり、こういうことです。
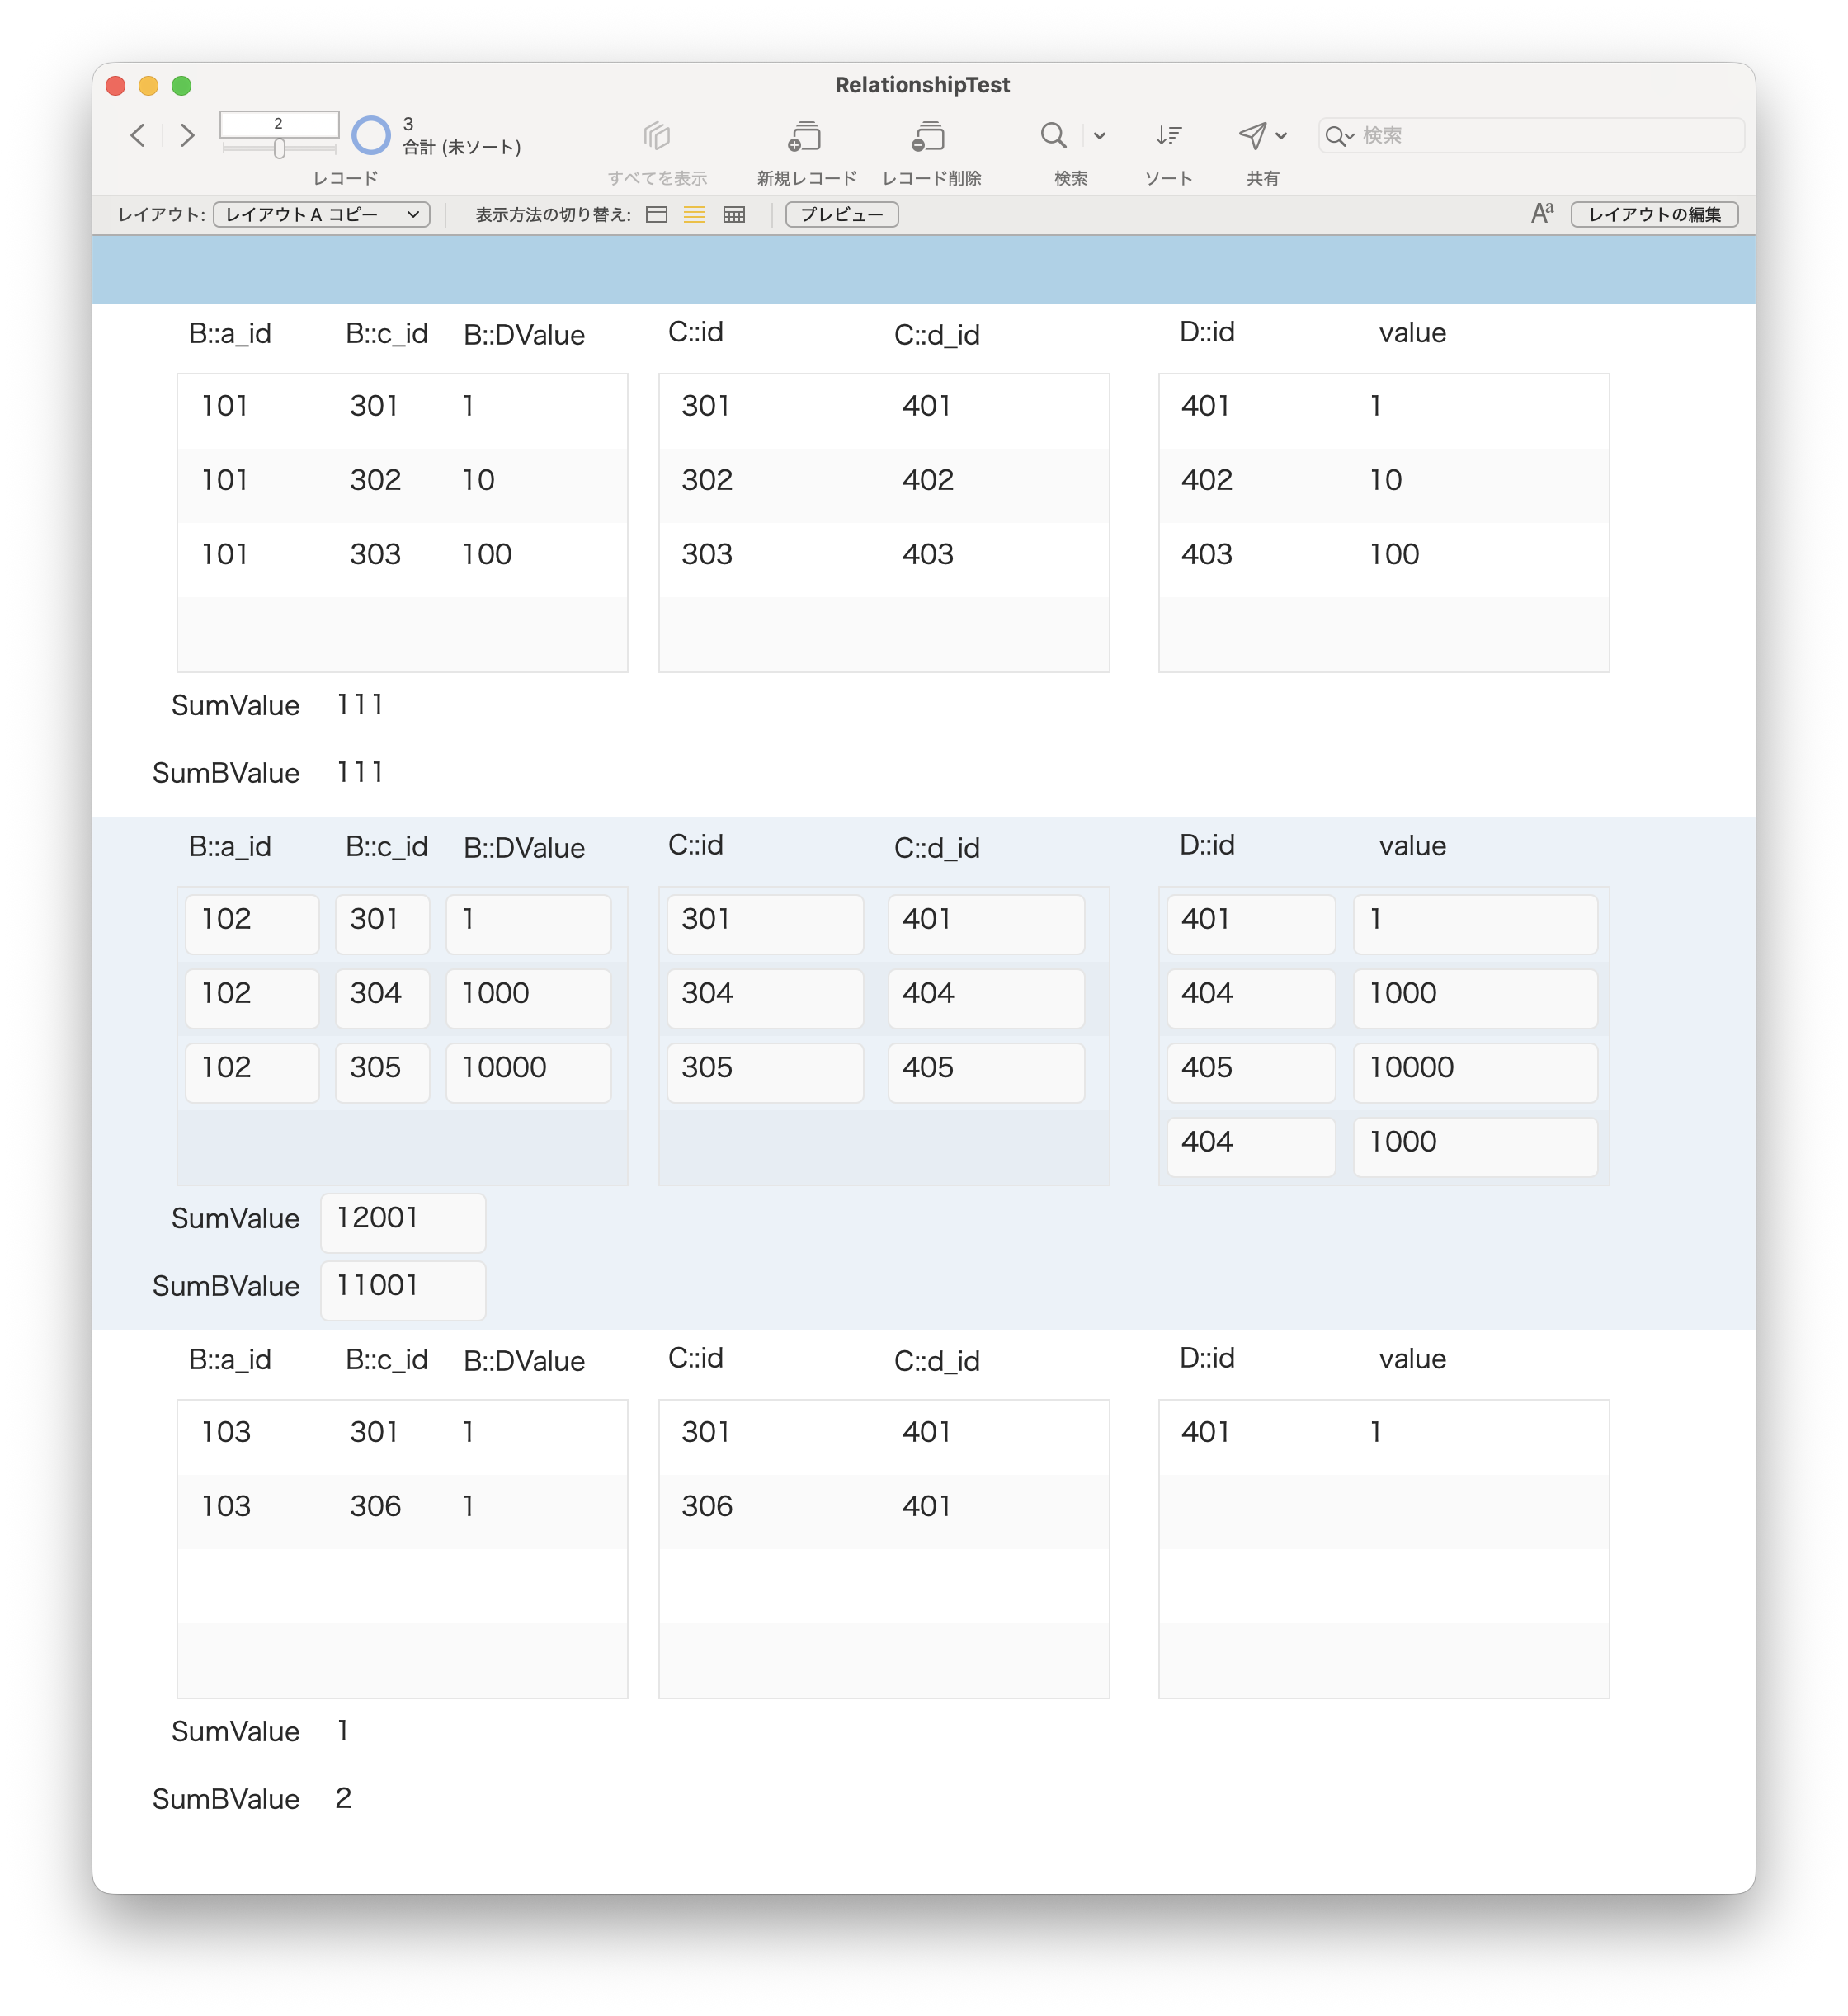
BテーブルにDValueフィールドを定義して、ポータルに配置してあります。DValueの計算式は「=D::value」です。なので、ここにDテーブルのvalueフィールドを配置しても同じ結果になります。そして、AテーブルにはSumBValueフィールドを定義して、計算式として「=SUM( B::DValue )」を指定してあります。
まず、2レコード目のa_id=102を見てみると、SumValueはBテーブルのポータルにあるvalueの合計ではなく、上から2桁目が多いわけです。SumBValueは正しく計算されているように見えます。しつこいようですが、Bテーブルのポータルが「正しい」という基準が適用されています。a_id=103についてもSumValueは少ない結果になっているように見えますが、SumBValueはBテーブルのポータルに見えているvalueフィールドの値が合計されているように見えます。
もう解答を言ってありますが、いきなりDテーブルのフィールドをSumしても、思った通りの値にならないかもしれません。その場合は、一度Bテーブルで値を参照してからその参照値を合計するという二段階にすればなんとかなります。
しかし、このサンプルは、やってはいけないことに近いことをやっています。Dテーブルのid=404のレコードは2つあります。つまり、idフィールドは主キーにならない状態になっているのです。やってはいけないけど、FileMakerはやれてしまいます。この結果、Aテーブルの2レコード目のSumValueとSumBValueの計算結果が異なるのです。Cテーブルのd_idをよくみると、401のレコードが2つあります。CとDが多対1なら、リレーショナルデータベース的にはOKと言えるかもしれませんが、もし、これが、CとDのレコードが1対1を目指しているのなら間違ったデータとなるかもしれません。
ここでの技術的な説明の根本は、SumValueとSumBValueが違うということです。時と場合によって、どちらが欲しいかは変わってくると思います。何が正しいということは一概には言えないものの、FileMakerのリレーションシップは、こうした「違い」が時として現れます。レコード間の関連の取り方で、集計結果が違うということを理解し、正しい設計を行い、それを逸脱しないようにしなければなりません。特にFileMakerでは主キーの扱いが曖昧です。もちろん、主キーなので重複した値を許可しないようにすれば終わりで、Aテーブルの2レコード目、3レコード目のような状態にはできませんが、いろいろな事情でそうした設定をやっていない場合には、このようなレコードになってしまう可能性があります。また、インポートに至っては、フィールドに「ユニークな値」を設定していても、重複する値を入力可能な場合もあります。緩いプラットフォームは楽な一方で、謎の結果に悩まされるということもありうるのですね。
]]>システム開発作業は、小さなステップの積み上げなので、そのステップを正確に数えれば費用見積もりは可能ではないかと思いがちですが、全ての作業を機械的に正確な時間で進められるわけではなく、失敗やあるいは手順上の問題で出戻って作業をやり直す部分などもあります。また、単に手を動かせば良いだけではなく、テストもやらないといけません。そうした一連の作業を結果的に「何時間かけたか」ということが開発コストに直結するわけです。それを見積もるためには、小さな作業の積み重ねといった正確さを追求する方法では限界があります。しかし、勘と経験だけで「150万だ!」などと決めるのも危ういです。つまり、ある程度のルールに基づいて導出する見積もり金額というものがあり、そのときに持ち出すルールがそれなりにシンプルというところです。言い換えれば、開発前に予測可能なことで、それほど大量に項目出しをしなくても済むような手法が求められています。
以前から筆者は経験上、いろんな方法で見積をしてきましたが、それなりに良い結果を得ている手法に集約できてきたので、その方法を紹介したいと思います。概ね、大きく外さない感じにできるところまで来たというところです。
開発前に4つの要素に注目する
まず、開発の作業を4つの要素でそれぞれ予測を行います。最初の1つは「設計」であり、これはあえてFileMakerを触る前の作業を全て含めることにします。顧客の話を聞くなどの要求獲得や要求分析、そして実際のどんなテーブルを用意して、どんなフィールドを用意するのかということを決定する「設計作業」が1つの要素です。見積もりを行う段階ですでに、設計作業のプロセスには入っているのが一般的でしょう。そして、情報収集後、ドメイン分析あるいはER図に相当するものが確定するまでの時間を考えます。「そんなことは作りながら考える」という方もおられるかと思います。それは作成開始後にどれくらいの時間を使うかを考えて、時間で検討します。一般にはシンプルなものでも最低5時間くらいかかると思います。複雑なものになると20時間、顧客とのやり取りのためにドキュメントをしっかり作らないといけないとなると30時間といった値になると思われます。ただ、この「設計作業」はFileMakerとは離れた部分ですので、ここでの時間数については大まかに紹介する程度にしたいと思います。
そして、残り3つの作業ですが「テーブル数」「追加レイアウト」「重い作業」という3つの観点で数値化します。最初のものは良いとして、残り2つはなんじゃコラと思われるかもしれませんが、それはすぐに説明します。
設計作業を行えば、FileMakerに向かってテーブルを用意し、フィールドを定義紙というお馴染みの作業になります。しかし、一般にはテーブル1つについて、それを一覧表示したり、全フィールドあるいは一部のフィールドを表示したり、変更可能にしたりという基本的なレイアウトのセットも作ることになります。このテーブルの作成やその後の管理、それを取り巻く基本的なレイアウトを管理する作業を考えます。この作業を1つのテーブルに対して行う作業量を、ここでは「単位」と呼ぶことにします。もちろん、簡単なテーブルだと10分で終わるよと言うかもしれませんし、大量に計算フィールドがあるとなると時間はかなりかかりそうです。しかしながら、見積もりを平準化してできるように、「1テーブルの作成管理タスク」を「1単位」としてこの後の作業を見積もります。1つの言い方としては、小さな作業の数々を「1テーブルの作成管理タスク」としてまとめているということです。
その上で、先にこの1単位の時間数を決めないといけません。自分自身は「1単位=3時間」くらいが適切かと考えています。いや、4時間などもっと長くてもいいように思います。テーブル一つで何時間もかかるかと言うと、実はかかると言えます。まず、基本的なテストつまり実装結果の検証まで含めて開発作業は進められるので、その点を加味してください。開発途中でフィールドを増やす、あるいは値一覧との連携が増えるなど、小さな作業ながらも途中で色々と作業は増えていくと考えられます。また、簡単なナビゲーションを作るような仕事もここに含めると考えていただければ、大体そんなものかと考えていただけるかと思います。また、スタッフの経験や能力によっても変動があっても良いでしょう。ともかく、1テーブルの作成管理タスクを1単位として考えると言うのが見積もり作業の基本であると考えます。そして、テーブル数が積算見積もりの1つの重要な項になります。
時間のかかるレイアウトを特定する
「追加レイアウト」については、レイアウトをどれくらい作るのかを識別します。ここで、ごく基本的な参照や検索、入力、編集を行うレイアウトのようなものは、「テーブル数」の側に作業は含むと考え、それら基本的なレイアウト以外のレイアウトを特定します。伝票入力のレイアウトがあって、特に変わった作りをしないのであれば、その入力レイアウトは1テーブルの作成管理タスク内のものとします。しかしながら、それに加えて印刷用のレイアウトを別に作ったり、あるいは複数の印刷用レイアウトを作るなど、基本的なレイアウト以外にどれくらいのレイアウトを作るのかを計算します。したがって、単なる入力レイアウトと言えども複雑な処理が絡むのであれば、それもカウントします。集計のレイアウトを作る場合も「追加レイアウト」になるでしょう。ともかく、レイアウトについては設計ができていれば概ね列挙することは可能ですし、その中で時間のかかりそうなものとそうでないものを見極めるのはそんなに難しいことはありません。
この時、レイアウト1つ1つに仮の名前をつけて識別するようにして、各レイアウトに対する見積もりを先ほどの「1テーブルの作成管理タスク」の1単位の「単位」で数値化します。そこそこ楽ちんなものでも、やはりテストを考えればそれなりに時間はかかりますし、綺麗なレイアウトを作るとなるとそれなりに大変です。集計のレイアウトを完成させるには元データも必要だったりします。そう言うことを考えて、例えば「顧客別月間売り上げ一覧レイアウトは2単位」などと決めて行き積算します。伝票に対する印刷用レイアウトは1単位というとちょっと多すぎる気もするものの、最低1単位でカウントするのが良いと思います。ただ、あまりに小さなものやコピペで量産できるものがあれば、「レイアウト群」で何単位を考えるとか、最小0.5あるいは0.25単位で考えても良いかもしれません。しかし、最初に指摘したように、細かい分類分析をして加算するのは限界があるので、あまり刻まない方が時間もかからなく、見積もりには適しているのではないかと思います。
時間のかかる実装作業を特定する
「重い作業」は文字通り、そのような作業です。これも、追加レイアウトと同様に、発見し、それぞれ識別可能な名前を付けて単位数を割り当てます。例えば、伝票入力するとしても、数万件の商品マスターから選択して入力するとしたら、そうした「入力のサポート」を実装することを求められます。例えばそれを1単位とするわけですが、その場合「入力サポートレイアウト」として追加レイアウトに1単位、「重い作業」に加えて1単位といった具合でも構いませんし、レイアウトは省略して「重い作業」に2単位でも構いません。あるいは、リレーションシップが複雑な場合や、ルックアップの処理が複雑な場合もあります。そうしたリレーションシップのTO結合を設定するのも1単位の重い処理としてカウントするのも良いでしょう。ともかく、時間がかかりそうな作業を、テストまで行うのにどれくらいの手間がかかるのかを「単位」を手がかりにカウントします。
外部との連携はまさに重い処理の典型と言えるでしょう。単にCSVファイルから読むだけならいいのですが、例えば、複数のファイルを読んで一部は読み込み後に処理を行うだとか、重複を消したいなど色々な作業が入ります。APIをコールしてそこからデータを取り出しテーブルに展開といった作業は場合によっては2単位、3単位と増えるでしょう。タイマー動作のサーバサイドスクリプト、JavaScriptプログラミングが関わるWebビューアを使ったビジュアルなど、重い作業は色々あります。最終的な統合テストについても、例えばユーザ立ち合いで行うなどの作業が発生するとしたら、統合テストそのものも重い作業です。一般には、設計がしっかりしていれば、統合テストを含めてのテーブルと追加レイアウト等の「単位」なのですが、状況によってはそれも分離しましょう。
この重い作業は、おそらく1以下はあまりないと思います。むしろ、上限はなく、5や10くらいまで上がるような場合もあるかもしれません。一般には他のシステムとの連携部分で、1〜3単位になるくらいではないかと思われます。
単位を積算する
以上のように「設計作業」「テーブル数」「追加レイアウト」「重い作業」の4つを考えて最終的な見積もり作業量を算出します。追加レイアウトと重い作業は、数式化するとシグマとかややこしそうですが、リストアップして1つ1つに単位数を割り当てるということです。もちろん、これはuが均一としていますが、数人にタスクを割り振るときには、それぞれの担当者ごとに合計単位数を求めて、各自のu値をかけた後に加算する必要があります。
D = 設計にかかる時間数
u = 1単位の時間数
T = テーブル数
Li = 追加レイアウトの単位数(i = 1..n)
Ti = 重い作業の単位数(i = 1..n)

見積もり時間数 = D + (T + ΣLi + ΣTi) × u
こうして算出することで、実際に「作ってみないとわからない」と思いがちな開発作業時間が算出されます。
そして、重要なことは、振り返りを行うことです。業務が終わった後に、ピックアップしきれなかった追加レイアウトや重い作業にどんなものがあったのかということを改めて考えてみるのは、次の業務への改善になると考えます。
なお、この手法、ローコードツールへは十分に適用可能と考えます。もちろん、その領域の言葉で色々説明することになるとは思いますが、データベースをシンプルに捉えてその上にUIを構築するという点ではローコードツールは共通点が多いと考えます。皆さんが利用されているツール上での見積もり手法として、改良するのも良いでしょう。
]]>ちなみに、移動した先は野村證券です。野村證券側からも色々なサポートを受けましたが、あまり前例がないということで、お互い手探りで作業をしました。以前だと、こういう移動はそれなりに費用がかかっていたと思いますが、今は費用がかからなくなっており、それもラッキーというか、世間の状況が変わってきたのだと思います。なお、野村證券は、転送の手続きを始める前に、申込書を書かないといけないので、ともかく担当営業の人とのやり取りからスタートです。
顛末を細かく書いてもいいのですが、非常にざっくり書くと、E*TRADEってメールでやり取りしてくれないのです。基本、電話になります。しかも、私は契約しているのが楽天だったりして国際電話のコストが1回電話すると、待たされ、長電話になり、1000円とか2000円になるので、あまり気楽には電話したくないのです。そういえば、以前、楽天の電話に二要素認証のためのSMSが届かないので、電話で色々話をして、結果的に対応してくれたりしたのも懐かしいです。今、サーバ見ているからログインしてみてくれ…みたいな感じでデバッグの手伝いをして、数ヶ月後に直っていました。配当が貯まったので日本の銀行に移動するためにも何度も電話しました。それで株の移動をどうしようかと思ったのですが、郵便は受け付けるらしいので、ともかくリクエストを郵便で送りました。PDFを米国で印刷して投函してくれるサービスを使いました。2度郵便しました。でも何の連絡もない。ここで、やっぱり電話しないといかんのかと思って電話したら、やっと「手順」を教えてくれたのです。何でも、「言わないといけない」お国柄ってところでしょうか。だけど、手紙を送っておくのは意味があって、電話にデータお兄ちゃんが、手紙をざっと読んで、ちょっと待っててーと言って調べてくれて、以下の手順を教えてくれたのです。まあ、文章にしていたので、間違いなく通じた可能性があるので、手紙作戦自体は悪くはなかったと思います。
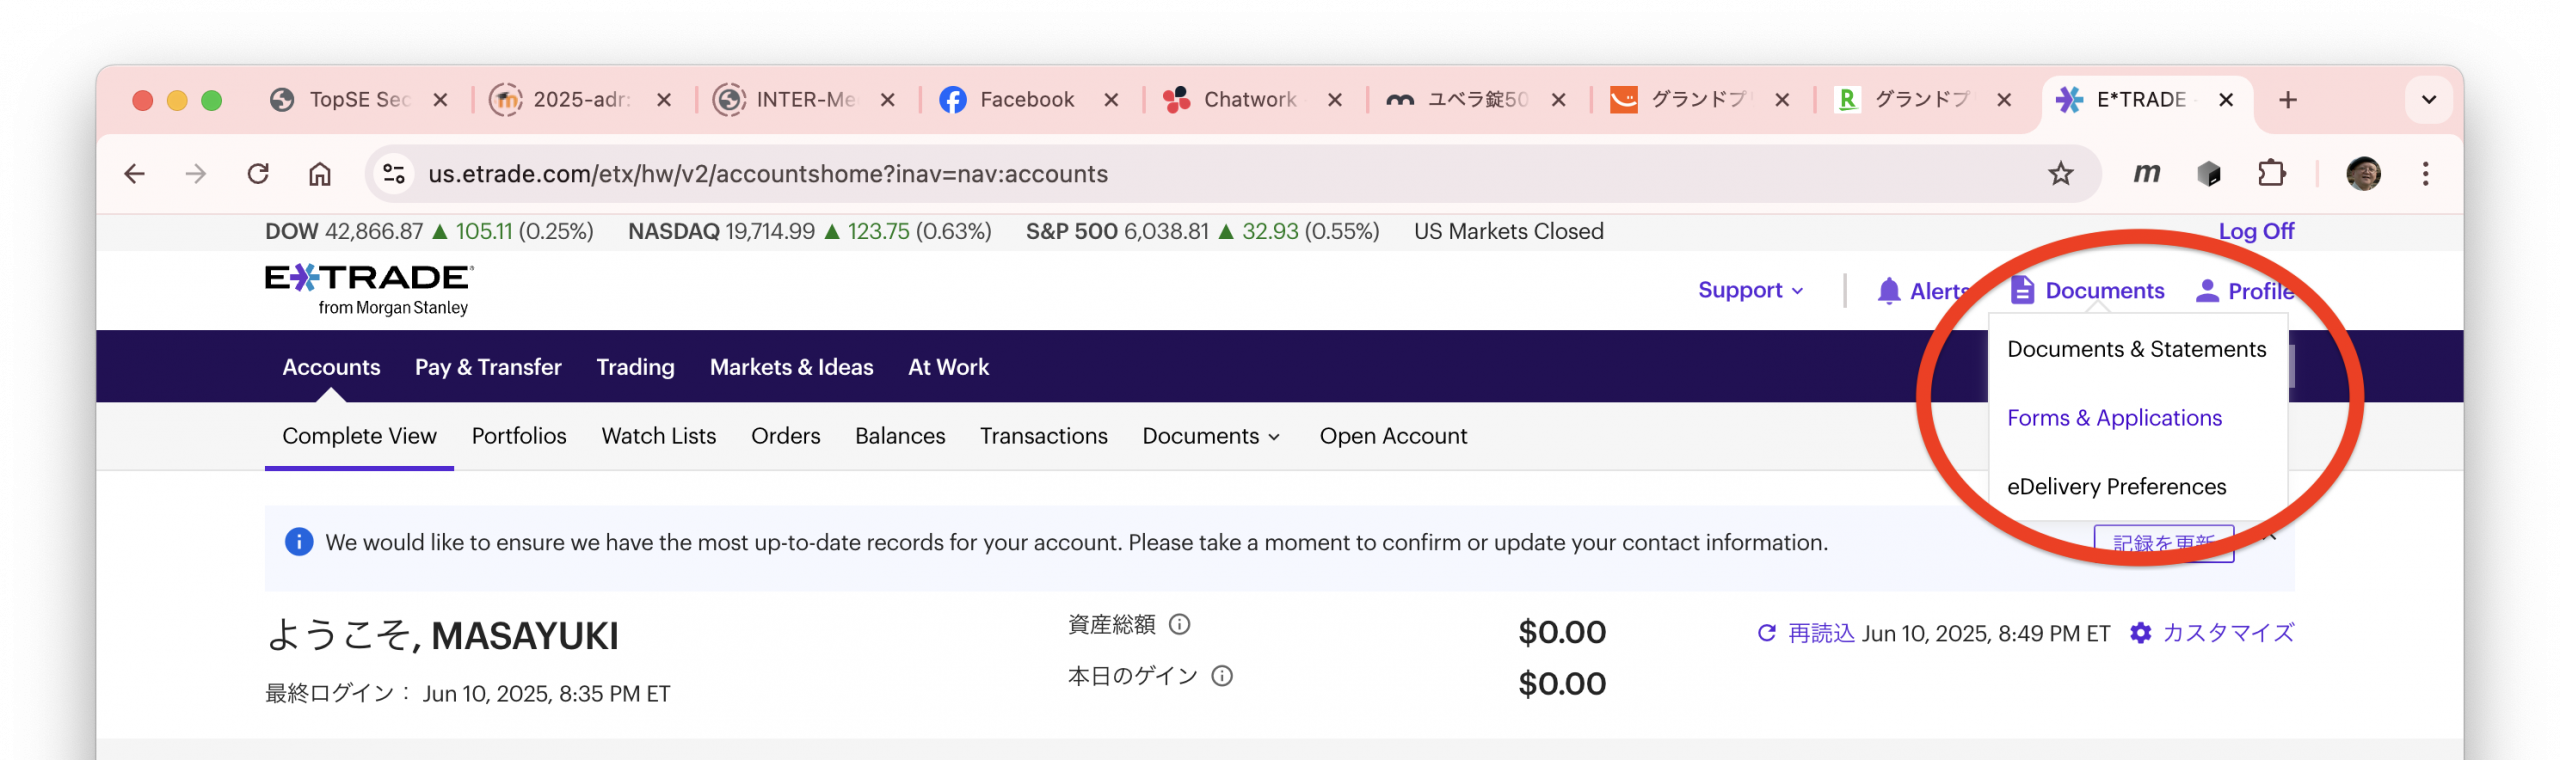
まず、E*TRADEにログインをして、右上のDocumentsから、Forms & Applicationsを選択します。
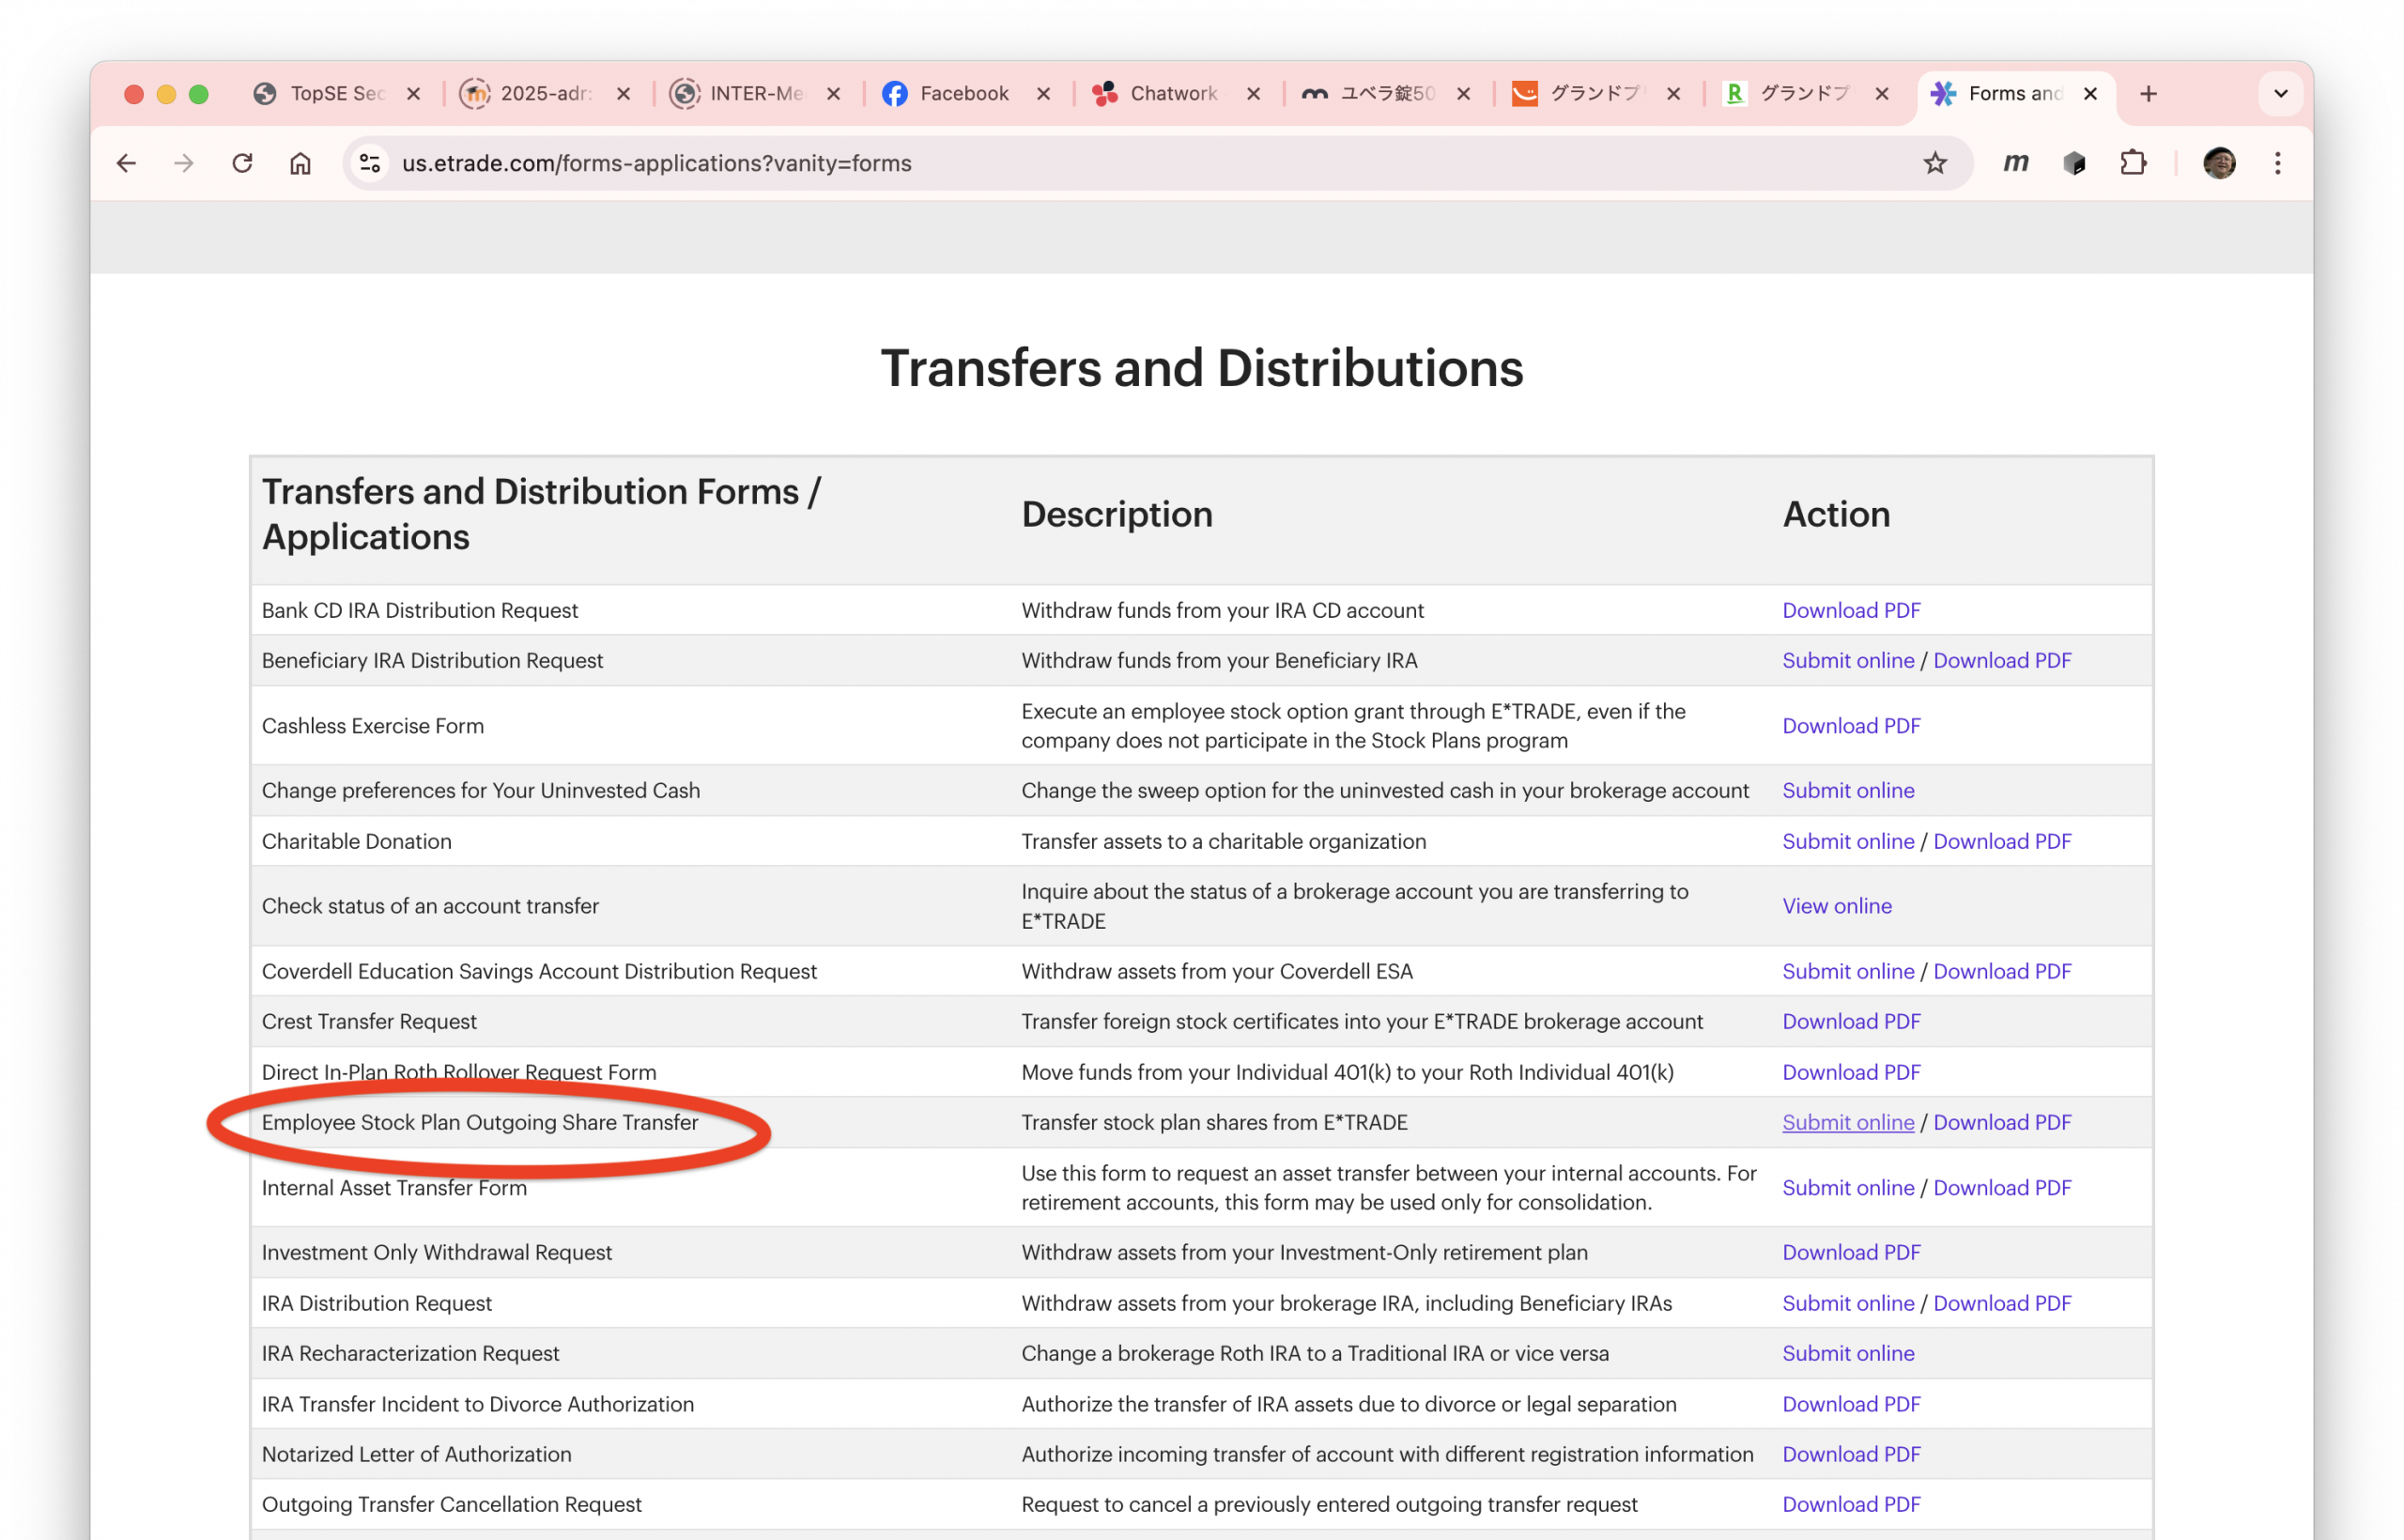
すると、リンクがずらーっと並んだページに行くので、Transfers and Distributionsというタイトルのブロックを探し、その中にあるEmployee Stock Plan Outgoing Share Transferというところの右のリンクをクリックします。実際に申請するには、Submit onlineをクリックすると、PDFが編集可能な状態で開いて、最後に自動的にアップロードされるので、普通はその手順で進めれば良いでしょう。
以下、PDFをダウンロードした結果でポイントを記載しておきます。まず、最初にYour Accout Numberがあり、ここは、別途調べたアカウント番号を記載します。E*TRADEのサイトでは、右上のProfileから調べることができます。その下にAccount Holder Informationがありますが、ここは自分の名前を書くだけです。
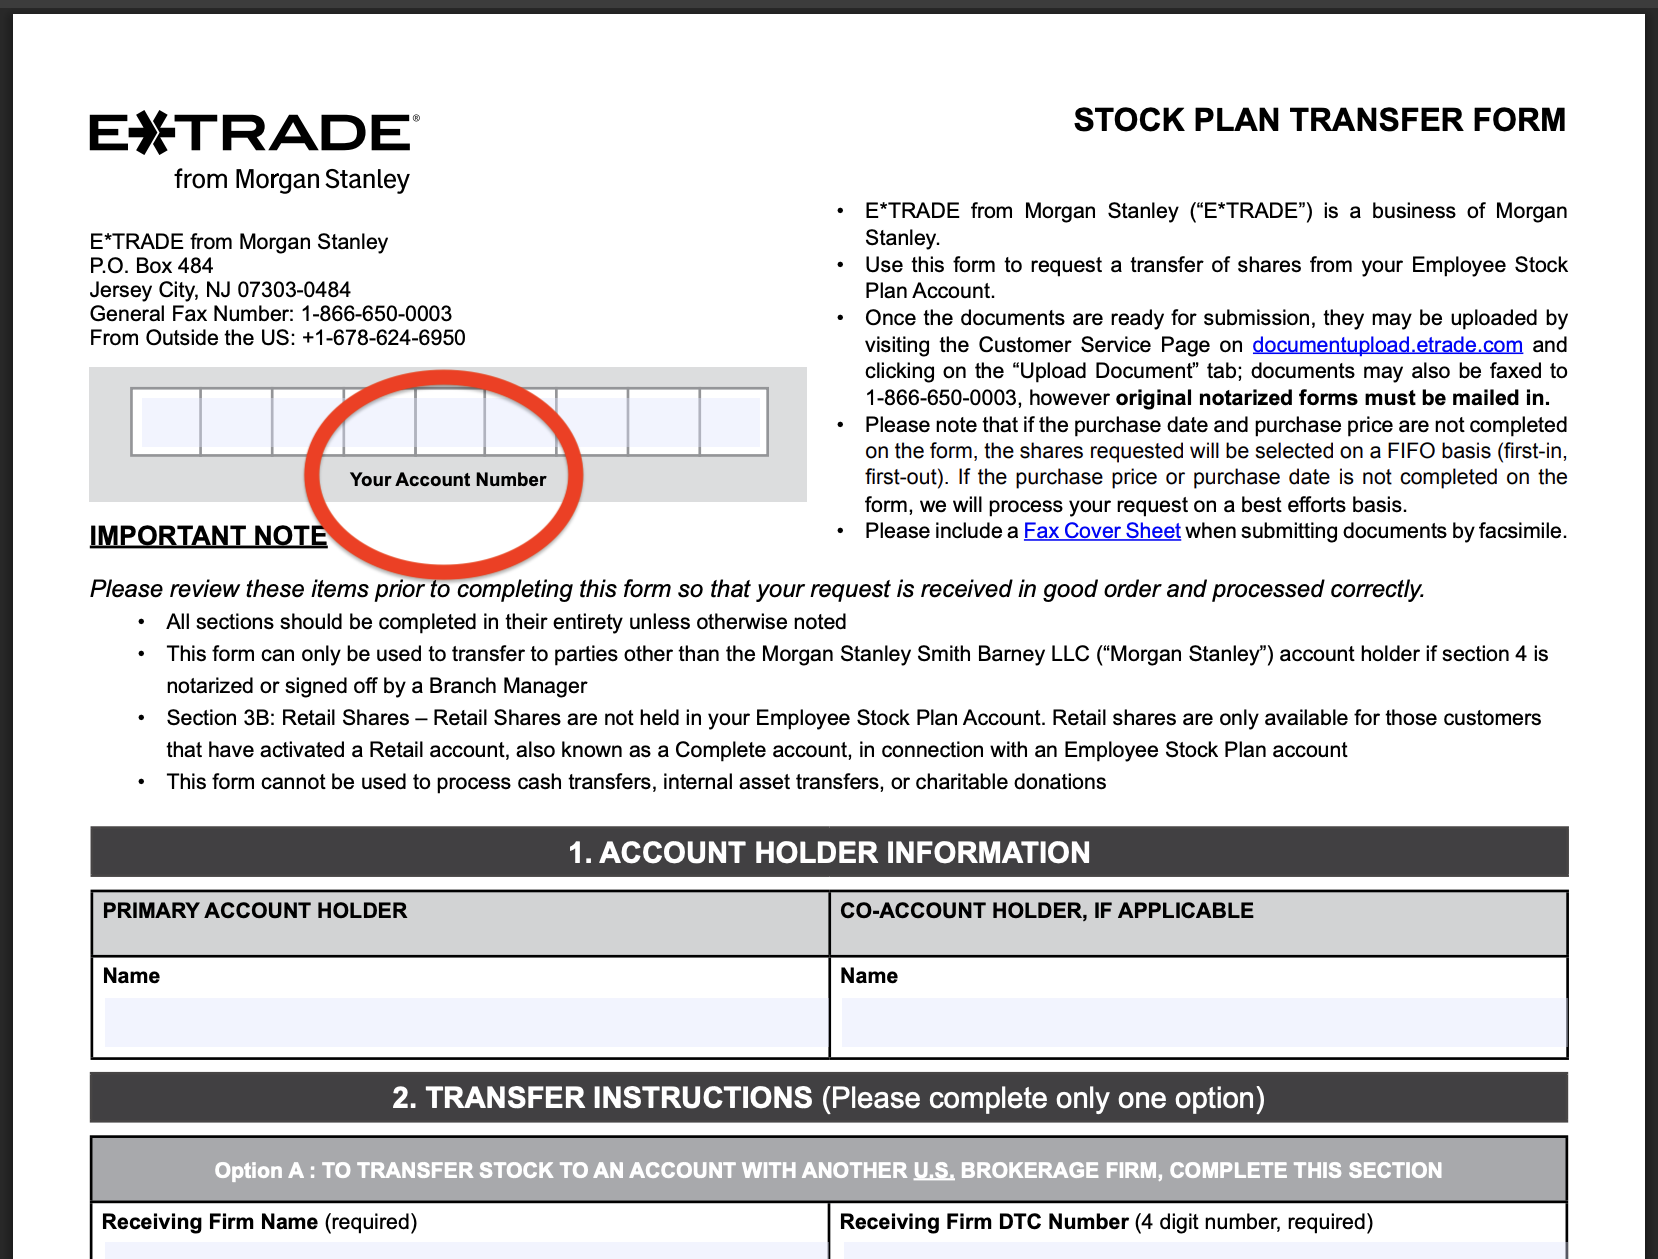
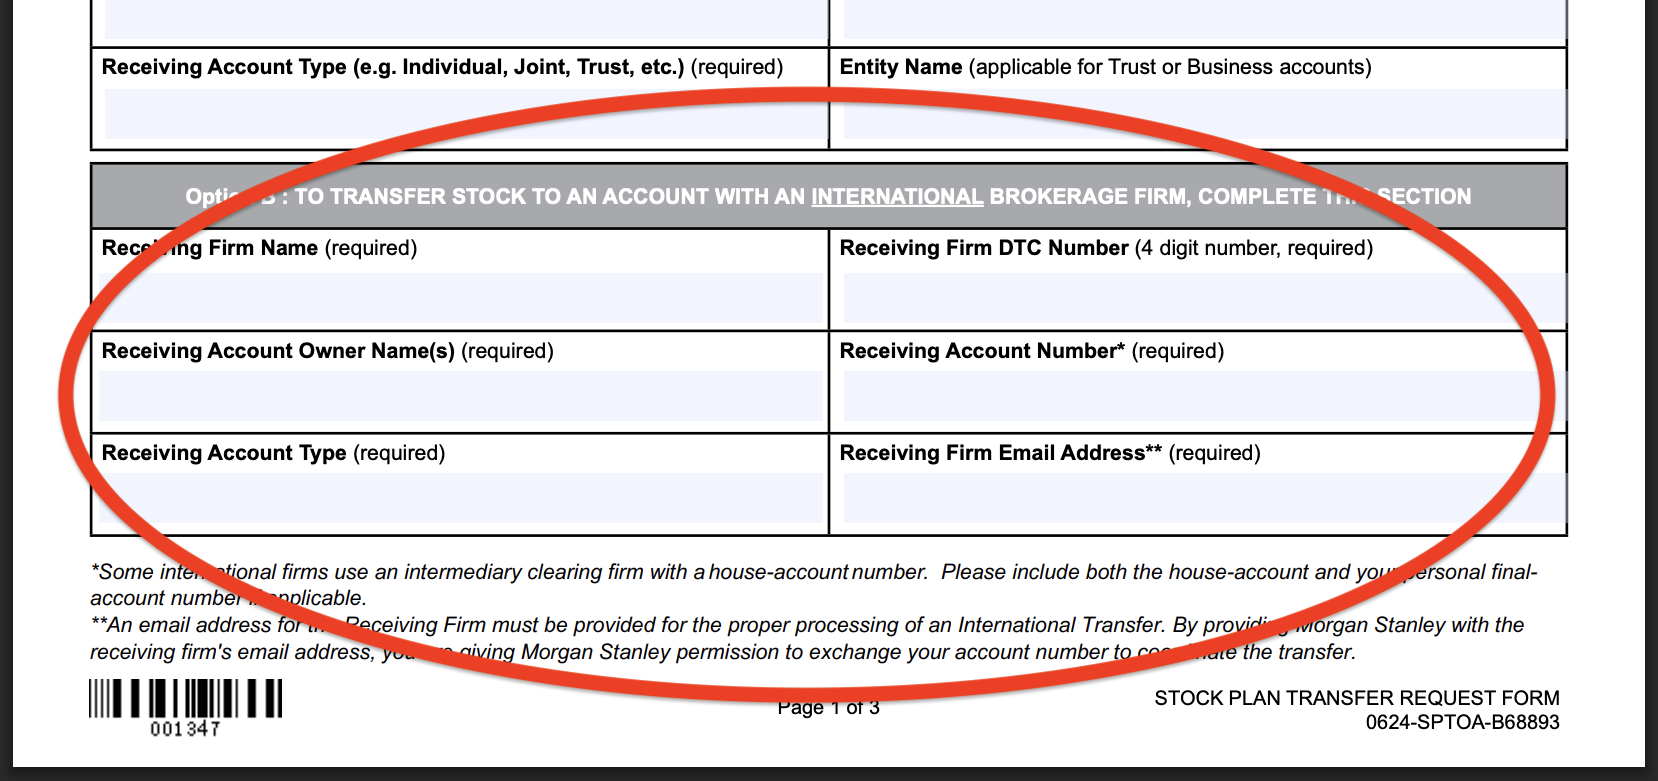
続いて、p1の下にあるOption Bの6つを埋めます。Option Aは米国の別の銀行に移動するときなので、今回は日本の証券会社の移動であってOption Bになります。ちなみに、こちらは移動先の証券会社から、情報を提供してもらわないといけません。Receiving Firm Nameは証券会社名、Receiving Account Owner Nameは自分の名前、Receiving Account Typeは適当にStock Holdingと書いたら通りました。Receiving Firm DTC Number、Receiving Account Number, Receiving Firm Email Addressの3つは受け入れてくれる証券会社から聞かないといけません。当初、これらは伝達してくれてなかったのですが、ある日資料を送っていただき、それをみながら、米国での番号などを書いたら通りました。なお、メールアドレスは、野村證券に申し込む処理に記載されたものがあって、つまり、そのメールアドレスに連絡が来ることを期待して、ここで指定が必要だったようです。ともかく、ここは情報を揃えるということが必要です。
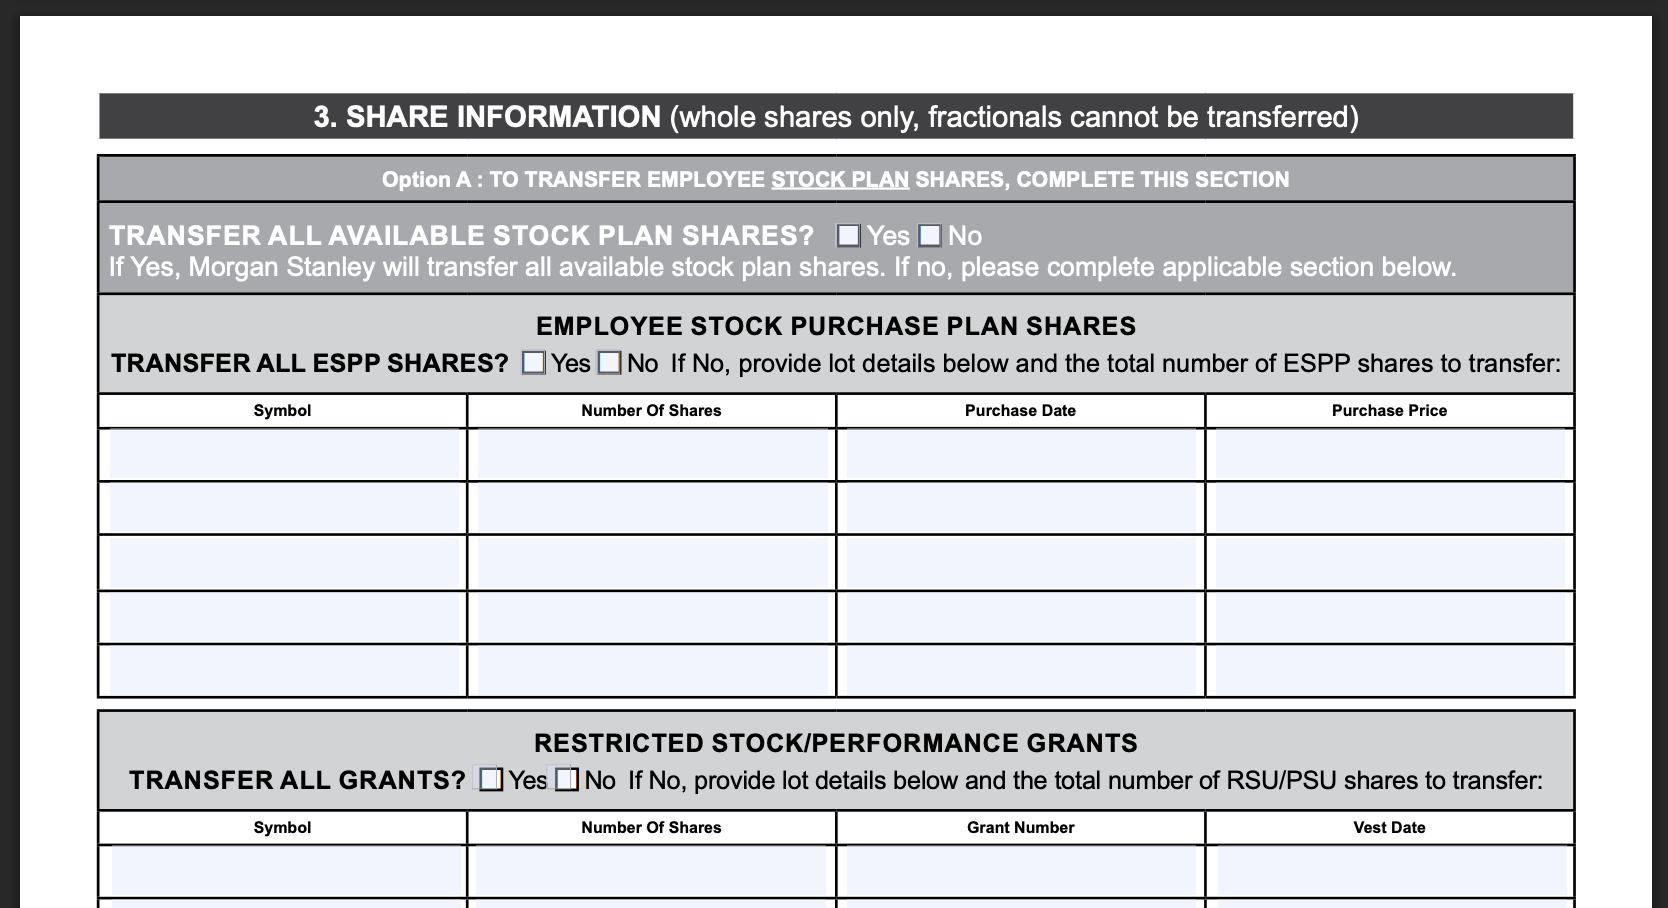
そして、p2は売却する株券についての情報を書くようですが、全部移動なら、YESのチェックをオンにするだけなので、細かいことは考えなくてもいいようです。
p3に署名するところがありますが、まあ、キータイプすることが署名になるようで、画面の指示通りに作業すればOKです。ということで、申請書はこれだけです。P.1のOption Bがややこしいというか、聞かないとわからない情報なので、これだけはしっかりと情報収集しておけば、ほぼ問題ないかと思います。申請つまりアップロード後に、PDFのダウンロードが可能なので、控えとしてダウンロードしておきましょう。
ちなみに、1度申請をして、サイトでは処理中のようなメッセージが出ていたのですが、何の音沙汰もありません。1ヶ月くらいして改めて申請したPDFをチェックしたら、最初の番号が間違えているじゃないですか。実は最初の申請は電話してここに申込書があると聞いて、そこで電話が終わると思ったら、「待っているから書いてね〜」って感じで待ってくれていたので、焦って入力したのでした。で、「間違っているから処理しないぞー」とは連絡してくれないようです。ということで、やり方はわかっているので、また、同じように申請をしたら、2日後くらいにメールで処理に入ったと通知が来て、申請から、10日くらいで、野村證券の口座に株券が移動しました。
ということで、無事にトランスファーできました。よかった…
]]>まず、背景ですが、実際のデータベースで説明します。次のような、タイムスタンプと「金額」のフィールドがあるようなデータベースがあるとします。話を簡単にするために、ごくシンプルなデータベースで説明します。「年月」フィールドは計算フィールドで、「日時」フィールドより求めています。この先やりたいことは、『月ごとの金額の合計を求める』ということです。ということで、金額フィールドの合計を求める集計フィールド「金額の合計」も定義しました。
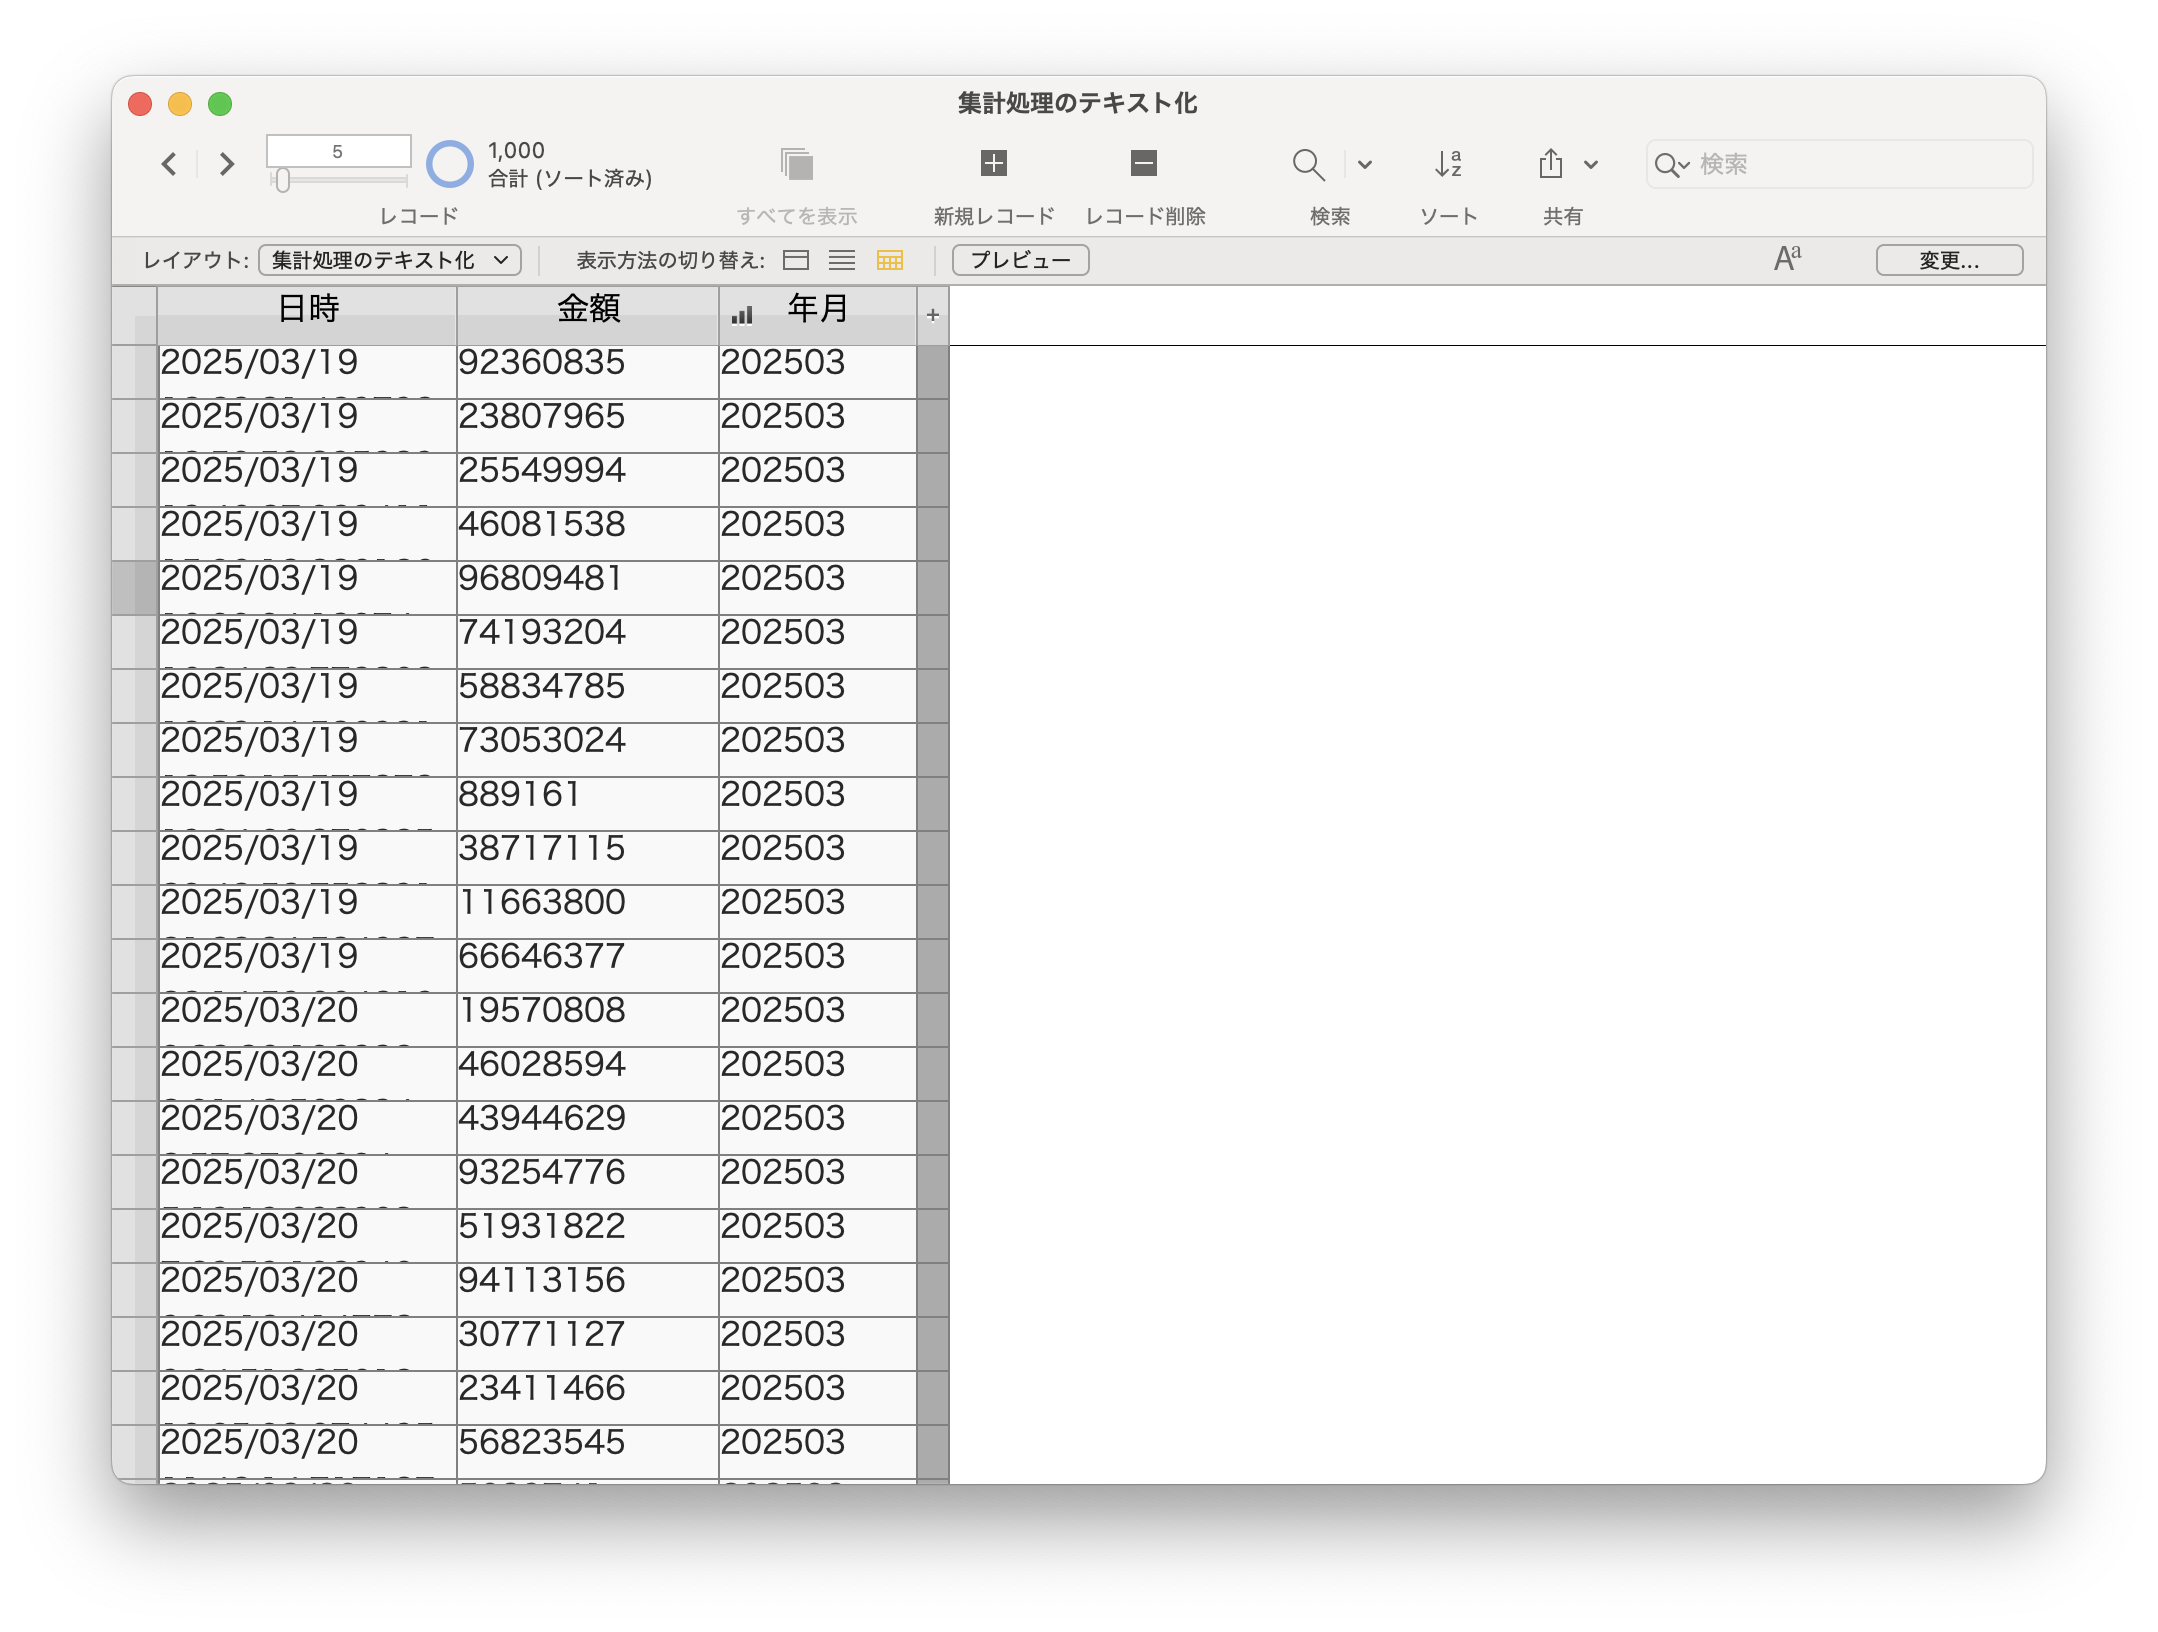
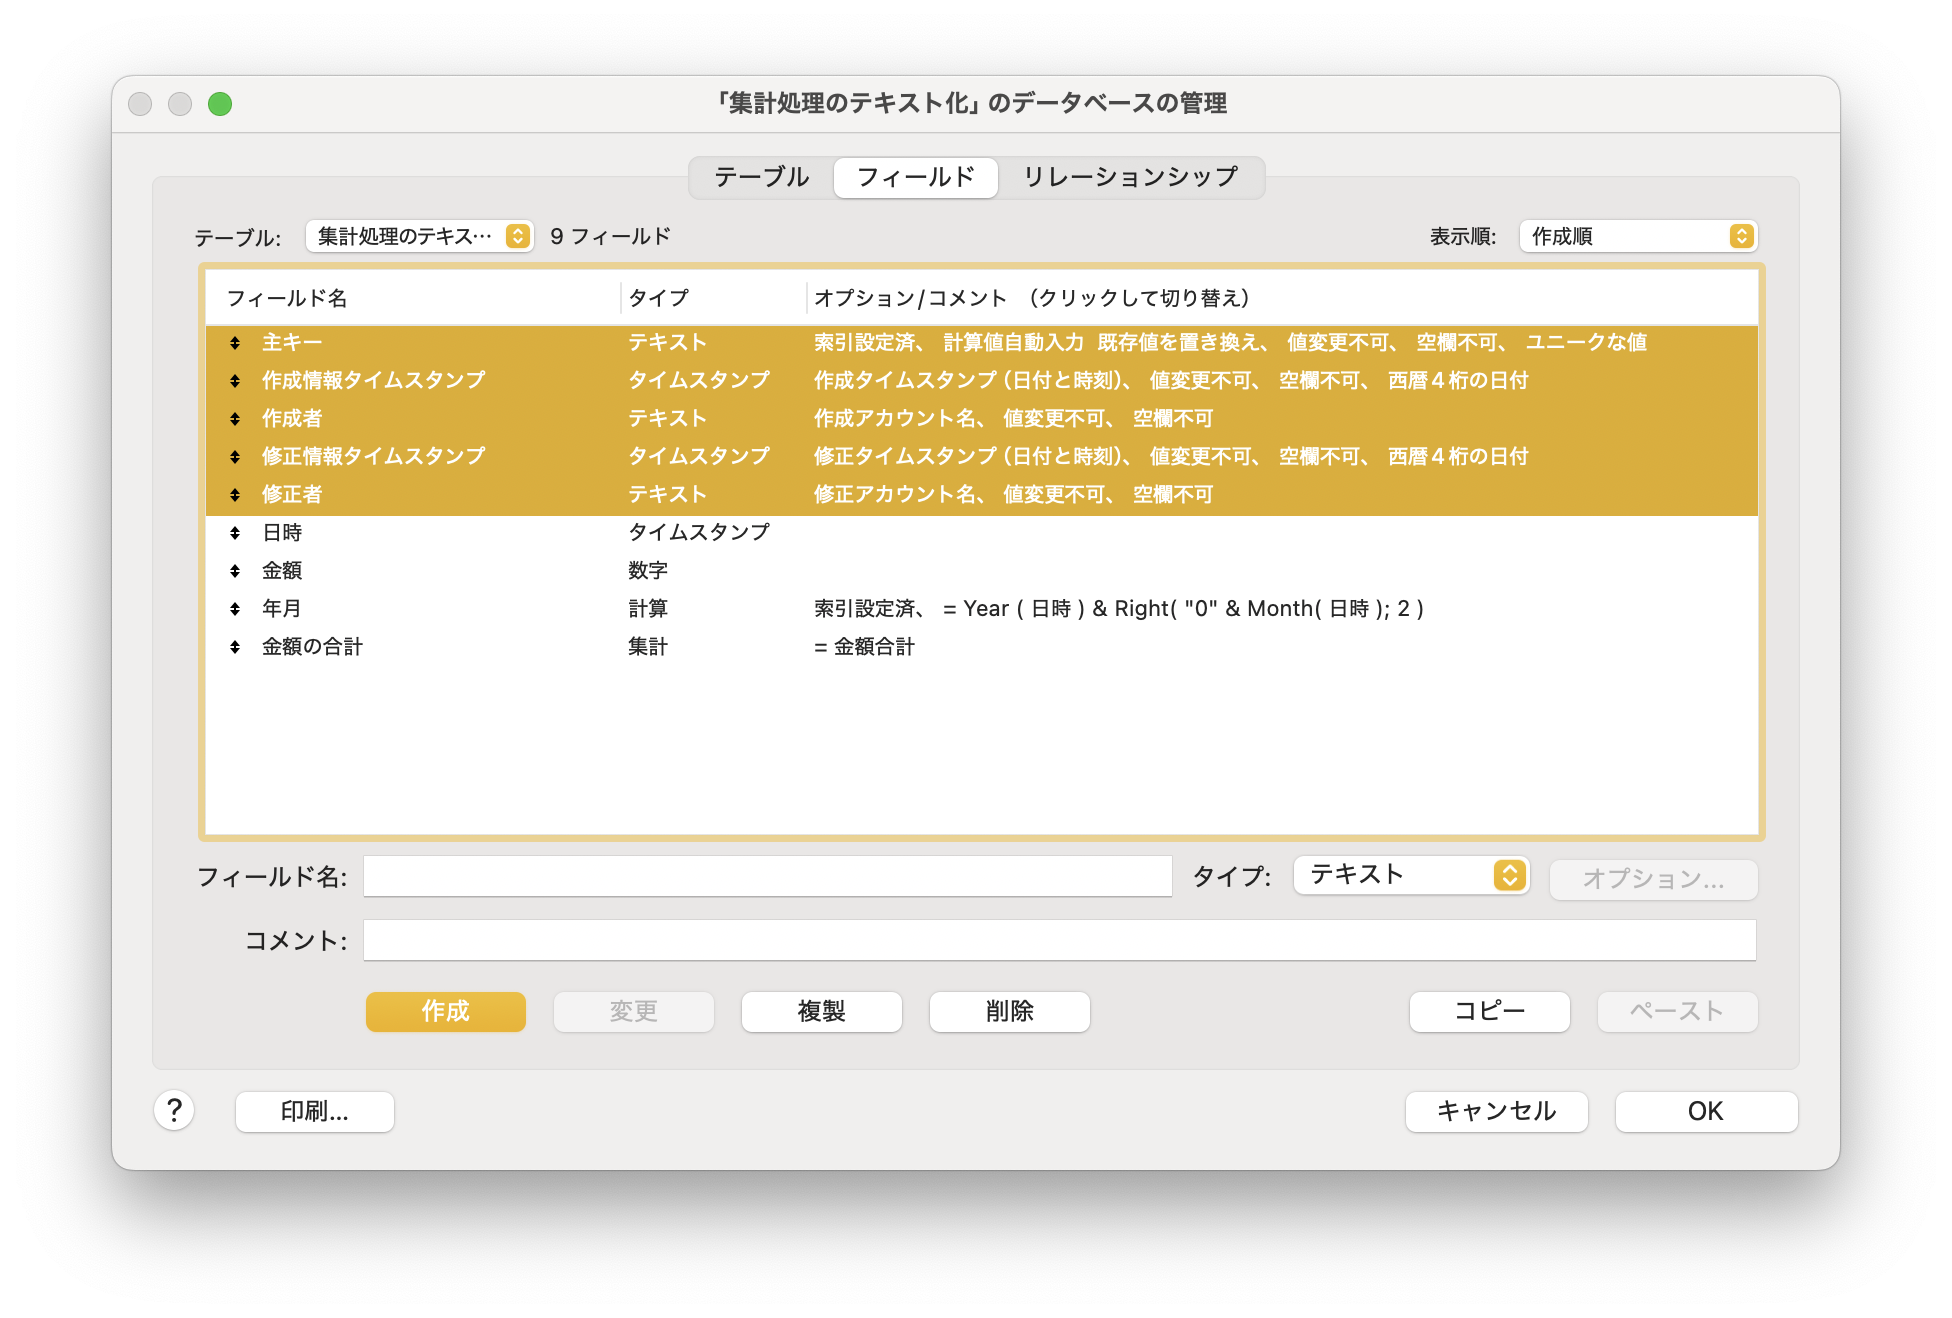
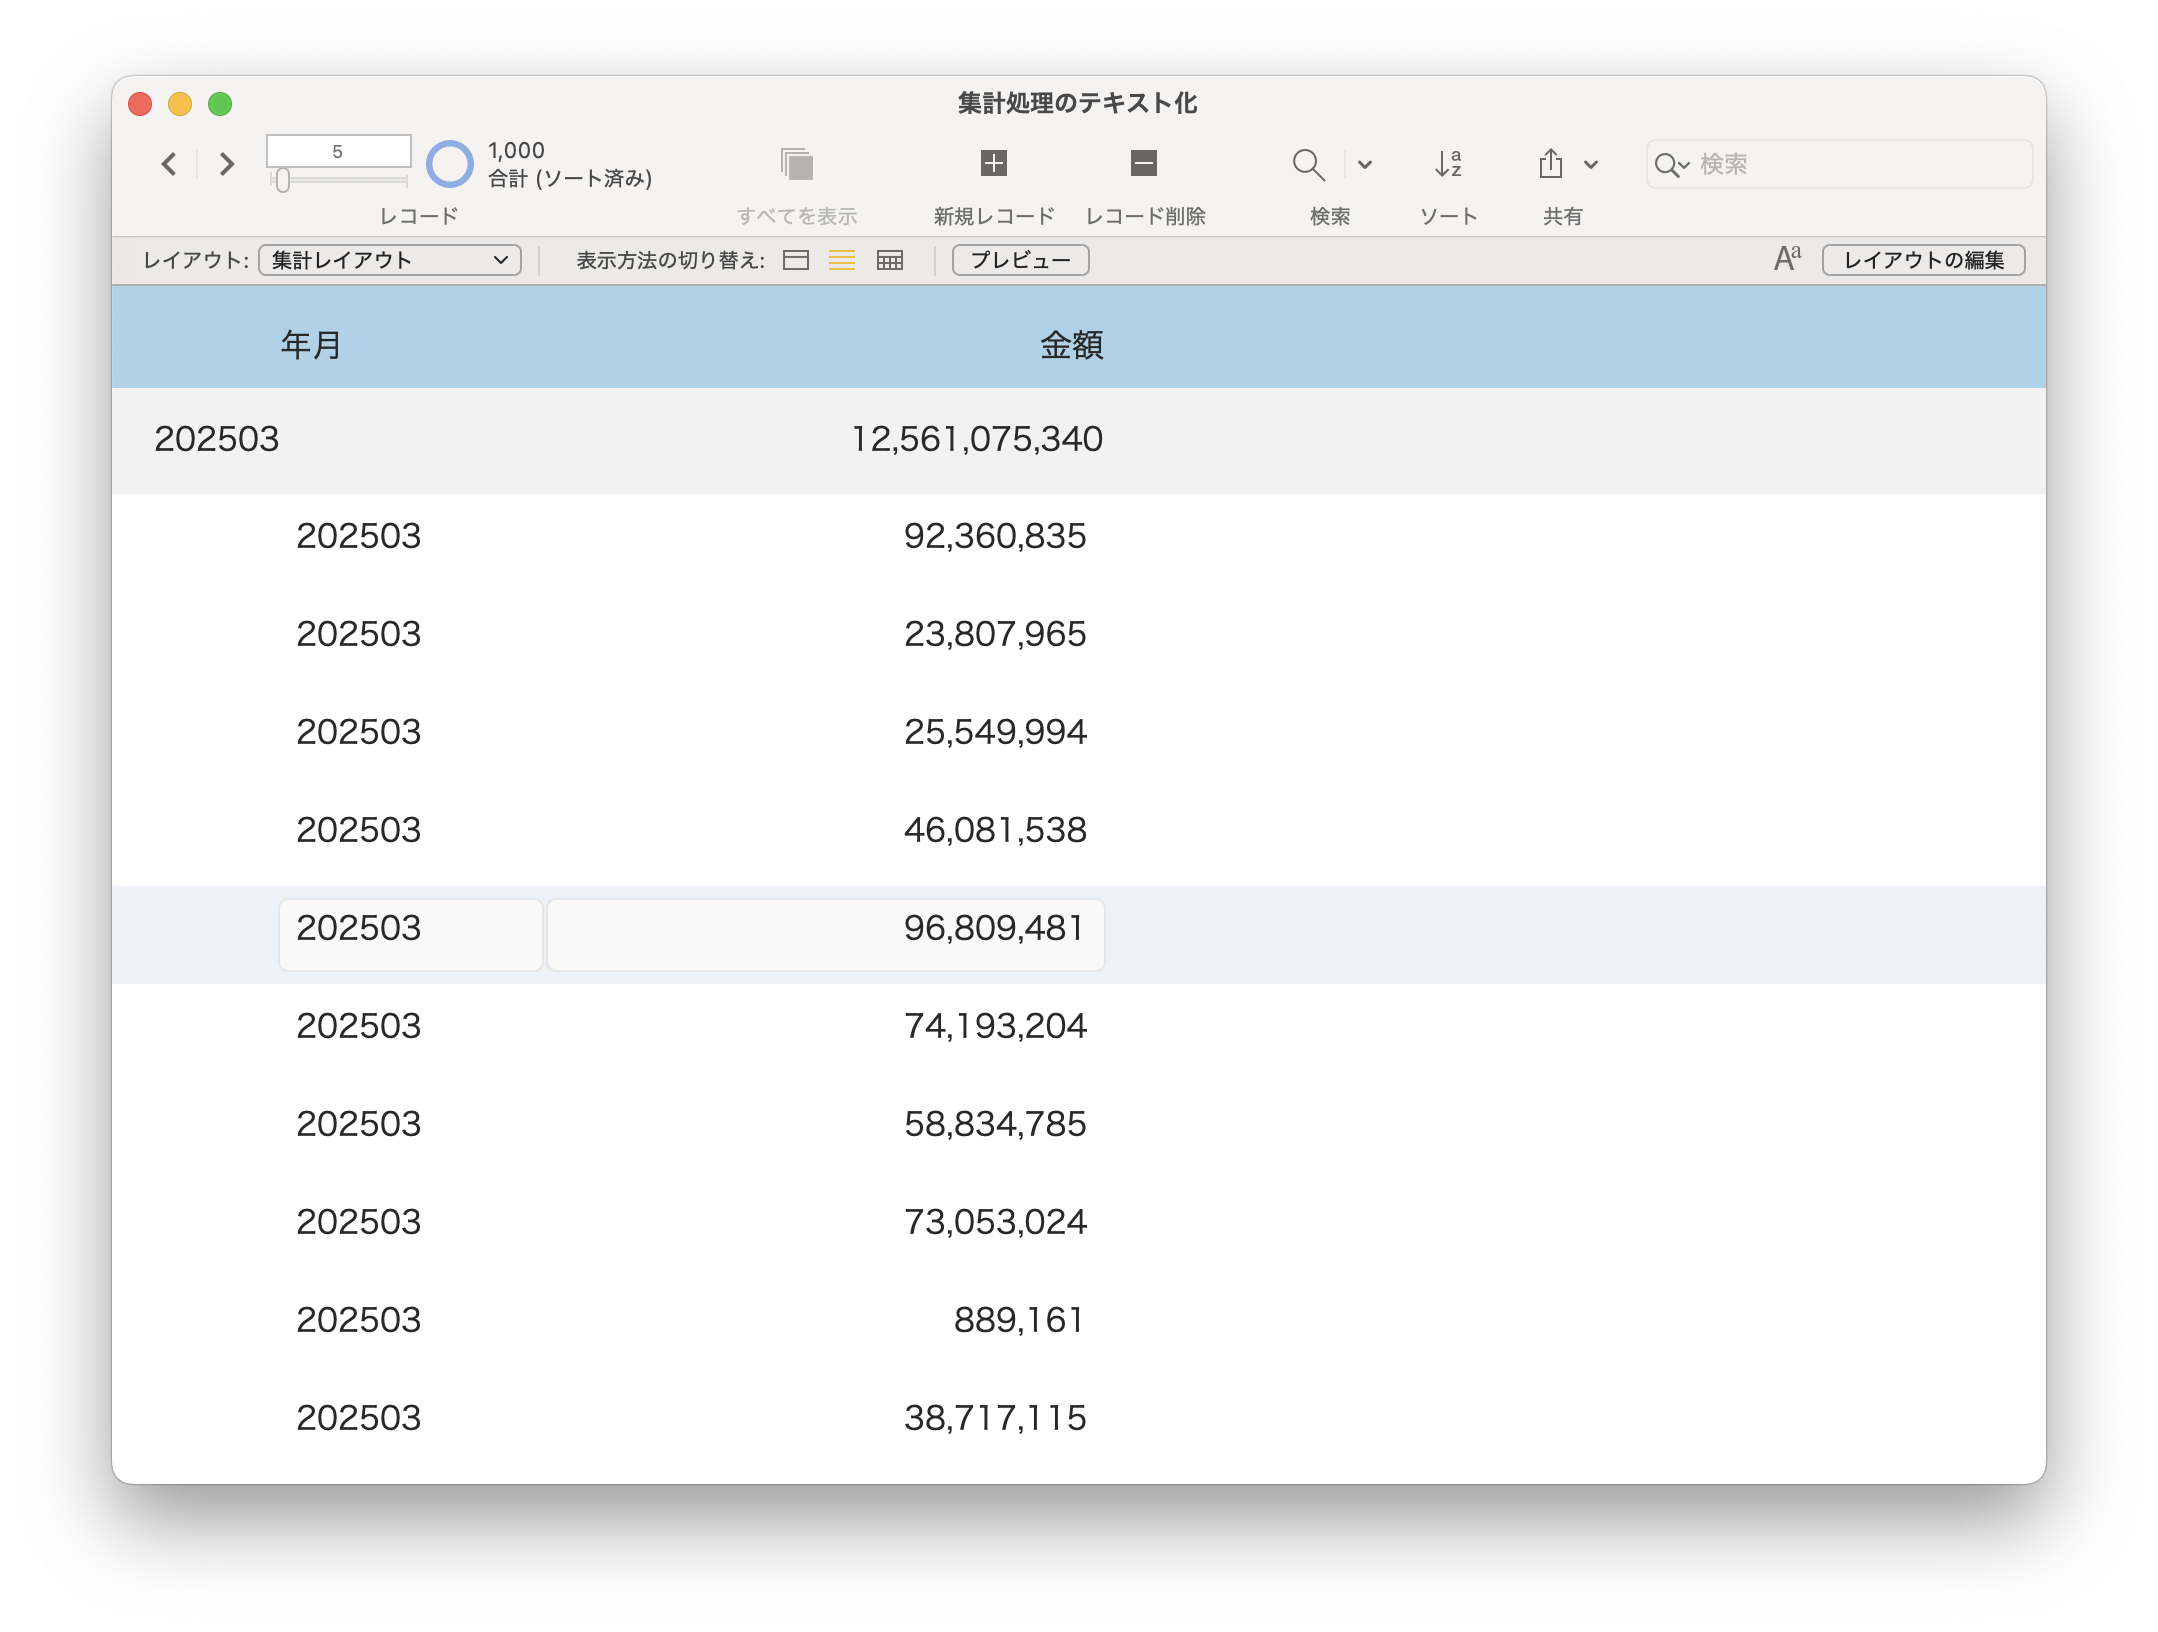
ここから、新しいレイアウトを作ります。詳細は省略しますが、年月フィールドでソートした場合に表示される小計パートをボディパートの上に設置し、そこには「年月」および「金額の合計」フィールドを配置します。以下の図では、小計パートは薄いグレーの背景です。白背景がボディパートで、「年月」「金額」フィールドが配置されています。一応、全レコードを表示した上でソートして、以下のように集計が出ています。
ここで、「各月の集計結果だけが欲しい」という要求が発生しました。もちろん、上記レイアウトのボディパートを消せばいいですね(消さないで見えなくすることができればいいのにと思いながら)。消したら、もちろん、小計パートだけが見えます。
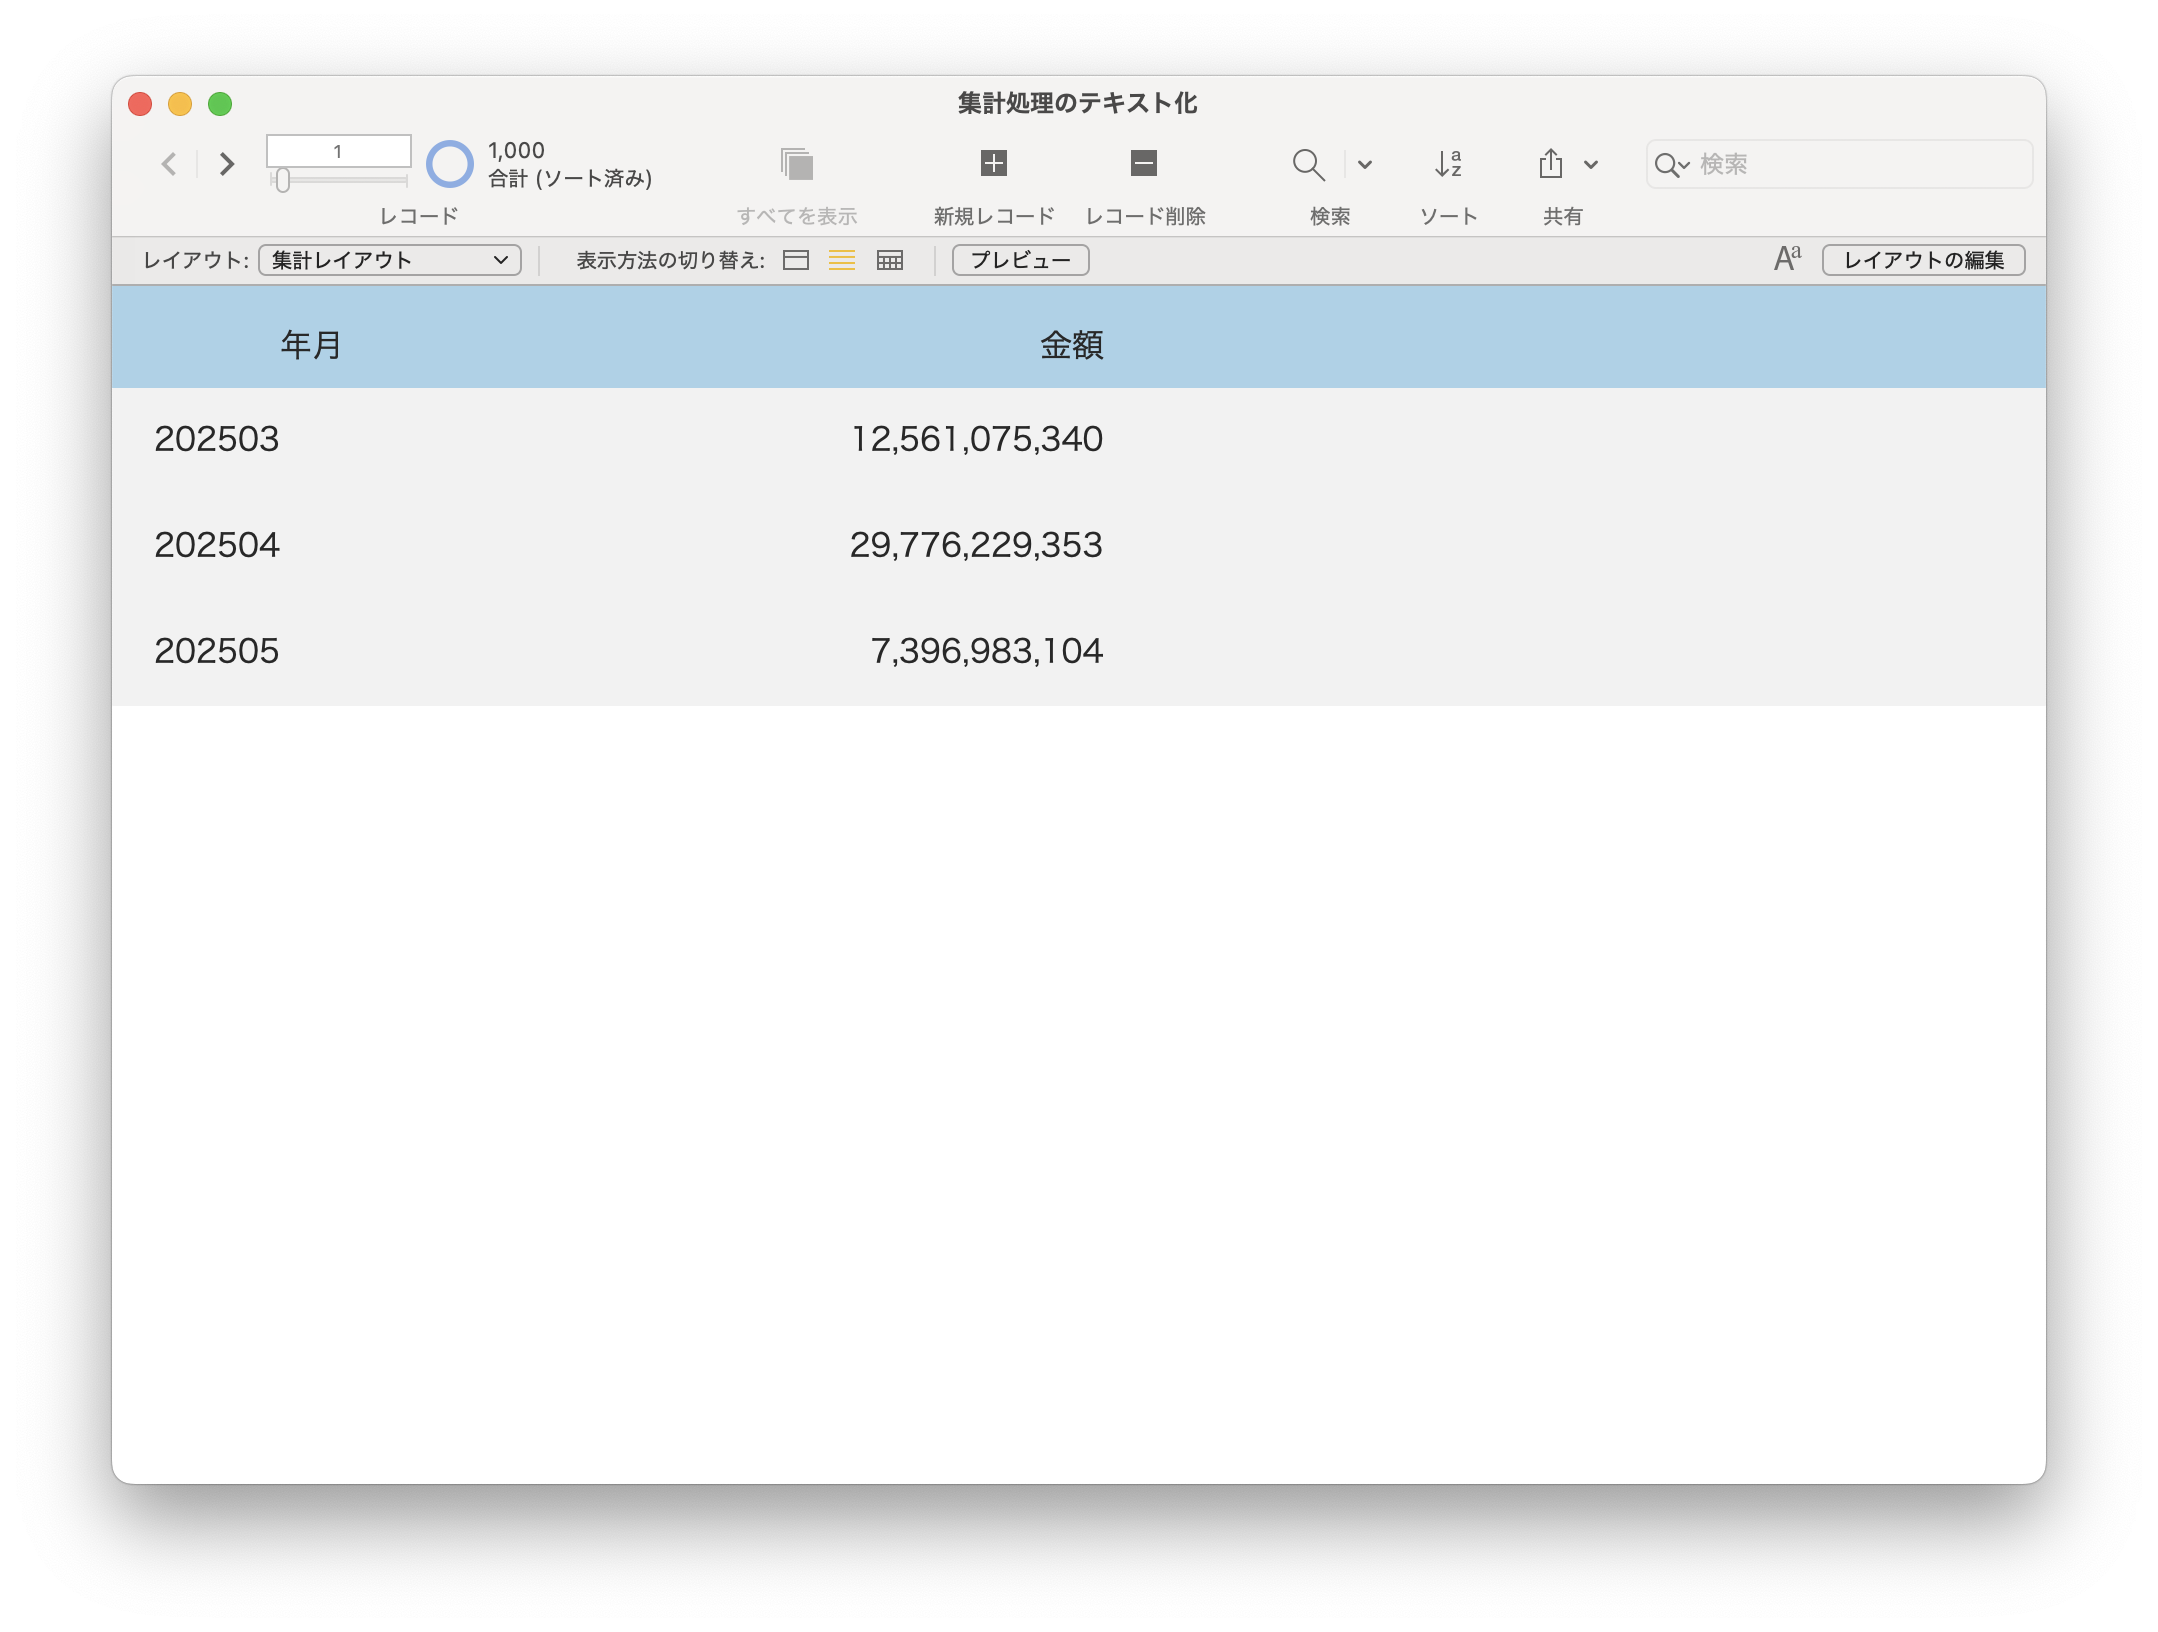
これでOKと思ったら、「この画面の結果をテキストファイルで欲しい」という要求がさらに出ました。最も、最初から集計結果のテキストだけ欲しいというのなら、集計フィールドを使わないで、FileMaker以外の手段を考えるかもしれませんが、集計レイアウトを作る上で、さらにテキストも欲しいということになったとしてください。
では、このままエクスポートしても、3行のテキストファイルは作られません。エクスポートの中身はボディパートに展開された集計元のレコードです。もちろん、「金額の合計」フィールドには金額の合計はあるのですが、1ヶ月分でも何百のレコードがありそうです。手で消すのもちょっと無理があります。
もしかしたら、以下のようなスクリプトでなんとかなるでしょうと思う人もいるかもしれません。つまり、レイアウトで最初のレコードから最後のレコードまでグルグル回してフィールド値を変数に取り込むのです。
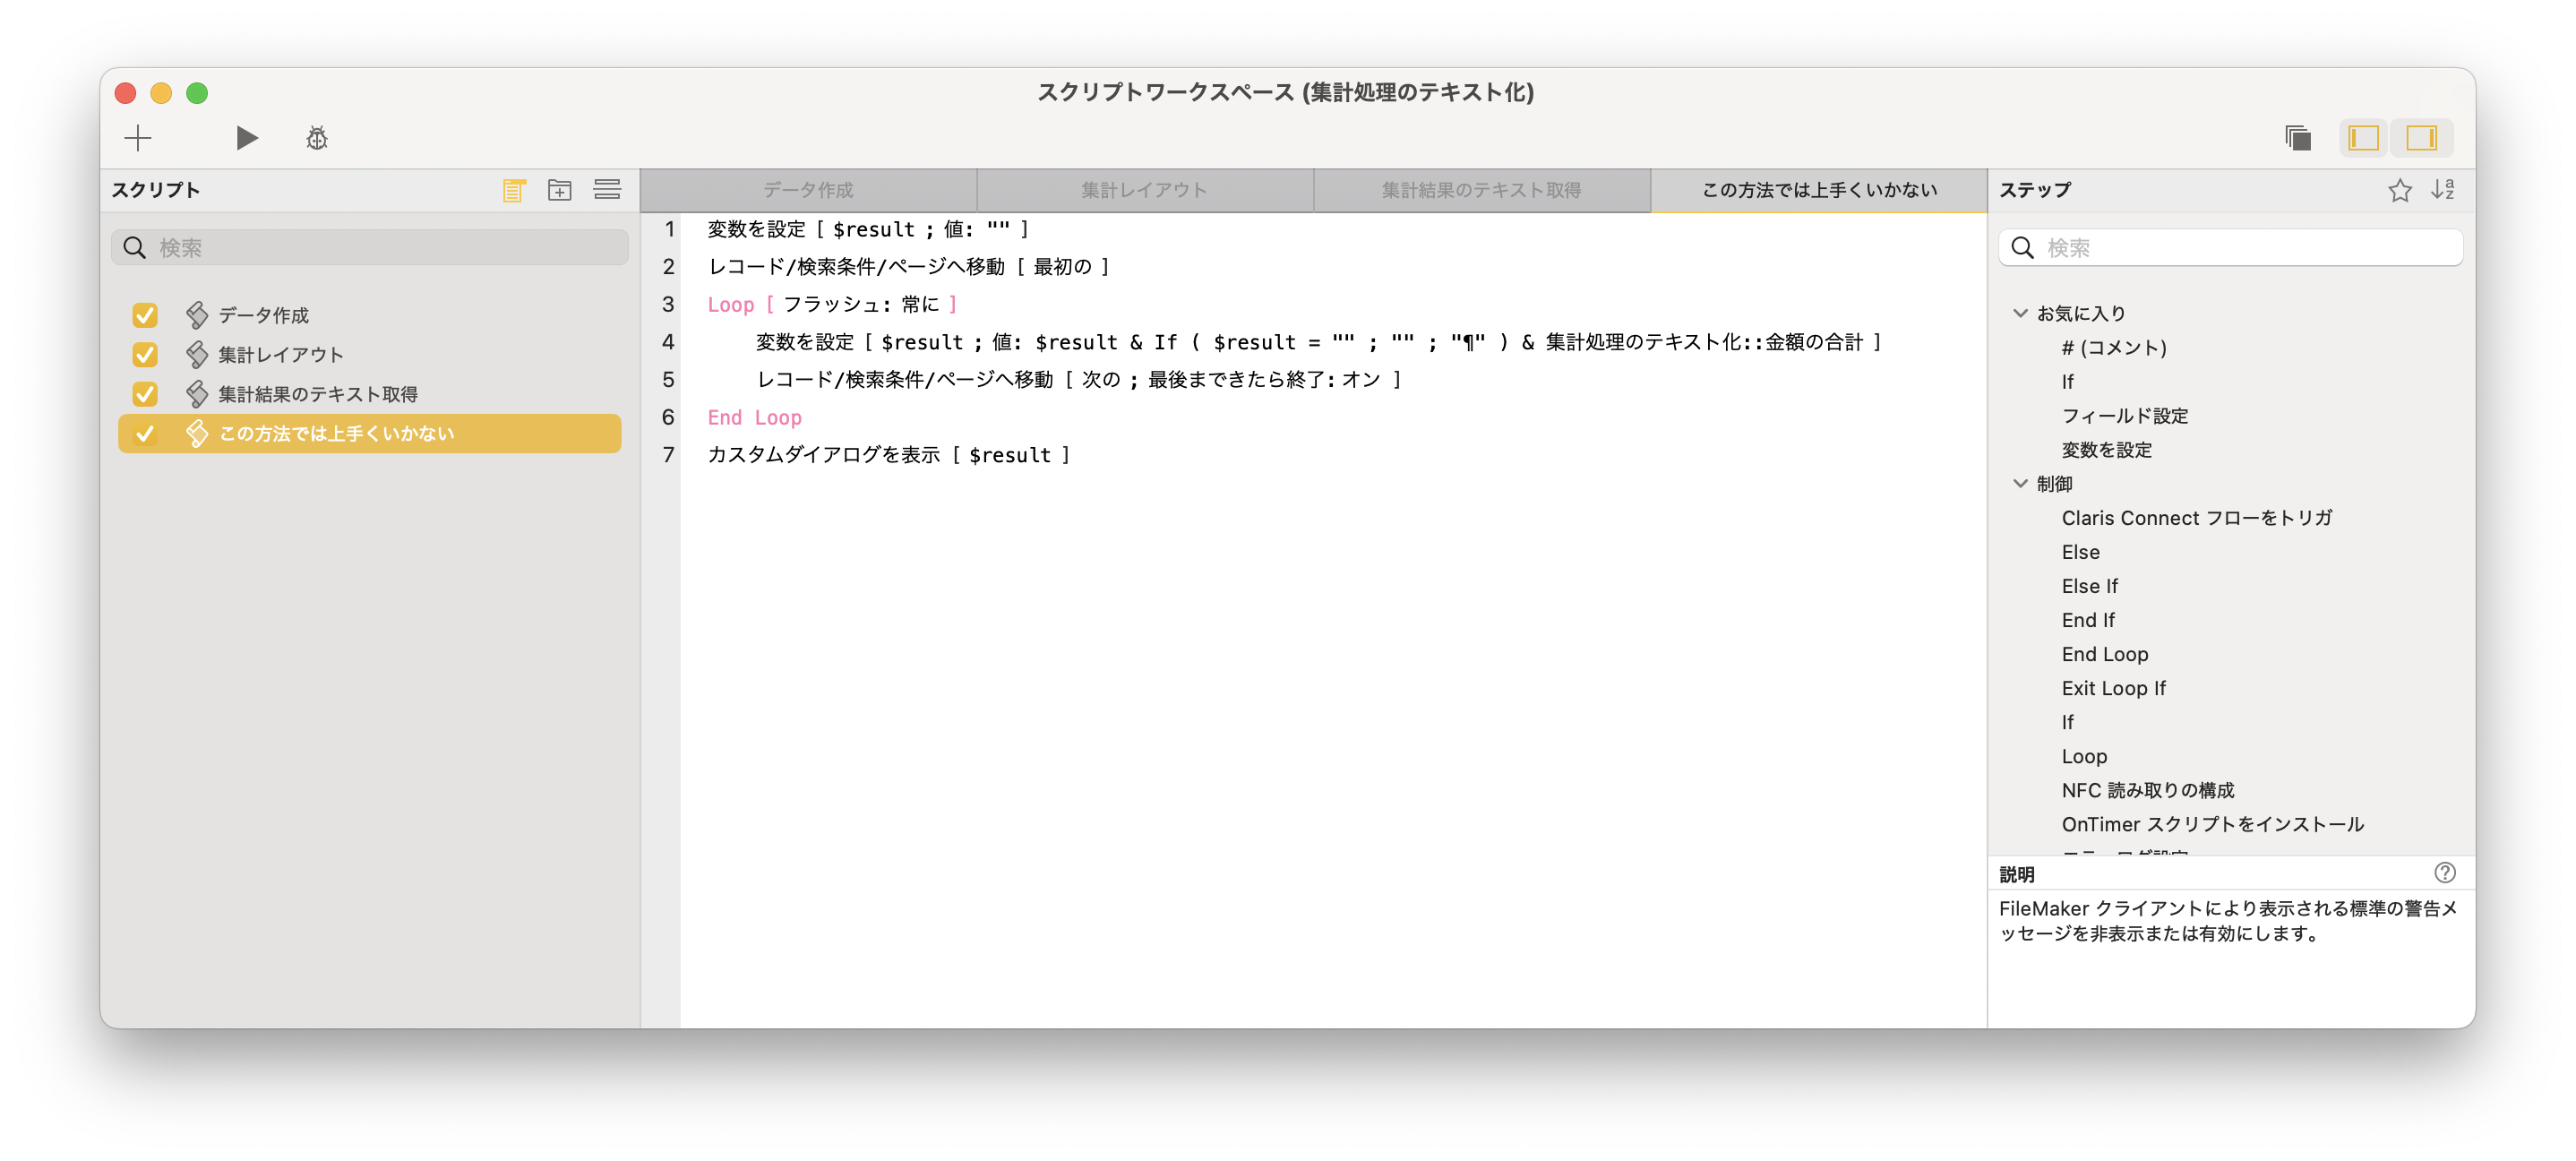
このスクリプトを実行した結果、$result変数は、こんな感じ。多分、レコード数の1000だけあって、最初のいくつかだけが見えています。細かいことはともかく、レイアウトに見える結果と大きく違います。
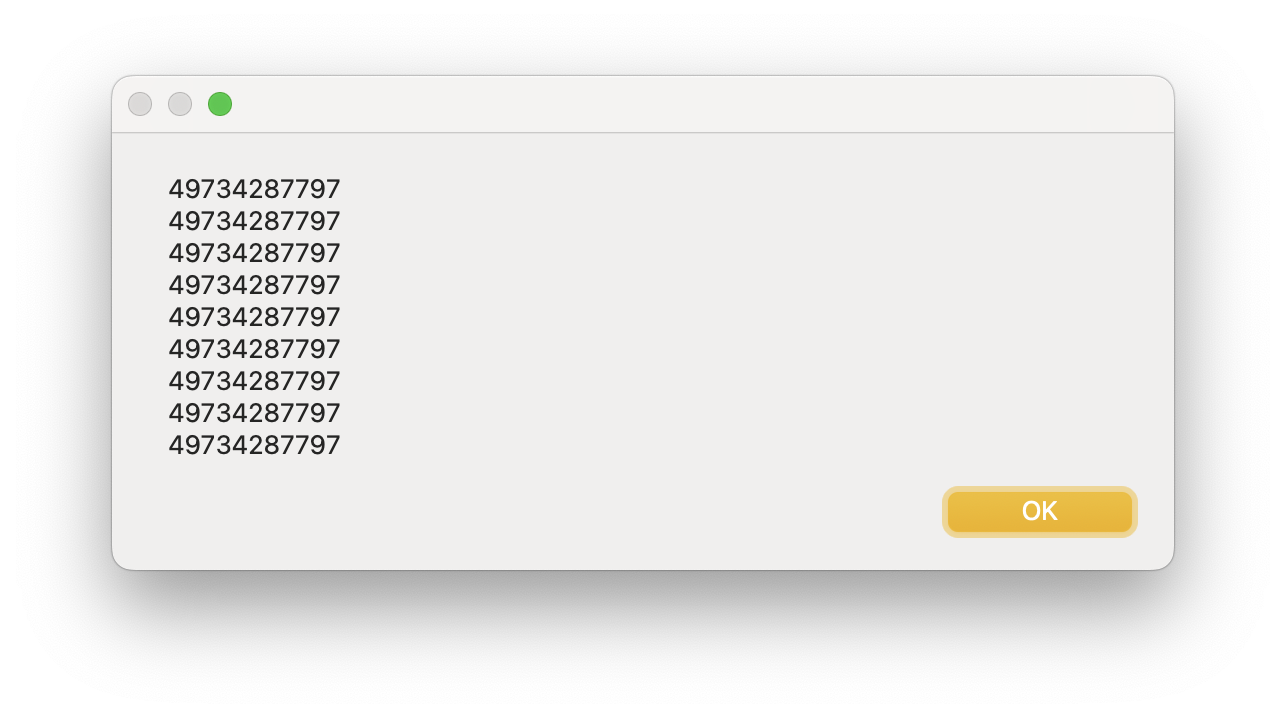
この方法でのスクリプトは、ボディパートを順番に舐めて行くのであって、小計パートは関係ありません。残念ながら小計パートを選択するということがFileMakerではできないのであって、この方法ではどうすることもできません。もっとも、「年月」フィールドの変わり目を…とやったらできるのでしょうけど、この方法で、数万くらいのレコードになると、そこそこ時間がかかります。データが多いと現実的ではありません。
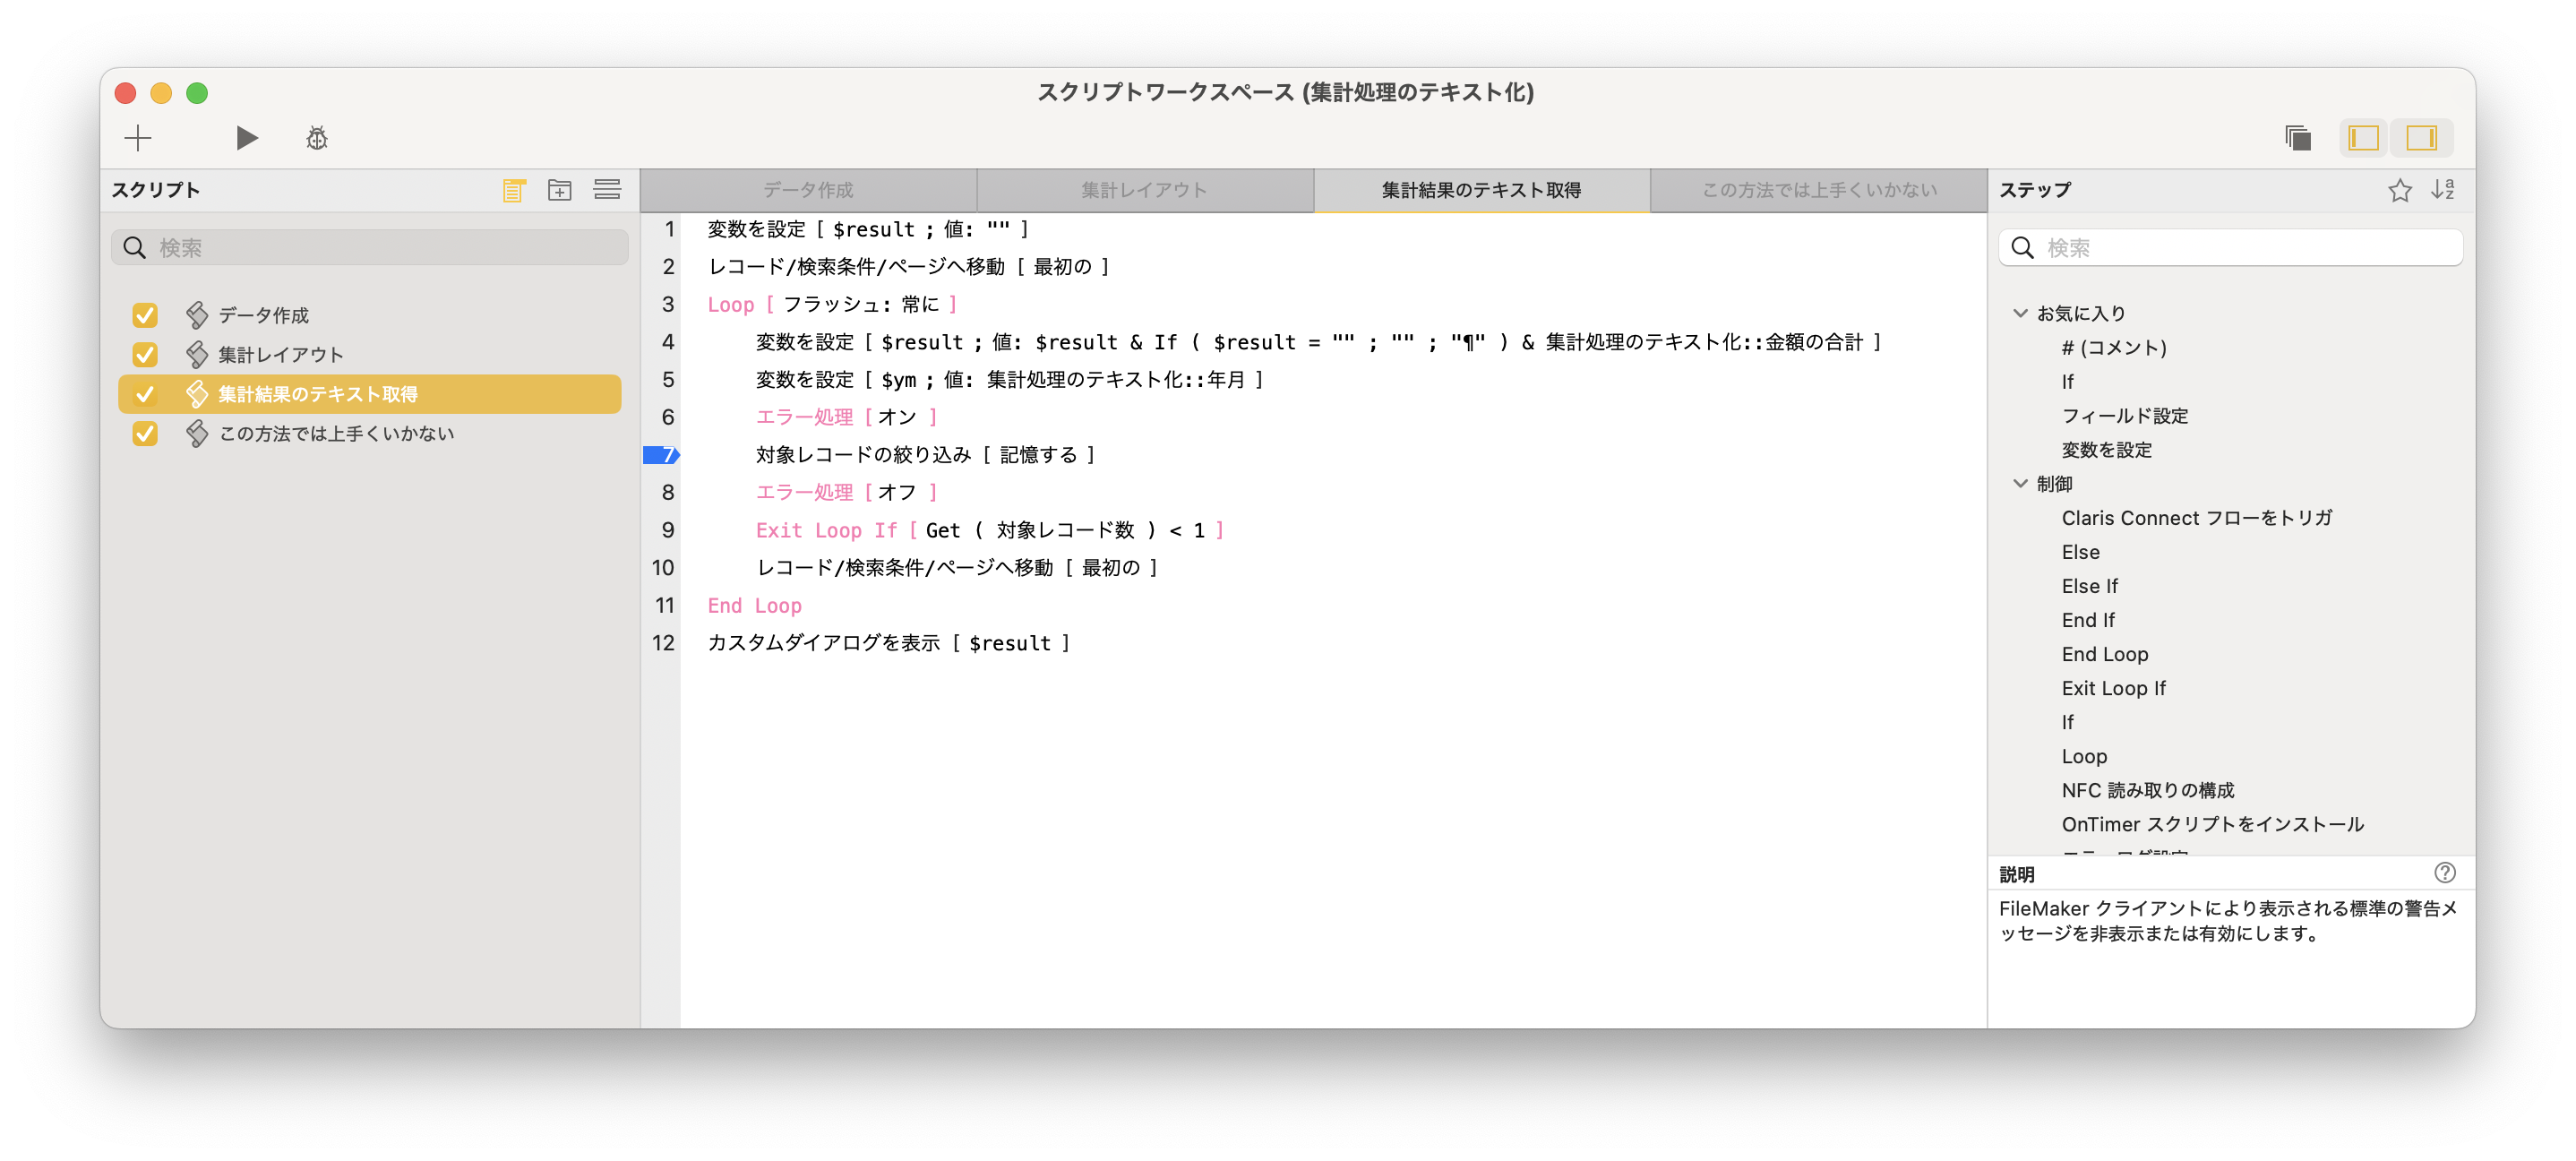
しかしながら、ちょっとした発想の転換で、同じような方法ながら、小計に見えている数値だけを取り出すスクリプトが書けました。次のようなスクリプトで、結果として見えるダイアログボックスも紹介します。ダイアログボックスは、集計レイアウトの小計パートに見える「金額の合計」フィールドの数値が見えています。
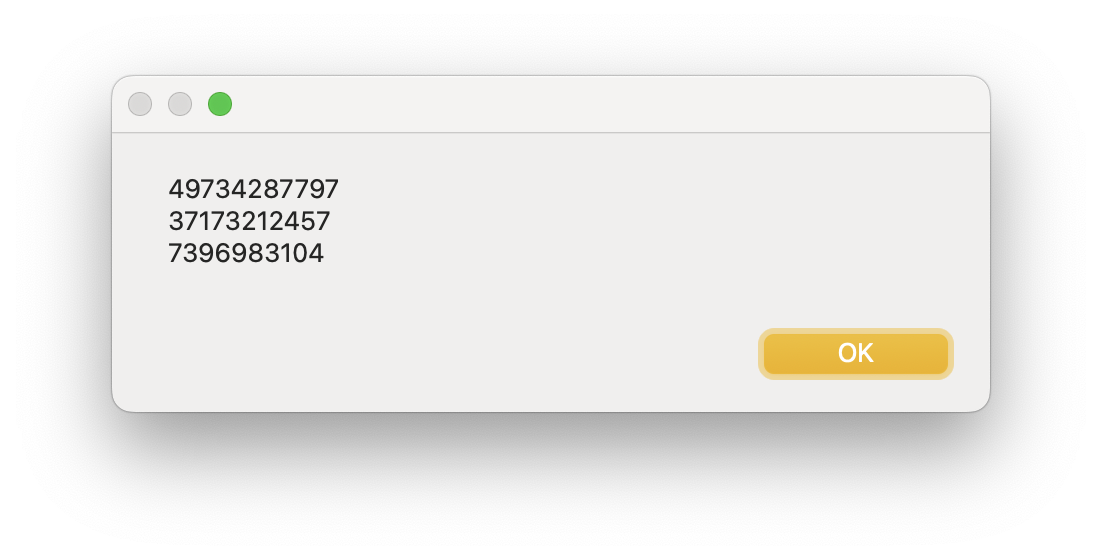
ここでは改行付きのテキスト(リスト形式)で取り出しましたが、変数をそのままテキストファイルに書き出すこともできますし、JSON形式で取り出すということもできます。とにかく、小計パートでのフィールドあるいは集計フィールドだけを取り出せるということがポイントなので、細かくはソリューションに合わせて対処してください。
このスクリプトのポイントは、「対象レコードの絞り込み」スクリプトステップを利用するということです。なお、レコードが0になるまで省略を続けるので、「エラー処理」スクリプトステップで、「レコードがない」というエラーを出ないようにしておきます。なお、前述のスクリプトは、最初からレコードがない場合にはいい感じでは動いてくれないと思いますので、データがあること前提です。デバッガでステップ動作していただければ大体わかると思いますが、このスクリプトは次のような流れを想定しています。
- 先頭のレコードを選択する。これは「年月」フィールドの最初のグループ(202503)に属するレコードなので、そのレコードの「金額の合計」フィールドは集計されて、202503の合計金額(49734287797)が得られる
- 取り出したレコードの所属するグループのレコードを全部省略する。つまり、ここでは年月が202503のレコードを省略する。そのために「対象レコードの絞り込み」スクリプトステップを利用する
- 最初のレコードに移動すると、レイアウトでは2つ目に見えていた「年月」フィールドが202504のグループのレコードになる。「金額の合計」フィールドから、202504の金額の合計値が得られる
- レコードの絞り込み後レコードがなくなるまで2,3を続ける
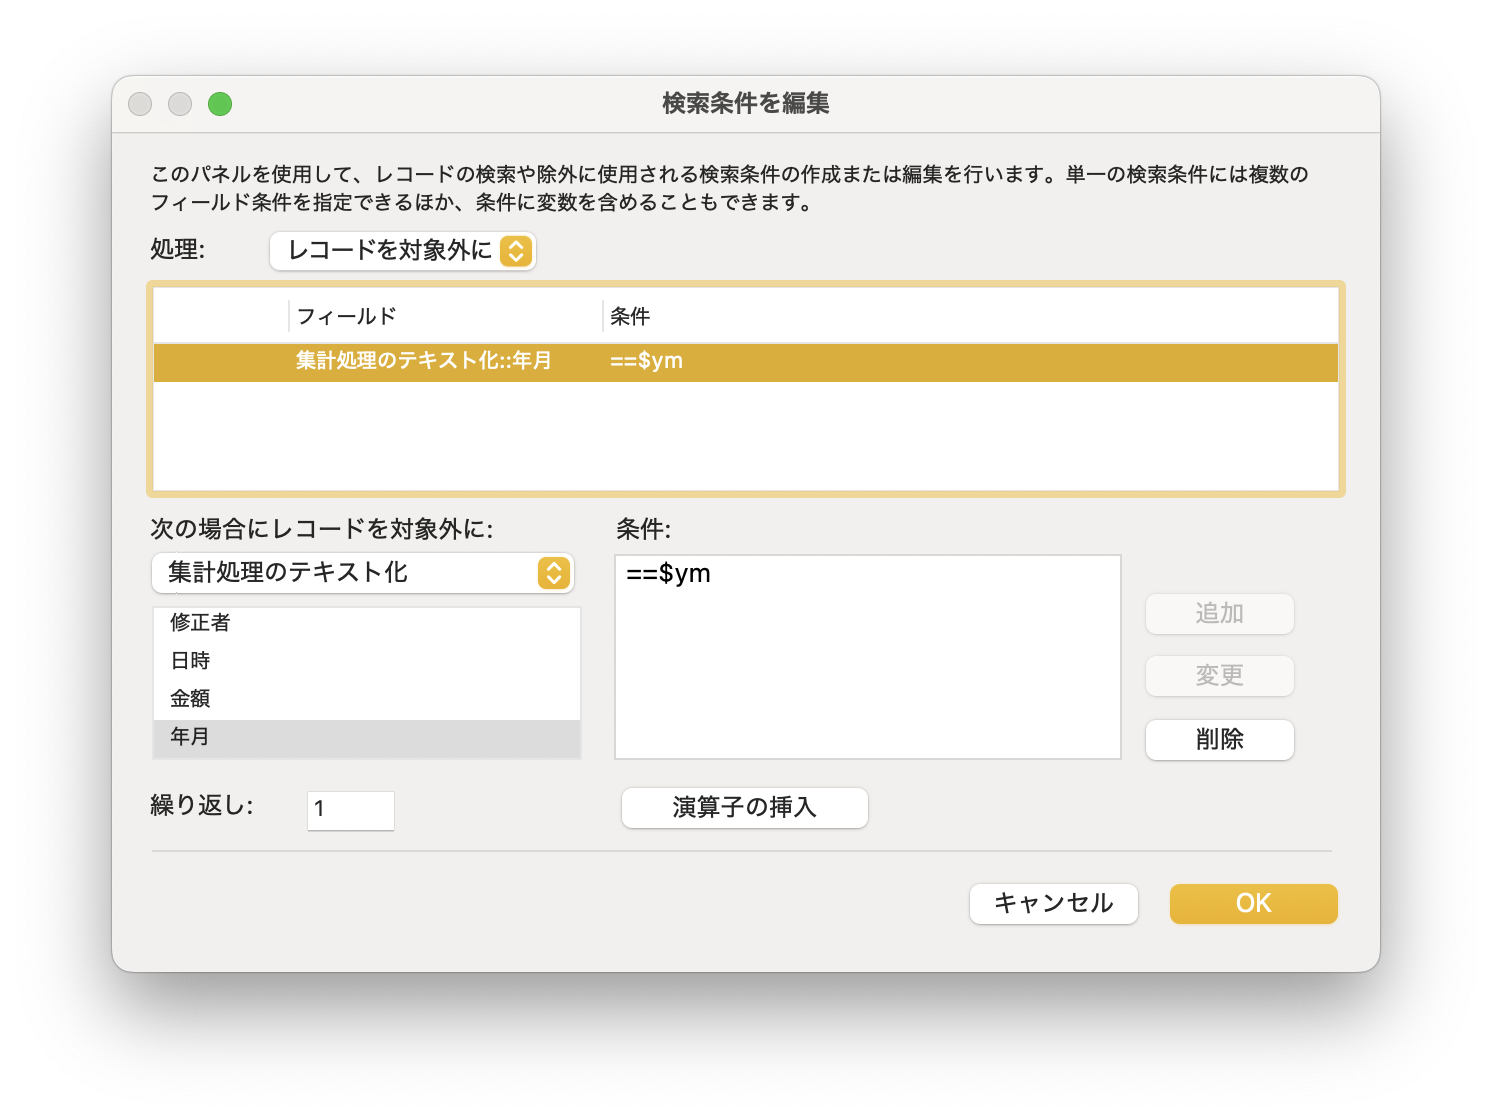
レコードを移動するのは諦めて、先頭のレコードから取り出せるものをうまく利用します。データを取り出したら、そのグループを集計対象外、つまり省略してしまうのです。いろんなやり方はあるでしょうけど、「対象レコードの絞り込み」スクリプトステップが便利です。変数$ymに現在の「年月」フィールドの値を入れておいて、検索条件を組み立てます。このように必ず6桁の数値になるようなフィールドの検索では==をつけるのはちょっとやりすぎかもしれませんが、念の為ということで。ポイントは、処理として「レコードを対象外に」を選択することです。つまり、条件に合ったレコードを対象外にして、集計対象から排除するのです。
このような処理は非常に遅いのでは無いかと危惧するかもしれませんが、結構早いです。集計時に一旦レコードを全部ロードしていて、対象外にする処理では、メモリの移動や増加、ネットワーク処理などは入らないからでしょう。すぐに終わります。10万件で試してみても、数秒もかからずに終わりました。
小計パートが2つある場合でも、同様にできました。ただし、レコードを対象外にする場合には、2つの小計パートのソート対象フィールドに対して、ANDで検索をかけます。ということで、ちょっとずつレコードを省略して最初のレコードの集計値を取り出せば良いので、小計パートがいくつになっても大丈夫です。
ちなみに、レコードの省略では、対象レコードが増えないので、ソート結果はそのまま保持されるという動作もこの方法での集計結果の取得を実現する仕様の1つです。
集計結果だけのテキストを得るにはいろんな方法がありますが、この方法は、FileMakerの中だけで完結しているというところが大きなポイントでしょう。外部にCSVを出すなどして処理するのは別システムの管理がかえって面倒になりますし、後々のメンテナンスを考えれば、システム基盤はシンプルな方が良いということになります。ちなみに、この仕組みがどんなところで必要になったかと言うと、複数の異なるテーブルの集計結果を1つの表にまとめたかったからです。ただ、その纏める部分は色々考えて、集計結果をJSONで得て、WebビューでJavaScript処理で表を作るということで解決しました。
テストしたデータベースも公開します。レコードは10万くらいにしてあります。あまり、使い勝手は良くないですが、ご了承ください。
]]>私は、Webアプリケーションのフレームワーク「INTER-Mediator」を開発している。なるべくシンプルにアプリケーション開発が可能なような仕組みをフレークワークとして提供している。例えば、HTMLページで<input data-im=”item@name”>とすれば、このテキストフィールドにitemテーブルのnameフィールドの値が表示され、変更すれば自動的にフィールドがアップデートされるといった仕組みだ。もちろん、もっと色々あるが、それはサイトを見ていただくとしよう。このINTER-Mediatorを試してみるための素材として、本体とは別にレポジトリを提供している。これを以下、「トライアル」と呼ぶ。トライアルを稼働させれば、INTER-Mediatorのコードの一部で提供しているサンプルのページを稼働させてみることができる。さらにはチュートリアルの演習を進める基盤としても稼働できるようになっている。このトライアル自体を容易にセットアップできるようにするために、Dockerの素材をレポジトリに提供している。このレポジトリをダウンロードして、レポジトリのルートで「docker compose up -d」などとすれば、ちょっと待てばサンプルアプリやチュートリアルを進めるための仕組みが稼働して、「http://localhost:9080」にブラウザから接続すれば良いという仕掛けである。
トライアルのDockerコンテナ作成は、当初はいわゆるDockerfileに不足するPHPライブラリのインストールやビルド等を含めたものを作っていた。php-apacheというコンテナをもとにしているが、結構必要なものを削ってあるので、追加のセットアップが必要なのである。そのビルドに結構時間がかかるというのも問題だったのだが、ある時から、そのセットアップが途中で落ちるようになってきた。再度、docker compose …とやれば落ちたところをやり直して先に進むのだが、これではちょっと使う側としては心許ないだろうから、なんとかしないといけないということになった。そこで、php-apacheに加えて、INTER-Mediatorを稼働するのに必要なphpの動作基盤を作って、DockerfileのFROMには必要なライブラリが含まれたphp-apacheを利用するようにすることで、スピードおよびビルドの失敗に対して対処できると考えた。そして、その基盤となるコンテナを、GitHub Packegesで配布することにし、アクションを定義するなどした。名付けてphp-apache_imである。imと名前に入っているがINTER-Mediator自体は入っていない。INTER-Mediatorはcomposer.jsonファイルに定義して、composerでインストールするようにすることを想定している。
まず、自分のアカウントmsykに、INTER-Mediatorのクローンがあるので、そこでアクションを動かして、マニュアル実行するようにしてパッケージを作ってみた。実際に動くアクションを紹介してもらい(松尾さん、Thanks!)それをもとにアクションを作りつつ、Dockerfileを構築して、思いの外、すぐにできてしまった。そして、トライアルのdocker-compose.ymlファイルで、自分のアカウントのパッケージを指定すると、数回程度のトライでうまく行った! これで、トライアルの構築は早くて安定するということだ。しかしながら、INTER-Mediatorのためのコンテナでもあるので、INTER-Mediatorのレポジトリに置きたい。このレポジトリは、Organizationとして用意した側にある。Organizationでも同じだろうと思ったのが甘かった。ということで、ここから本題なのだが(まだ前振りだったのか!)、Organization側に作ったGitHub Packagesは、なぜか利用できないのである。アクションを動かしてのエラーは出なかった。しかし、トライアルでdocker compose …とやると、次のようなエラーが出た。検索に引っかかるように、とりあえず、そのまま掲載する。
% docker compose up -d
[+] Running 1/1
 ✔ db Pulled                                                                                                                                                3.5s
[+] Building 1.1s (2/2) FINISHED                                                                                                            docker:desktop-linux
 => [php-apache_im internal] load build definition from Dockerfile_Prebuild                                                                                 0.0s
 => => transferring dockerfile: 270B                                                                                                                        0.0s
 => ERROR [php-apache_im internal] load metadata for ghcr.io/inter-mediator/php-apache_im:latest                                                            1.1s
------
 > [php-apache_im internal] load metadata for ghcr.io/inter-mediator/php-apache_im:latest:
------
failed to solve: ghcr.io/inter-mediator/php-apache_im:latest: failed to resolve source metadata for ghcr.io/inter-mediator/php-apache_im:latest: failed to authorize: failed to fetch anonymous token: unexpected status from GET request to https://ghcr.io/token?scope=repository%3Ainter-mediator%2Fphp-apache_im%3Apull&service=ghcr.io: 401 Unauthorized
msyk@msyk-macbook-pro IMApp_Trial % docker compose up -d
[+] Building 0.8s (2/2) FINISHED                                                                                                            docker:desktop-linux
 => [php-apache_im internal] load build definition from Dockerfile_Prebuild                                                                                 0.0s
 => => transferring dockerfile: 268B                                                                                                                        0.0s
 => ERROR [php-apache_im internal] load metadata for ghcr.io/inter-mediator/php-apache_im:latest                                                            0.7s
------
 > [php-apache_im internal] load metadata for ghcr.io/inter-mediator/php-apache_im:latest:
------
failed to solve: ghcr.io/inter-mediator/php-apache_im:latest: failed to resolve source metadata for ghcr.io/inter-mediator/php-apache_im:latest: failed to authorize: failed to fetch anonymous token: unexpected status from GET request to https://ghcr.io/token?scope=repository%3Ainter-mediator%2Fphp-apache_im%3Apull&service=ghcr.io: 401 Unauthorized
ちなみに、ghcr.io/inter-mediator/php-apache_im:latestが、INTER-Mediatorレポジトリにあるパッケージを参照する識別子である。私のレポジトリに作ったものは、2つ目が「msyk」になっており、そこの部分をINTER-Mediator本体レポジトリに変えたものである。エラーは長いが、ポイントは、最後の「401 Unauthorized」だ。認証されていないのである。
そして、色々なサイトをチェックしてみた。このエラーについての直接的な言及はなかったのだが、あるサイト(情報提供に感謝です!)で、作成されたパッケージは「private」になっているという情報を得た。そうか、アクセス権かと思ったけど、じゃあどこで設定するのかとなる。それに応えるGitHubのページを見つけてなんとか進めることができた。しかし、その操作はかなりトリッキーだと思う。GitHubはいろんな機能があって助かる一方、セットアップはダンジョンでもある。それを記録するのがこのブログの目的だ。
その設定だが、以下のように行う。まず、パッケージは、レポジトリのルートのページで、右下にPackagesとあるので、そこをクリックすると、登録されているパッケージが出てくる。パッケージの項目をクリックするとパッケージの詳細が表示される。このページの右下にPackage settingsというリンクがあるので、それをクリックする。
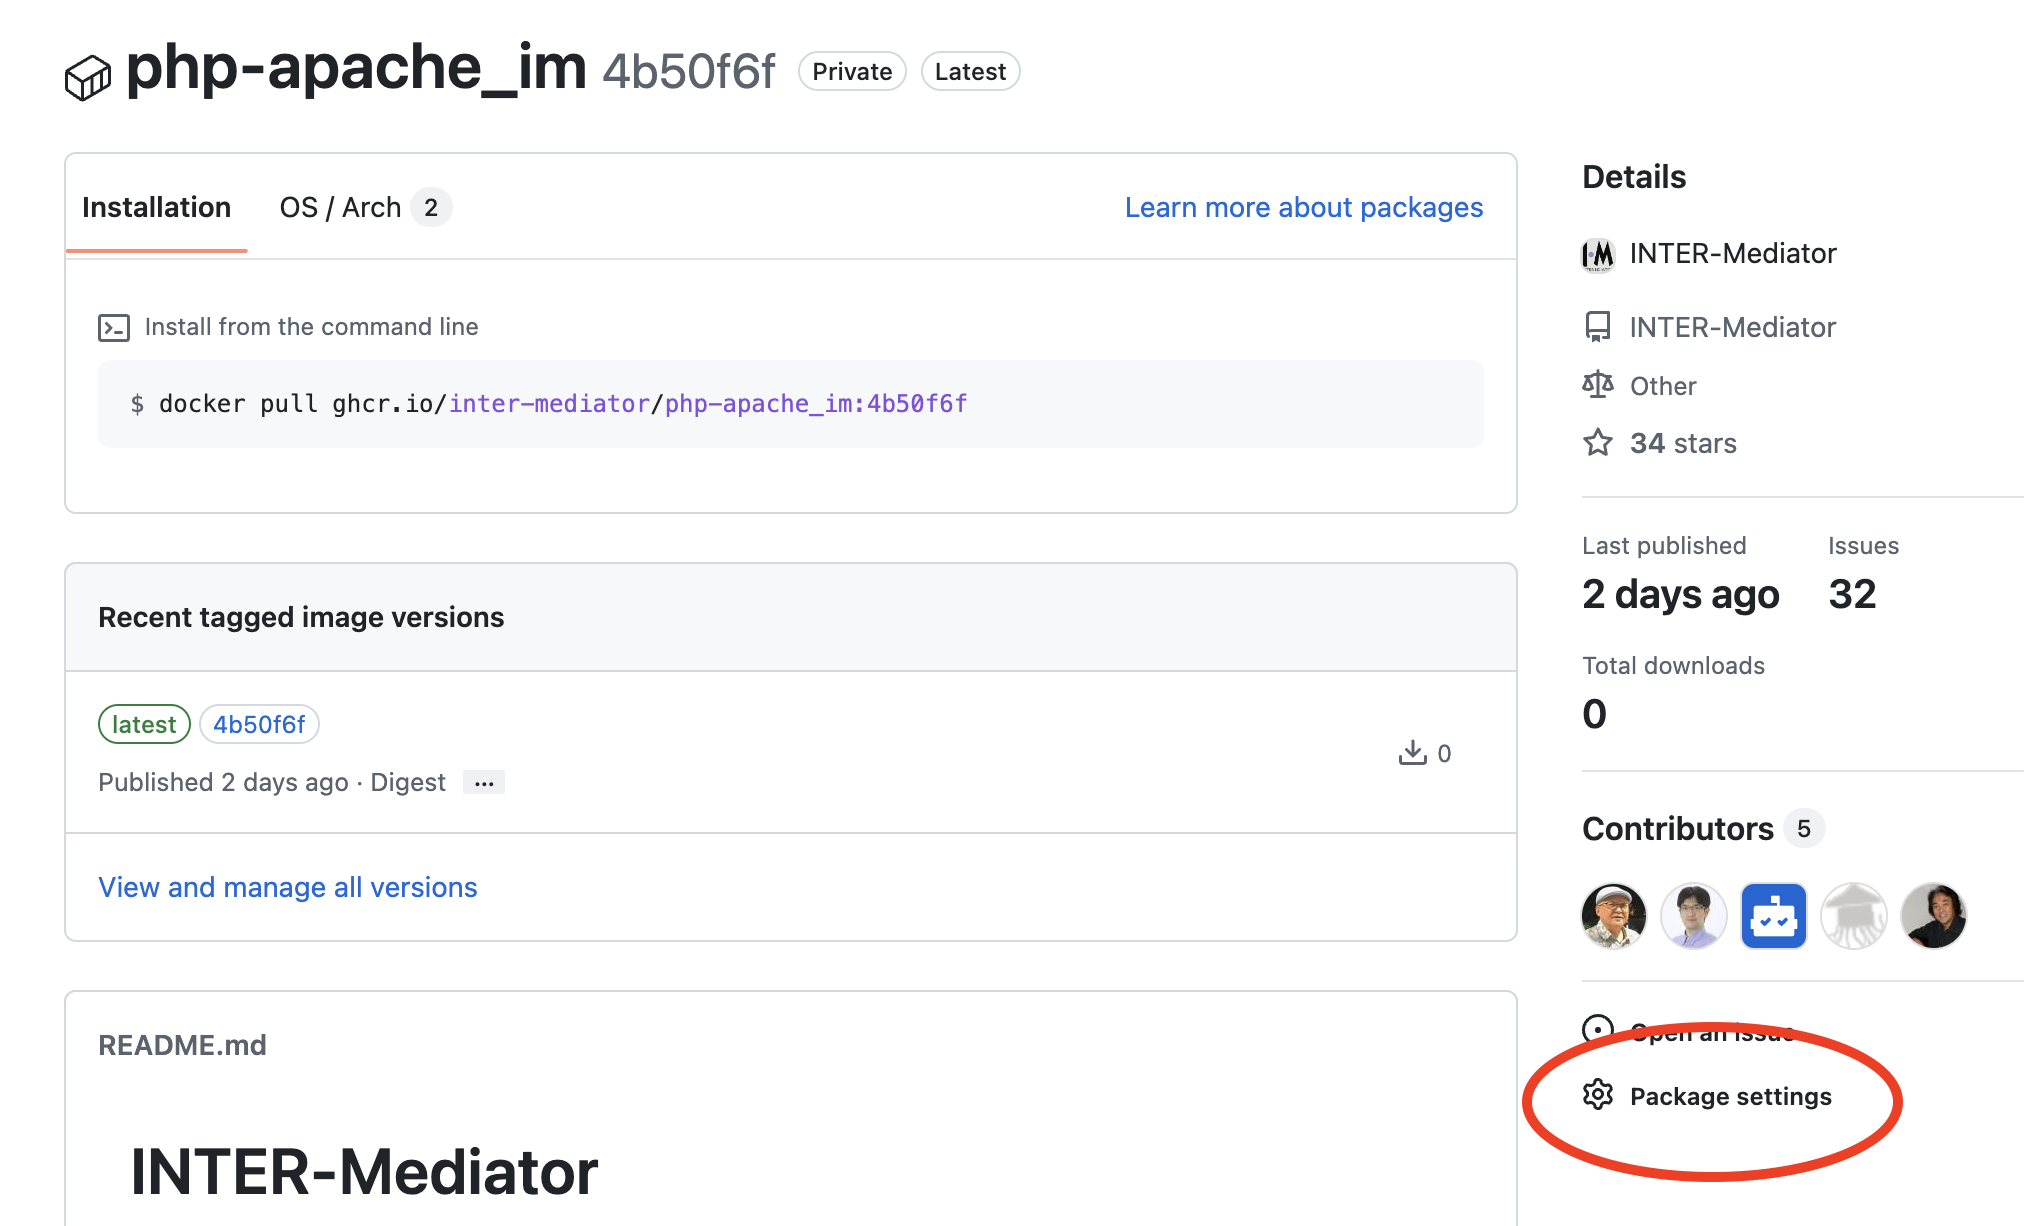
開いたページの下の方に、Danger Zoneとまとめられた項目がある。ここで、Change visibilityをクリックする。

すると、次のようなパネルが開く。ああ、ここかと安心はできない。なんと、Publicは選択できないようになっている。画面に見えているが、組織管理者によってこの設定はできないようになっている。管理者って誰?俺じゃんってことで、自分でやらないといけないわけだ。
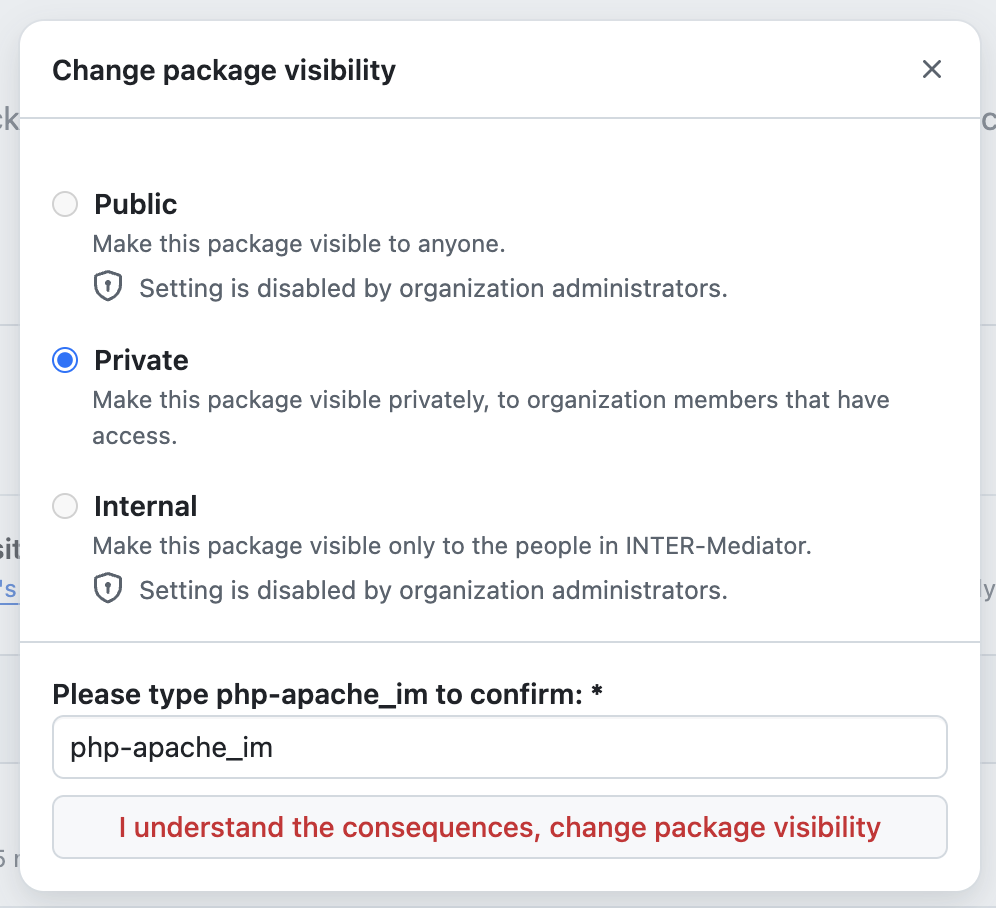
ということで、前に示したGitHubのページに従って作業をする。右上に自分の顔写真が見ている箇所をクリックして、Settingsの項目をクリックし、さらに左側でPackagesを選択する。これで設定できると思いきや、ここには設定はない。
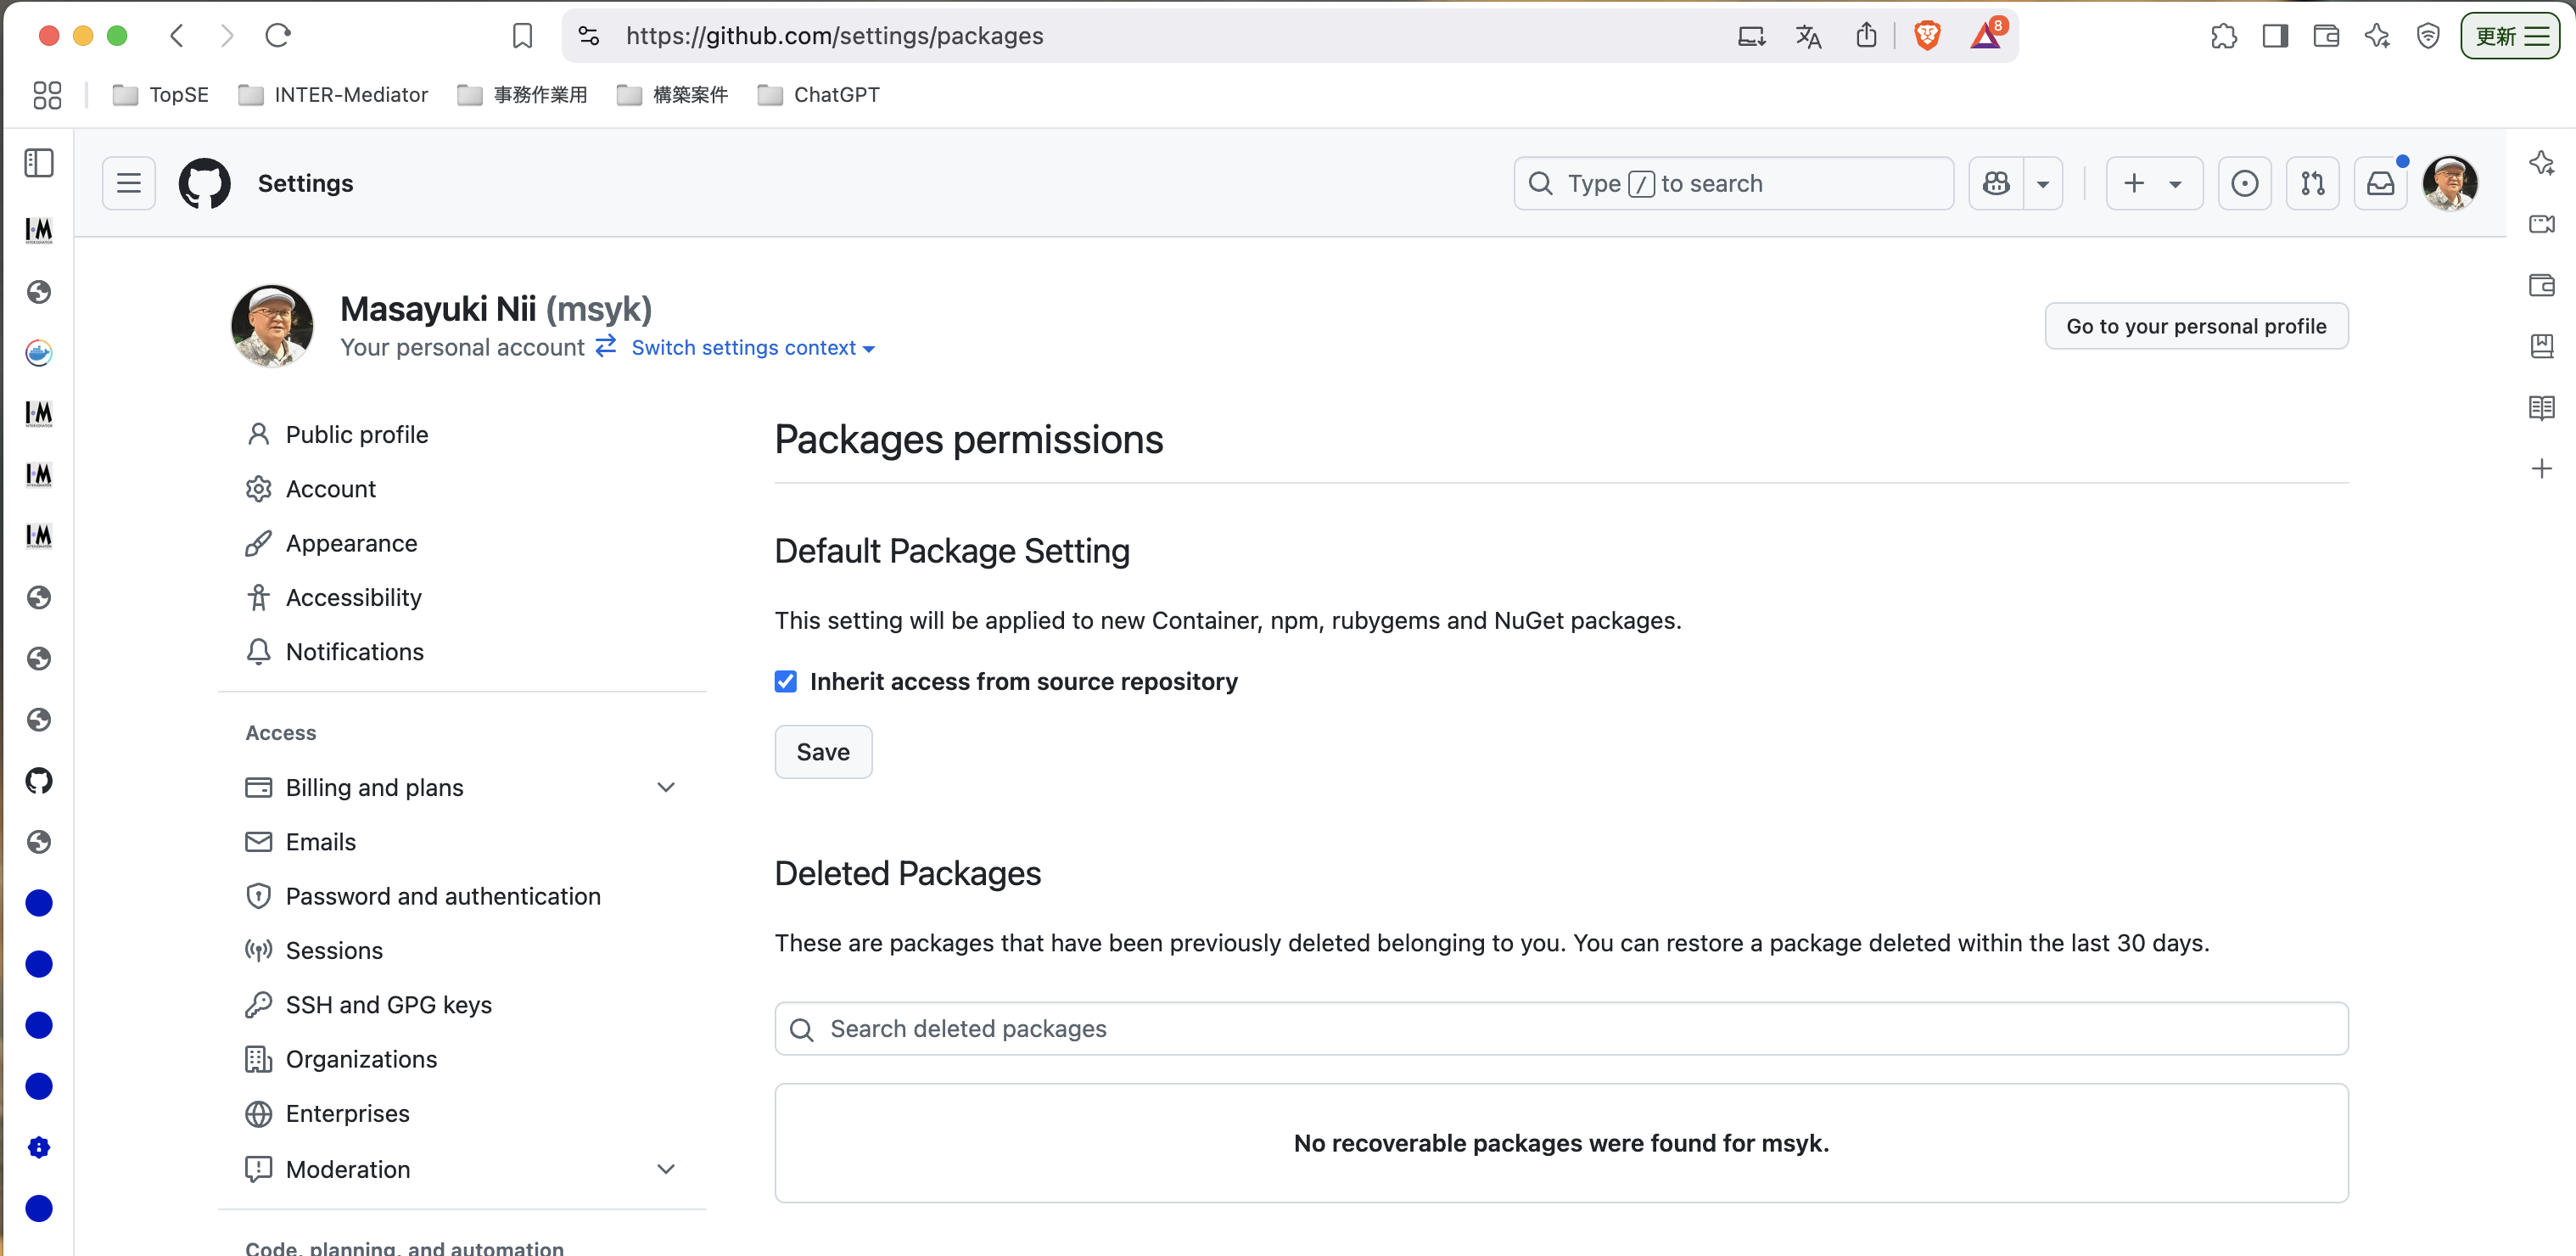
ここで、自分の名前の下あたりにあるSwitch settings contextをクリックして、組織の項目を選択する。つまり、自分の設定ではなく、組織の設定を変更するという操作をしなければならない。
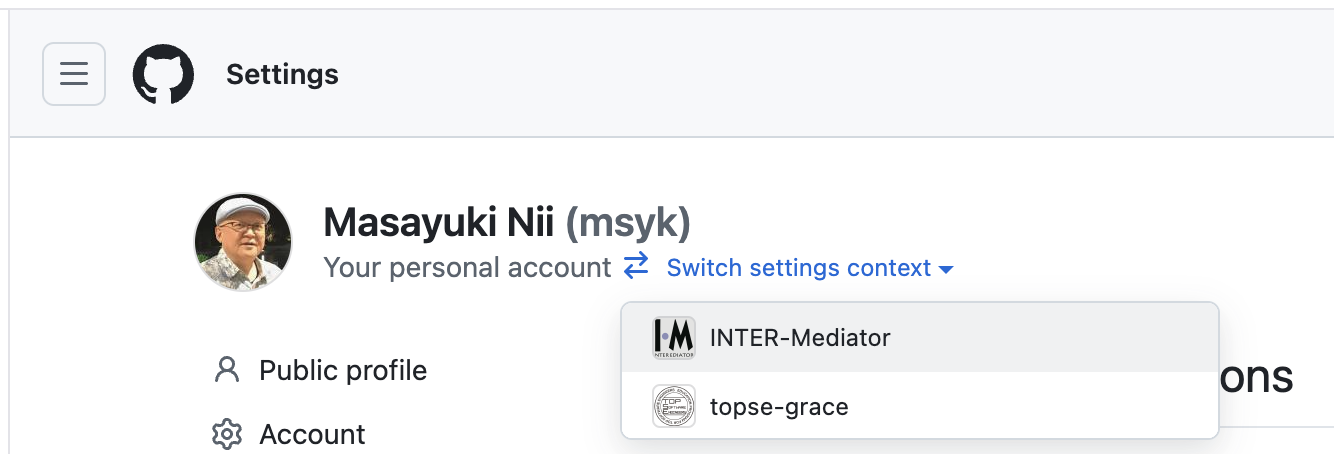
そして左側でPackagesを選択すると、Package creationの下に、Publicなどのチェックが見える。つまり、作ったパッケージの可視性として、PublicやInternalを選択できるようにするチェックボックスがある。ややこしいが、ここでPublicをチェックすると、前に示したDanger ZoneのVisibilityとしてPublicを選択できるようになる。

ちなみに、私のレポジトリに作ったパッケージの可視性の初期値はpublicだった。つまり、個人のレポジトリに作ったものは最初からpublic、組織のレポジトリに作ったものは最初はprivateだが、publicにするには変更が必要だったということである。なんか、細かいところだが、色々考えてのことだとは思うが、なかなかわかりづらいところでもある。
]]>このプログラミングにAIの波は、80年代から90年代の「文字入力ムーブメント」に似た側面があると思います。文字入力ムーブメントの本質の1つはキーボードで、ローマ字で入力するということ、そしてもう1つの本質はかな漢字変換を使うことが大きな特徴です。要するに、文字を書くのではなく、入力するようになったのです。当時も、コンピュータ業界はもう手書きなんてしなくていいということでポジティブに見る反面、そうでない世界の人たちからは「漢字が書けなくなってみんな頭が悪くなる」などとネガティブな意見があったのも事実です。しかし、データ化したテキストは、結果的にコピペや、通信転送による劣化の少なさなど、色々なメリットが具現化され、もはや、多くの日本人が文字をきちんと書けるのかどうかとなるとかなり怪しくなっています。しかし、文字が書けなくても読めて入力できれば、多くの場面で問題なくなってきています。もちろん、文字を書くというトレーニングはどの世代でもある程度やってきているので、全く書けないわけではないでしょうけど、たとえば文章を作る場合、まずは手書きで…なんてことはもうしないという状況です。もっとも、これもAIによっていきなり下書き作らせるようになるほどに進化は止まりません。
ということで、漢字をとっさに書けない私たちでも、日々、文章を書いているということは、そのほかの色々なメリットを含めて悪いことではなかったということです。おそらく、AIによるプログラミングも同じことで、AIをうまく使うというノウハウの蓄積により、過去よりも効率的に開発ができるようになるという路線がすでに先の方まで見えているのが現状でしょう。もちろん、未来にも、いきなり for ( int i = 0 … などと書きじめることはなくはないでしょうけど、むしろ「繰り返して配列の要素の最大値を返して」とお願いして勝手にコードが書かれていたり、あるいはもっと大きな要求を入力して、長ーいプログラムの一部にforが書かれていたりというようなことに、もうすでになっているわけです。つまり、プログラマとしては、スクラッチから書けなくもないものの、fをキータイプすることからスタートするだけがプログラミングではないということになっているわけです。まあ、forの書き方くらいは忘れないかもしれませんが、フレームワークのAPIの引数指定などを正確に書いていかなければならなかった過去に比べて、そういう部分も大まかな指示をもとに正確にAIがコード生成します。それは、あたかも、漢字をちゃんと書けるか怪しい私たちでも文章が作れていくのと良く似ています。
では、AIプログラミングでは何が人間に残るのかとなると、よく言われているのは要求をまとめる作業があります。まあ、そうですね、人間が何か要求しないといけませんし、その要求をソフトウェアとして実現するお膳立ては人間がやることになるでしょう。ここもAIにさせられるだろうと思うかもしれませんが、それは続く話と関わりがあります。要求をまとめる以外に、AIが生成したコードを読み取って評価し、ビルドした結果を評価して使い物になるかどうかを判断し、そして軌道修正を行なって完成に持ち込むといったコーディング自体を読み取って判断し、それを完成品に繋げる能力も人間には必要でしょう。AIがそれらしいプログラムをだだーっと出して、「はい完成OK」というのはあるかもしれませんが、おそらく、世の中はそんなに単純ではないと思われます。文字の入力がキーボードやかな漢字変換で楽ちんになったとは言え、執筆や遂行という作業は効率は良くなったとしても、人間の頭が介在することにより、読むに絶えない文章になるか、素晴らしい文章になるかの分かれ道を突き進むのです。これと同じで、AIが生成したコードをきちんと評価するのは人間の仕事としては必ず残ります。もちろん、それ自体もAIの支援は期待できるのですが、完成品にいたるまでには、必ず人間の判断を的確に入れていくことが必要になるでしょう。そして、コーディング前の要求段階でもその点は同じと考えます。しかし、今はまだ、何をAIにさせて、何を人間がやればいいのかということが、あまりいい感じに言語化できてません。私も、Windsurfでアプリ生成ができるようにプロンプトなんかを開発したりして、見かけ上は、結構、なんでも自動的にできる感じにして、人々に見せるということをやりがちで、さも、問題はありません的な押し出しをしてしまいます。しかしながら、今は人間がやるべきことと、AIにやってもらって問題がないところの線引きが必要な段階になっているのではないでしょうか。
新しいものが出てくると、殊更よさを強調するあまり、行きすぎた結論を出すこともよく見られます。パソコン黎明期の頃は、作曲はDJのソフトのレビューの最後に「これを使えば誰でもミュージシャンになれる」みたいな締めをしていた雑誌も散見されました。ちなみに、流石にワープロのレビューで「これを使えば誰でも作家になれる」とまでは流石に言わなかったのですが、アート系を舐めてはないと思っていました(と言いつつも自分で書いた原稿ではそんなこと書いてないつもりでも、編集部で直されているかもしれないですが)。今は、AIについては、まさに「なんでもできる」的な見方もされていません。もちろん、過去にはできなかったようなことまで手を広げられることも事実ですが、過去に鑑みて、冷静にできることとできないことを見極めて行くことが求められているのではないでしょうか。
そして、今から心配しているのがセキュリティのことです。生成AIを経由することで、簡単にはわからない形で自分のシステムに攻撃が来るのではないかということです。実はもう、すでに攻撃されているかもしれません。生成AIのモデルを信じるのか、あるいは信じないのか、さらに生成AIのモデルを掻い潜ってアタックがやってくるメカニズムが存在するのかしないのか、まだ、全くわかりません。過去、いろんなセキュリティ上の問題が私たちに降りかかってきていますが、それは当初は予測できなかったから問題になっているわけです。生成AIについても、同じような危険があるのではと考えるのは自然ではないでしょうか。だからと言って、具体的にどうするのかということは難しいですが、心の片隅には留めたいことです。
]]>ただし、単に「言うだけ」と言うのは流石に無理です。超マイナーフレームワークのINTER-Mediatorのことは、相対的には少ない情報しかインターネットで得られないものなので、モデルに正確な情報が含められていない感じです。つまり、生で使ってもうまく行かないので、どうにかすると言うことで、INTER-Mediator向けの追加のプロンプトを作ってみました。それは、こちらのサイトでご覧いただけます。このページにある「プロンプト例」の直下にある『住所録のWebアプリケーションをINTER-Mediatorを利用して作成してください。INTER-Mediatorについては以下の情報を参照してください。』が、Windsurfに与えるお題です。これに加えて、それ以下の長いテキストを与えます。要するに、プロンプト例より下のコードを、全部プロンプトとして与えます。上記リンクではMarkdown形式が整形されて見えていますが、実際にはソースのテキストをそのまま使うのが良いでしょう。そして、アプリケーションを作った結果が以下の通りです。
最初にプロンプトとそれに引き続いてINTER-Mediatorに関する追加情報をまとめて与えています。ちなみに、同じアカウントで何度も実行しているので、もしかすると、人によっては同じ結果ではないかもしれませんが、もともと、そこそこ問題なく進めていて、追加情報が必要そうなところでプロンプトを追加したものをまとめたのが長いテキストの部分です。概ね、進められると思います。
そして、SQLのスキーマ作成とその適用、Composerを使ったINTER-Mediatorのインストール、INTER-Mediator特有の追加のインストール作業、そして、lib/params.phpの作成と変数の変更とどんどんと自動で行くと思います。途中でコマンド実行を行うかを尋ねてくれば、ほぼ全部Acceptボタンを押せば大丈夫です。
そして、INTER-Mediatorのマスター/ディテール形式のページを運用できるように、定義ファイルとページファイルを作ります。このあたりは素で作る(つまり、追加プロンプトなしで作る)とかなりぐちゃぐちゃになりますが、何をすべきかをかなり詳細に追加のプロンプトで指定しているので、問題なく作成できます。
全部作成できたら、PHPがセットアップされていることを自動的に認識して、PHPのサーバモードでアプリケーションが動作します。ブラウザで接続すれば、ちゃんと動いている!!最初にレコードが入ってしまっているのは、その前に作った時のSQLiteのファイルがそのまま残ってしまっていて、それを使ったからで、普通はレコードがない状態になります。
と言うことで、まとめると、『住所録のWebアプリケーションをINTER-Mediatorを利用して作成してください。』とお願いすれば、こんなWebアプリケーションを作ってくれると言うところまで時代は進歩したと言うことです。いろんなパターンのプロンプトがあれば、便利そうですね。
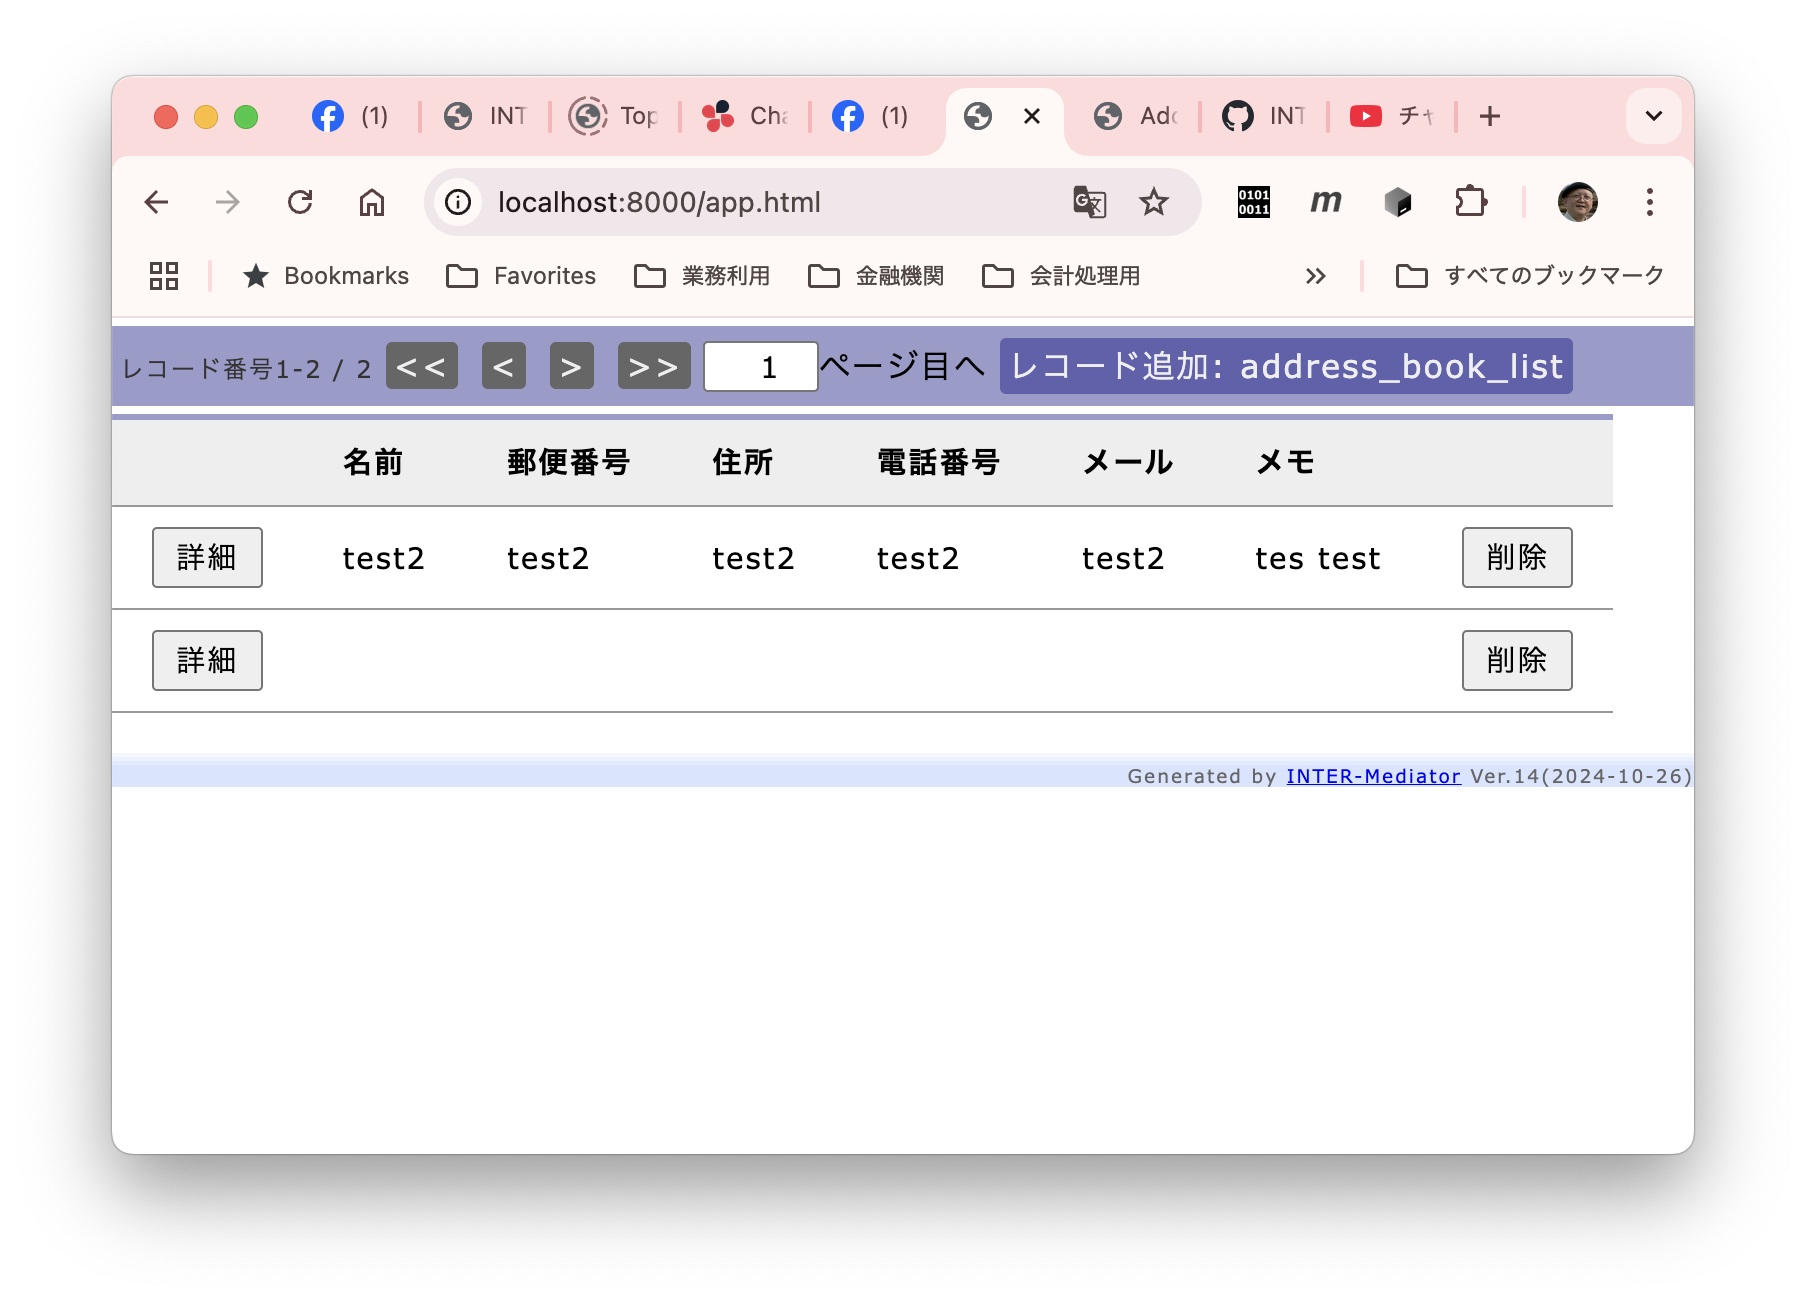
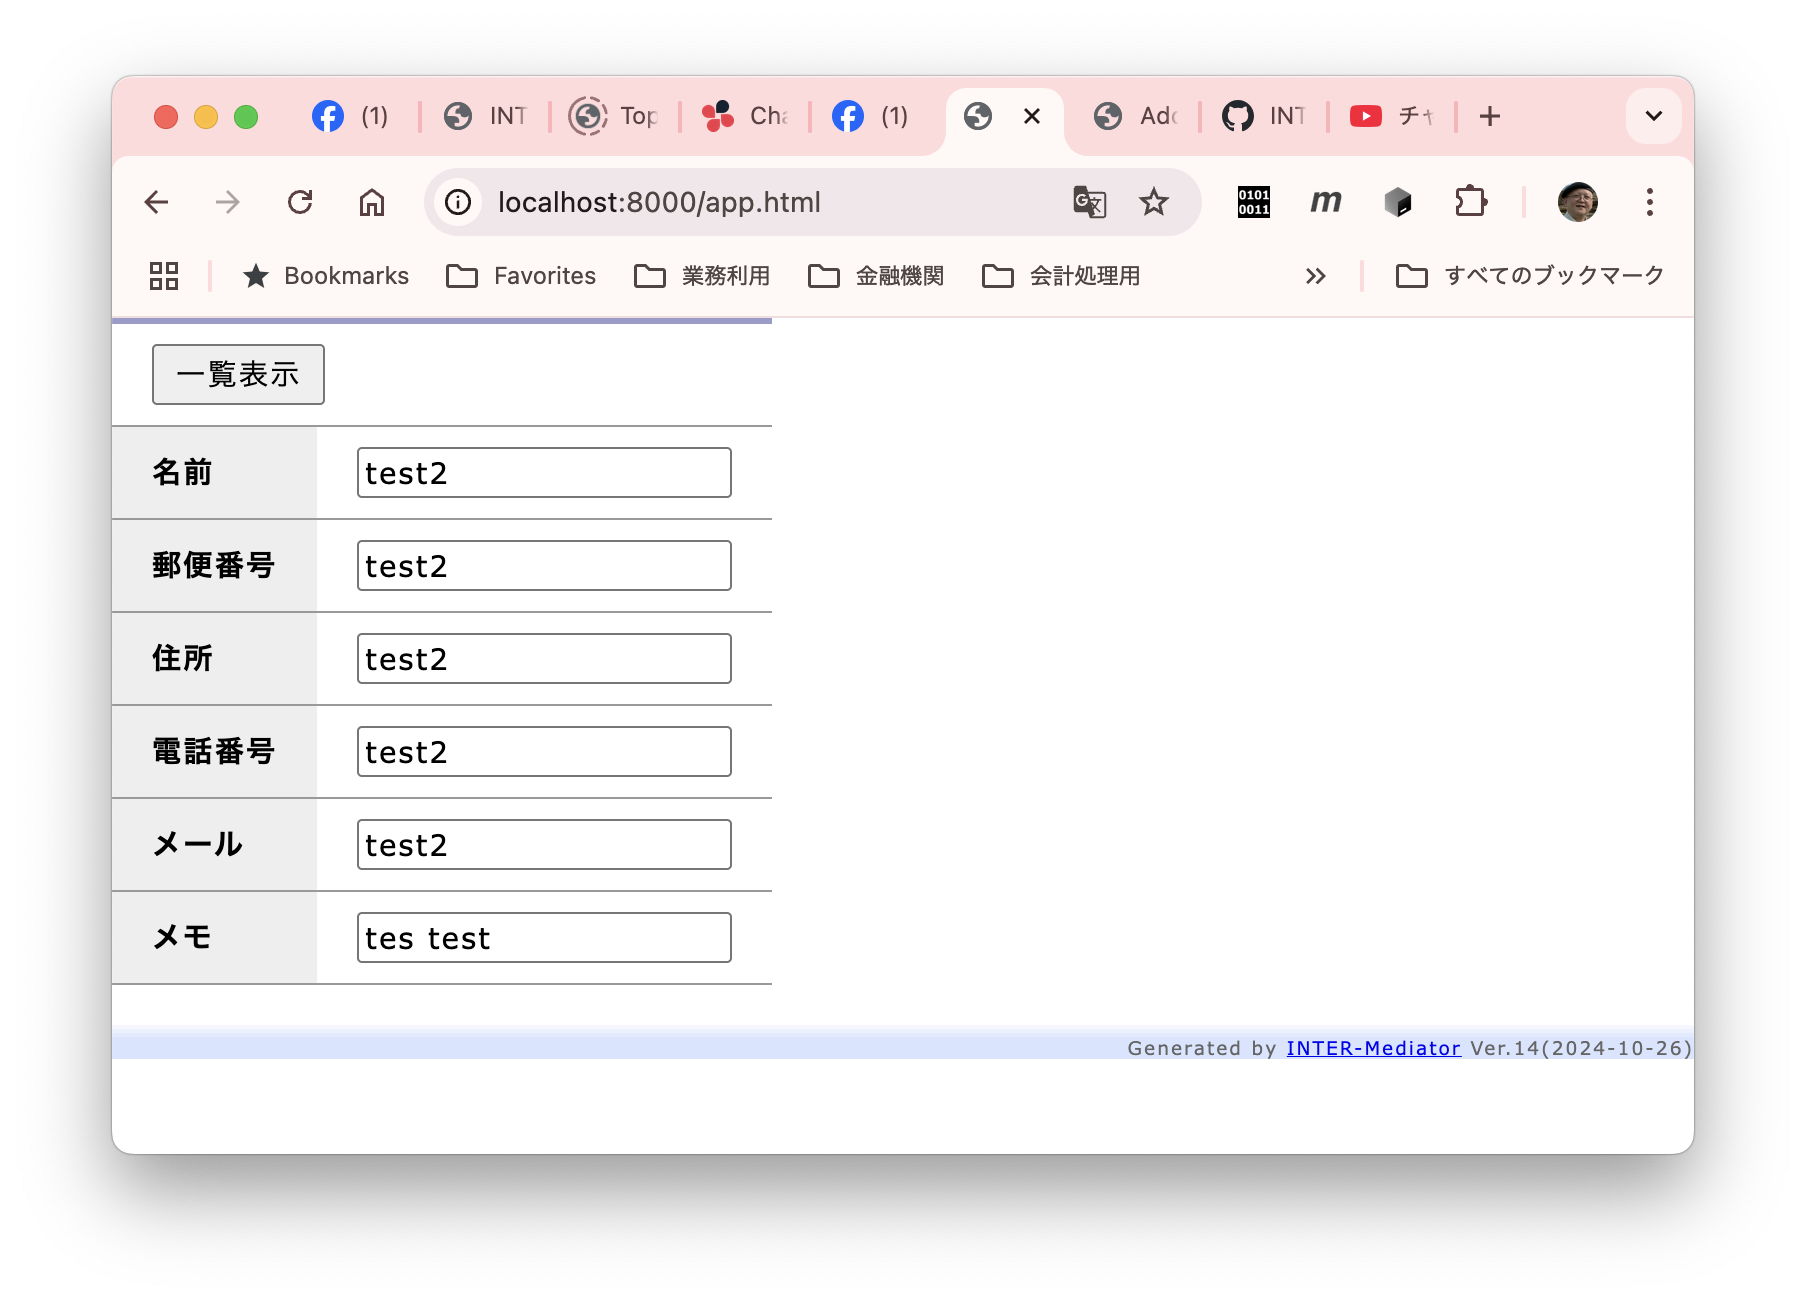
なお、上記は、macOS 15.2で稼働しました。WindsurfはProプランに入っています。LLMは規定値のClaude 3.5 Sonnetをそのまま使っています。GPT 4oを選択できるのですが、こちらだと、コマンド等の自動入力はできず、実際にコマンドを入れたりするのは人間の側になります。
]]>アクセス権セットの [データ入力のみ] の複製を作って、名前を付け替えるなどするのが最初の作業です。「入力のみ」という違和感ある名前はともかく、複製を作り、レコードのポップアップで、「カスタムアクセス権」を選択します。
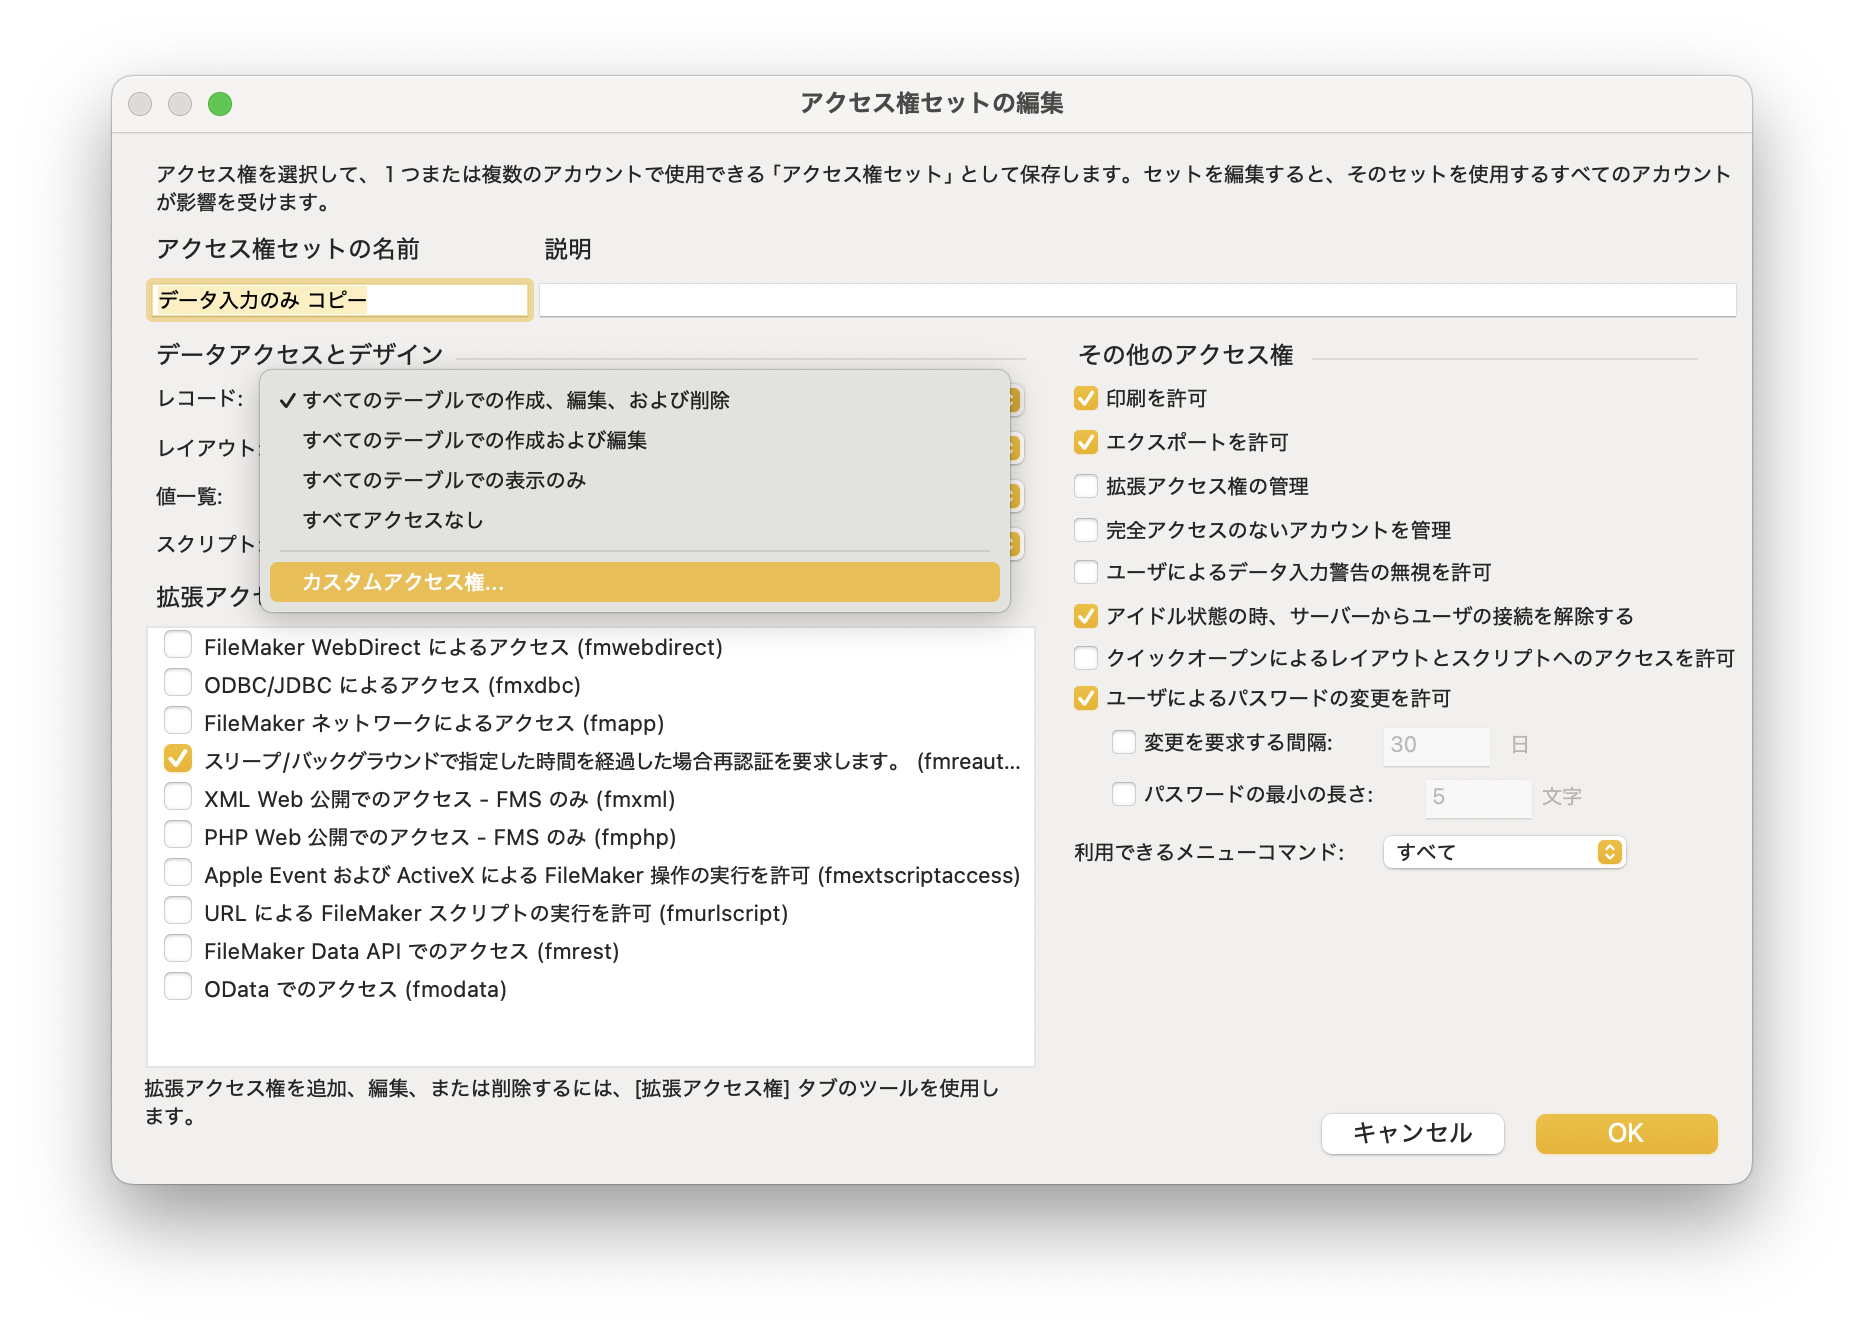
すると、次のようなダイアログボックスが新たに開きます。ここで、該当するテーブルを選択して、リストの下に見えるポップアップメニューから「制限」を選択します。一般に、「表示」の設定を変えるのは必須ですが、「表示」で制限をかければ、編集/作成/削除に対しては何もできないようなので、全部の項目に設定は必要ありません。
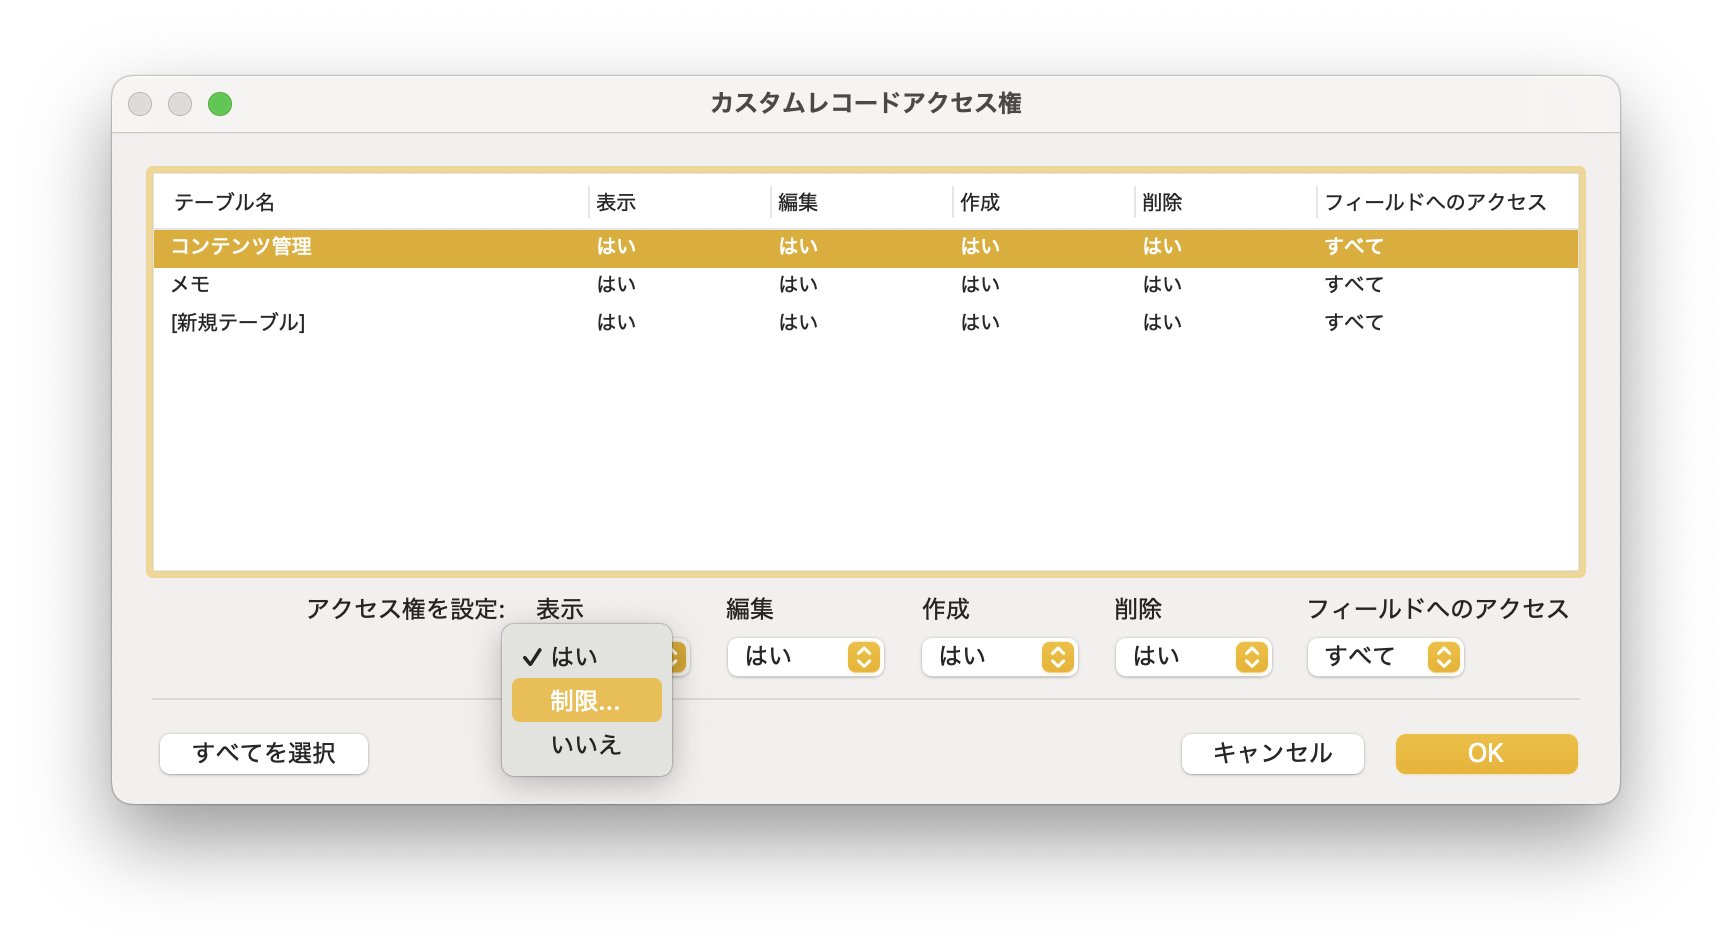
この「制限」を選択すると、式を入力するダイアログボックスが表示されます。そこで、論理式を入力します。論理式がTrueなら表示可能ということで普通にレイアウトにレコードのデータが表示されます。論理式がFalseなら <アクセス権がありません> とフィールドに出ます。こうした表示するかどうかを、レコードごとに決めることができるというのが、カスタムレコードアクセス権の設定で実現します。
ここで対象となるテーブルに、テキスト型でusernameというフィールドを作っているとします。そして、そのフィールドには、レコード新規作成時に自動的に「GET ( アカウント名 ) 」という式の結果を入力します。「ユーザ名」ではなく「アカウント名」で、こちらがログインした認証情報に含まれるユーザ名になります。
そして、カスタムレコードアクセス権の制限の式に「username = GET ( アカウント名 ) 」という式を設定しておけばOKです。この辺り、私たちの書籍「FileMaker as a Relational Database」の「8.3 レコード単位のアクセス権」に記述があります。設定手順がちょっと込み入っとるやないか!と今見たら思ってしまいますが、基本はここで説明したものと同様、アクセス権設定に対するレコード単位のアクセス権指定を行っています。
さて、ここからが本番(長い)。ある案件で、単にユーザ単位でのレコードの分離(レコードごとのアクセス権設定を行なった状態)にするだけでなく、ユーザのグループを定義してグループだと、所属している全てのユーザのレコードが見えるようにするという要件がありました。ここでのグループは、OSのグループとは違って、形態としてはユーザです。要するに権限の高いユーザがグループであり、権限自体に段階があるというか、自分だけと、グループ全体の段階があるという状態です。
これを実現するために、2つの方法を考えました。1つは、ここでのユーザとグループそれぞれ別々のアクセス権セットを割り当てることです。もう1つは1つのアクセス権セットでの「制限」の論理式でうまく処理を組み込むということです。まあ、当然、後者の方が面白そうなので、まずはそちらでやってみました。なお、あるユーザがどのグループに所属するかを記録しないと行けないので、ユーザ管理のテーブルをFileMakerに作る必要があります。{主キー, username, password, is_group, groupname} がテーブル構成です。ユーザ名、グループ名、いずれもテキストで記録するようにします。ここでいちいち主キーでリレーションするのもやり過ぎ感があるので、テキストで十分です。グループは、is_groupがTrueにしておきます。そうすると、ユーザのレコードで所属グループの選択を行うときに、グループだけの(is_groupがTrueのレコードだけの)ポップアップ等が作れるので、このようにしました。このテーブルから、ユーザがどのグループに属するかがわかるという段取りです。passwordはいらんといえばいらんのですが、せっかくこんなテーブルを作るので、いちいち、セキュリティ管理のダイアログボックスを出さなくても、ボタン1つでユーザの作成や削除ができるようなUIを作りました。そのためにはパスワードも入力しておくのが便利です。
そして、大変重要なリレーションシップの設定が必要になります。あるテーブルにusernameフィールドを作って、そこにログインアカウント名を入力しておいて、誰のレコードなのかがわかるようになっているということになるのですが、さらにそのレコードはどのグループの所属なのかをわかるようにしなければなりません。つまり、テーブルから、前者のユーザテーブルのusernameに対してリレーションシップを定義し、ユーザテーブルのgroupnameとして、各レコードの所属グループが得られるようにしておく必要があります。
ここで、アクセス権セットの「制限」の式を構築するとき、要するにログインしているユーザがここでの普通のユーザの場合と、グループユーザの場合では、比較するフィールドが違ってくるということがあります。その処理をやりやすくするために、ログイン直後にユーザテーブルで自分自身のレコードを検索して、is_groupフィールドを見て、自分が通常のユーザなのか、グループユーザなのかを$$変数に置いておき、その変数値を使った計算式を立てれば良いのではと考えました。そして、「制限」の式に$$変数を使ったものを記述したのですが、画面上はなんとなく問題ないように見えるのですが、検索をしても1つもレコードが返ってきません。
なんでか? よく考えてみると、$$変数というか、変数ってコンテキスト依存のものです。つまり、画面に出て来る段階で適用されるようなものと考えて良いでしょう。検索で変数は使えますが、変数の値を求めてそれを条件としてサーバに送っていると考えられます。検索処理そのものは、サーバで行われるとすれば、サーバでレコードを探っている段階では変数の値は全部未確定と考えるべきなので、変数が全部未定義でfalseになるのではと思われます。とは言え、デバッガを動かして検証できる状態ではないので、推測ですが、要するに制限の計算式ではグローバル変数は使えるようでいて使えない場面(この場合は検索時)があるというのが結論のようです。
では、実際にはどうすればいいのか? 1つは、ターゲットテーブルに対してusernameフィールド同士が等しいというリレーションシップを設定したユーザテーブルをtarget_userとすれば、「username = GET(アカウント名) or target_user::groupname = GET(アカウント名)」という式を設定すればいいかと考えました。ですが、あえて、設定がわかりやすいように、アクセス権セットを2つ作り、通常ユーザ用とグループユーザ用として適用し、前述の式のorで区切った前半を前者、後半を後者の「制限」の式に設定しました。ユーザ作成部分はレイアウトをベースにボタンを作って対処してあるので、作り分けることは完全に自動にできます。1つのアクセス権セットにするのもいいのですが、分けておくほうが、後々、いろんな場面に対応できそうな気がして、アクセス権セットを2つに分ける方を選択しました。
ちなみに、「username = GET(アカウント名) or target_user::groupname = GET(アカウント名)」という式で大丈夫だろうと思われるかもしれませんが、ここでのユーザテーブルの整合性が合わない状況の場合、思いがけない結果になります。{is_group, username, groupname}というスキーマに対して{false, user1, boss}{false, user2, boss}{true, boss, boss}という3レコードがあったとします。これを元に、usernameフィールドにuser1、user2あるいはbossという文字列を入れて、ターゲットテーブルに対してどのユーザのレコードかを記録します。bossでログインをした場合は、前述の式のor以降がtrueになることから、user1やuser2が所有しているレコードに対してもbossは参照できます。しかし、ここで、bossがグループユーザではなくて通常のユーザになったとします。is_groupをfalseにしただけだとしたら、user1、user2→bossがグループという情報が残るので、相変わらずbossはuser1やuser2のレコードを参照できます。つまり、user1やuser2のグループを””にするなどの処置が必要となるわけです。計算式にグループユーザかどうかという分岐を入れれば、この問題は回避できると考えて$$変数を使おうとしたのですが、前述の通り、これはうごかない式になってしまいました。複数のアクセス権セットに分離している場合でも同様なことは発生します。その場合、アクセス権セットを別のものに設定し直しが必要になり、これはスクリプトではできない作業になります。同様に通常のユーザをグループユーザに昇格した場合も同様な懸念がありますが、その場合、他のユーザを新たにグループになったユーザに所属させる作業が発生するので、自然に整合性は取れるかと思われます。アクセス権設定が複数ある場合はその所属変更が必要になります。ということで、アカウント作成後は、is_groupの値を変更しないというのがシンプルな解決策になりそうです。いずれにしても、運用間違えるとセキュリティの問題が発生しそうな案件なので、諸々、注意深く実装する必要はありそうです。
]]>