Однако на самом деле, для того чтобы блокировать такие рассылки, совершенно необязательно, чтобы каждый адрес был в списке «плохих». Мы тоже умеем автоматизировать процессы. И в наших почтовых решениях уже некоторое время работает технология, позволяющая выявлять сгенерированные при помощи алгоритмов DGA домены и надежно блокировать всю их партию при помощи единого правила. Хочу чуть подробнее рассказать, как эта технология работает.
Как мы выявляем и блокируем сгенерированные имена доменов оптом
Как только какие-либо наши технологии выносят письму вердикт «спам», его адрес подвергается дополнительной проверке. Если он соответствует ряду критериев, мы добавляем его в базу доменов, которые считаем «плохими». Мы создали каскад классификаторов, который разбирает эти домены по схожести, группирует в кластеры и создает короткое (но емкое) правило, позволяющее блокировать кластер целиком. Соответственно, наши почтовые защитные решения с обновлением получают это правило и с этого момента блокируют все письма, отправленные с адресов на попадающих под него доменах, даже если они еще ни разу не использовались в нежелательных рассылках.
Вот как это выглядит на реальном примере. Среди доменов, попавших в коллекцию «плохих», классификатор выявил несколько похожих:
- sxkjcc.asia
- sxkjcd.asia
- sxkjcy.asia
Для их детектирования достаточно применить единое правило: @sxkjc[a-z0-9]\.asia\b
Как обезопасить компанию от спама
Согласно нашей аналитике, 44,9% писем, отправленных в прошлом году, были спамом. Ненужные и непрошенные письма отвлекают внимание сотрудников компаний, отнимают рабочее время, переполняют почтовые ящики, а в ряде случаев содержат мошеннический, фишинговый или вредоносный контент. Чтобы защитить корпоративных клиентов от этого вороха угроз, в наших решениях для защиты корпоративной почты работают и постоянно совершенствуются технологии борьбы со спамом. В том числе и описанная выше технология для блокирования доменов, сгенерированных при помощи DGA.
]]>На языке PHP написаны архитектуры популярных маркетплейсов, платформ e‑сommerce и систем управления обучением (LMS). Кроме того, PHP используется в различных CMS-системах (WordPress, Drupal, Joomla и так далее), на базе которых работает большинство сайтов в Интернете.
В блогпосте подробно рассказываем о CVE-2026-109618 и CVE-2026-109619, а также объясняем, как компаниям защитить свою инфраструктуру. О том, как развивались события вокруг этих брешей до выхода патча и как решения Лаборатории Касперского детектируют их эксплуатацию, читайте в экспертном блоге Securelist.
Уязвимые версии PHP
Согласно данным на сайте PHP, уязвимостям CVE-2026-109618 и CVE-2026-109619 подвержены версии ниже 8.2.35, 8.3.36, 8.4.27 и 8.5.12. Для более старых веток официальных исправлений нет. По неофициальным данным, уязвимости затрагивают и PHP начиная с 5.4.0.
Чем опасны ошибки CVE-2026-109618 и CVE-2026-109619
Обе уязвимости получили 9,2 балла по шкале CVSS v4.0. Они вызваны тем, что после прерванного запроса (например, из-за нехватки памяти) PHP оставляет в памяти некорректные данные и затем обращается к ним, что позволяет выполнить код на сервере. Одна из подтвержденных цепочек атаки через CVE-2026-109619 использует механизм session.upload_progress (отслеживание прогресса загрузки файлов), который включен в PHP по умолчанию.
Воспользовавшись уязвимостями, злоумышленники могут удаленно и без аутентификации выполнить код на сервере с правами процесса веб-сервера.
По данным разработчиков PHP, под угрозой все установки непропатченных версий, обрабатывающие веб-запросы, включая PHP-FPM, Apache с mod_php, php-cgi, FrankenPHP и LiteSpeed. Наибольший риск у mod_php: для него исследователи продемонстрировали эксплойт, в котором неаутентифицированный запрос запускает атаку еще до выполнения кода приложения.
Что делать бизнесу
Собрали ключевые рекомендации разработчиков PHP и экспертов «Лаборатории Касперского».
- Обновите PHP до версий 8.5.12, 8.4.27, 8.3.36 или 8.2.35. Начните с систем, доступных из Интернета. Исходный код доступен на сайте PHP. Если PHP установлен из пакетов дистрибутива или предоставлен хостингом, проверьте наличие обновленных пакетов: Linux-дистрибутивы и LTS-вендоры получили патчи заранее. Если сервером управляет хостинг-провайдер, попросите его применить обновление.
- Версии 8.1 и старше больше не получают обновлений от проекта PHP. Уточните у вендора дистрибутива или LTS-поддержки, есть ли бэкпортированные исправления, или перейдите на поддерживаемую ветку. Для PHP 7.4, 8.0 и 8.1 разработчики подготовили минимальные бэкпорты исходного кода для самостоятельной сборки. Их также можно найти на сайте PHP.
- Перезапустите PHP-FPM или веб-сервер, чтобы рабочие процессы загрузили новый код, и проверьте версию командой php -v. Если PHP ставился из пакетов дистрибутива, сверьтесь с журналом изменений пакета: номер версии может остаться прежним.
- Проверьте логи с 20 октября. Тревожный признак — процесс веб-сервера выполняет то, чего не должен (запускает командные оболочки, curl, wget и подобное). Своевременно фиксировать вредоносную активность помогают решения «Лаборатории Касперского». Попытки эксплуатации описанных RCE-уязвимостей на Linux и Windows-машинах могут быть обнаружены с помощью Kaspersky Endpoint Detection and Response Expert, а эксплуатация PHP2Shell в сетевом трафике обнаруживается Kaspersky Anti Targeted Attack (KATA) с модулем NDR и Kaspersky NGFW.
Если оперативно обновиться невозможно
Полностью устранить проблему поможет только незамедлительная установка патчей, но если она невозможна, рекомендуется применить временные меры. Разработчики поэтапно прописывают шаги для каждой уязвимости.
Уголок статистики
Из 1414 уязвимостей, закрытых октябрьским пакетом патчей, 1102 затрагивают непосредственно систему Windows, 134 — Microsoft Office, 36 — SharePoint Server, 22 — SQL server и 7 — Exchange Server. Подавляющее большинство — 677 — приводят к повышению привилегий, 317 — к выполнению произвольного кода (RCE), 40 — к обходу функций безопасности, 73 — к отказу в обслуживании (DoS).
Критических уязвимостей в списке 86, из которых 68 приводят к RCE, 14 — к повышению привилегий, три — к спуфингу и одна — к утечке данных. Помимо этого, две уязвимости были разглашены до устранения и одна эксплуатируется в реальных атаках.
CVE-2026-96951 — уязвимость в Windows Shell
Единственная закрытая в октябрьском обновлении уязвимость нулевого дня, которую злоумышленники уже эксплуатируют в реальных атаках, — CVE-2026-96951 в Windows Shell (степень опасности CVSS 8.8). Подробности ее эксплуатации пока не известны, однако, согласно описанию Microsoft, она сводится к инъекции команд, позволяющей обойти функцию безопасности при доступе через сеть. За обнаружение уязвимости Microsoft благодарит экспертов из Fujitsu и Anthropic, то есть, вероятно, найдена она нейросетями.
CVE-2026-108398 и CVE-2026-92707: уязвимости, раскрытые до выхода патчей
Информация о двух уязвимостях попала в общий доступ до выхода октябрьского обновления. В теории это может означать, что злоумышленники могли попытаться начать их эксплуатацию заранее. Это:
- CVE-2026-108398 — дырка в .NET Framework, позволяющая обойти защиту WDAC;
- CVE-2026-92707 — уязвимость в стороннем компоненте для сериализации MessagePack-CSharp, приводящая к отказу в обслуживании (DoS).
Однако, судя по бюллетеням, обе они пока не были замечены в реальных атаках.
На что еще обратить внимание
Несколько уязвимостей, закрытых свежим обновлением, сочетают в себе потенциально серьезные последствия и относительно простую эксплуатацию. Особо пристальное внимание стоит уделить трем дефектам, потенциально приводящим к исполнению произвольного кода:
- CVE-2026-65674 (в SQL Server);
- CVE-2026-70571 (в Exchange Server);
- CVE-2026-70229 (в AD domain services).
Что бы еще пропатчить?
Не только Microsoft публикует регулярные пакеты обновлений для свежевыявленных уязвимостей.
Adobe в октябрьском пакете обновлений устранили 174 дефекта в своих продуктах, среди которых выделяются критические уязвимости (CVSS 10) в ColdFusion и Commerce/Magento. Эти системы обычно доступны из внешней сети, что делает их особенно привлекательными для атакующих.
Октябрьский бюллетень от SAP содержит 20 уязвимостей, включая CVE-2026-89111 — SSRF в Cloud SDK for Python. Уязвимость, потянувшая на CVSS 10, позволяет угнать токены OAuth.
Как оставаться в безопасности?
В последнее время благодаря нейросетям количество выявляемых и закрываемых брешей регулярно бьет рекорды. Для того чтобы не утонуть в потоке выходящих патчей, мы рекомендуем использовать автоматизированную платформу для учета и оценки уязвимостей. Она помогает не только выявлять и устранять уязвимости, но и приоритизировать их с учетом реальных рисков для бизнеса, а также автоматизировать процессы исправления.
В чем суть атаки InjectEave
Процесс преобразования цифровых данных в аналоговую форму, усиление этого сигнала до нужного уровня — все это происходит в электронных компонентах наушников и порождает маломощные электромагнитные помехи. Перехват таких помех и восстановление из них информации — отдельная дисциплина, которой посвящают свои исследования многие эксперты. Вот только в наушниках уровень такого паразитного излучения чрезвычайно низок. Настолько, что перехватить и проанализировать его практически невозможно.
Авторы атаки InjectEave предложили использовать дополнительный излучатель радиосигналов на определенной частоте, направленный на целевое устройство. Те самые слабые помехи от его аналоговых компонентов модулируют сигнал с излучателя. Измененный сигнал перехватывается с расстояния в несколько метров (при наличии чувствительной антенны), а далее атакующий анализирует изменения в нем и восстанавливает изначальный звук.
Технические особенности атаки InjectEave
Главная проблема, затрудняющая перехват электромагнитного излучения «напрямую», — относительно низкая частота сигнала. Например, усилитель звука в наушниках работает на частотах от 20 герц до 20 килогерц, в то время как оптимальные частоты для перехвата электромагнитных помех измеряются в мегагерцах. Исследователи смогли подобрать такую частоту излучаемого радиосигнала, чтобы она также усиливала и интересующий нас сигнал низкой частоты.
Исследователи поставили ряд экспериментов, в ходе которых при помощи антенн для передачи усиливающего сигнала и приема, а также анализатора спектра захватывали и обрабатывали полученные данные. На посвященном атаке мини-сайте авторы выложили исходники перехватов, позволяющие самостоятельно убедиться в эффективности атаки. В большинстве случаев для получения приемлемого результата даже не требовалась какая-то сложная обработка и распознавание — перехваченные переговоры с использованием беспроводных наушников прекрасно различимы, несмотря на повышенный уровень шума.
Всего авторы работы изучили три различных модели беспроводных наушников, а также две модели простых проводных гарнитур. В зависимости от модели менялось эффективное расстояние, с которого было возможно прослушивание (в диапазоне от 1 до 6 метров). Для проводного телефонного аппарата удалось показать двусторонний перехват: получилось прослушать не только звук в динамиках, но и речь потенциальной жертвы, которую захватывали встроенный в гарнитуру микрофон и преобразователь аналогового сигнала в цифровой.
Преимущества и ограничения метода
Любая атака, при которой требуется максимально близко подобраться к объекту шпионажа, сложна по определению. Еще больше усложняет атаку необходимость подбирать частоту усиливающего радиосигнала для каждого конкретного устройства — например, в ходе своих экспериментов ученым пришлось использовать частоты от 1 до 8 мегагерц.
Несмотря на эти оговорки, большим преимуществом данной атаки является работа именно с особенностями аналоговых компонентов электронного устройства. Они издают паразитные помехи по определению, и как-то уменьшить их практически невозможно.
Похожие методы слежки, направленные на перехват цифрового сигнала, можно предотвратить, добавив слой шифрования. Когда речь идет об аналоговой части устройства, каким-то образом защитить полезный сигнал гораздо сложнее. Исследовательская работа еще раз напоминает нам, насколько сложны и непредсказуемы, казалось бы, очень простые и давно знакомые устройства. В некоторых случаях даже максимальная защита данных в цифровом виде оказывается бессильной в тот момент, когда эта информация переводится в аналоговую форму.
]]>В ходе этой кампании атакующие вместо использования ransomware захватили контроль над средой Active Directory и создали вредоносный объект групповой политики (GPO). С его помощью они распространили записку о выкупе, изменили обои и экран блокировки на рабочих станциях и настроили отображение баннера при входе в систему. Разумеется, попутно они отключили учетные записи локального администратора. Это действие не хуже шифрования показало, что злоумышленники захватили инфраструктуру и получили доступ к конфиденциальной информации. Подробные сведения об этом инциденте вместе с индикаторами компрометации можно найти все в том же блоге Securelist. Нам же интересен скорее тренд отказа от шифрования.
Почему шифрование данных более не актуально
Начнем с того, что в крупной компании с тысячами компьютеров, пострадавших от атаки, сам процесс расшифровки данных крайне трудоемок. Поднять данные из бэкапов (которые, во многом благодаря массовым атакам вымогателей, стали распространенной практикой) значительно проще, чем ждать от преступников ключа, надеяться, что он настоящий, а также верить, что в шифровальщике не было ошибок, из-за которых данные восстановить невозможно. Поэтому со временем киберпреступникам все реже удавалось получить выкуп непосредственно за «ключ».
Злоумышленники попытались адаптироваться к новым тенденциям и параллельно с шифрованием стали все чаще красть конфиденциальные данные, чтобы шантажировать жертв их обнародованием. Публикация конфиденциальной информации ставит под угрозу репутацию компании, ее собственную защищенность и безопасность контрагентов. Особенно если в ней содержатся чьи-нибудь персональные данные — более чем в 140 странах мира действуют законы об их защите, и в случае утечки для организации существует довольно высокая вероятность получить весомый штраф. Порой это значительно страшнее, чем просто потеря данных, и никакой бэкап тут, конечно, не поможет.
У эксфильтрации данных есть еще одно преимущество с точки зрения злоумышленников: чаще всего ее гораздо сложнее обнаружить, чем работу зловреда. Так, шифрование файлов сопровождается всплеском дисковой активности, который достаточно быстро фиксируется средствами защиты конечных устройств. Выгрузка информации, напротив, легко маскируется под обычный трафик. Этим активно пользуется группировка ShinyHunters, которая строит свои атаки вокруг штатного OAuth-механизма. Кроме того, на похищение данных у атакующих уходит существенно меньше времени, что также мешает своевременно обнаружить угрозу.
В результате шифрование данных стало своеобразной черной меткой; фактом, подтверждающим, что злоумышленники имели доступ к этим данным. И вот наконец-то злоумышленники решили отказаться от этого необязательного шага совсем.
Что делать бизнесу
Защититься от разнообразных схем вымогательства, как с использованием шифровальщиков, так и без них, можно при помощи соблюдения стандартных правил кибергигиены.
- Продолжайте процесс регулярного и автоматического создания резервных копий. Сохраняя их на двух видах носителей, физическом и облачном, бизнес может не опасаться серьезного нарушения процессов: все же простой, необходимый для восстановления бэкапов, не сравнится с последствиями полной потери данных.
- Своевременно устанавливайте патчи и обновления. Уязвимости остаются одной из основных точек входа злоумышленников в инфраструктуру. Чтобы снизить риски, мы рекомендуем внедрять автоматизированное управление обновлениями операционных систем, ПО и драйверов. Важно также регулярно сканировать системы на наличие брешей и приоритизировать их, уделяя особое внимание критическим ошибкам. В этом могут помочь специализированные решения для управления уязвимостями.
- Укрепляйте защиту конечных устройств. Настройте многофакторную аутентификацию для всех систем в инфраструктуре, а также внедрите надежное решение для защиты рабочих мест и серверов. Обеспечить полную видимость событий и оперативное реагирование на инциденты поможет SIEM-система или решение класса EDR.
- Контролируйте внешний периметр. Регулярно проверяйте инфраструктуру компании (серверы, базы данных, «облака», устаревшие поддомены) на предмет открытых портов и сервисов, доступных из Интернета.
- Придерживайтесь принципа минимальных привилегий. Он предполагает, что пользователям, системам и процессам предоставляются только те права доступа, которые необходимы для выполнения их рабочих функций. Следует отзывать неиспользуемые привилегии, а также полностью отключать доступы для бывших сотрудников.
- Инвестируйте в обучение персонала. Злоумышленники по-прежнему эксплуатируют человеческий фактор, чтобы проникнуть в инфраструктуру компании. Повышение осведомленности пользователей об угрозах поможет им не стать жертвами фишинга.
В Elastic подсчитали, что в зависимости от архитектуры «агентского SOC» обработка (triage) одного оповещения с хоста может обходиться в $0,69 для ансамбля узкоспециализированных агентов или в $3,42 для агента-универсала с 14 разными навыками.
При этом за средними значениями кроется огромный разброс. В любой момент базовая обработка простого оповещения (условно 1000 токенов) может превратиться в каскадное расследование миллионов строк журналов, вызовов API и других связанных данных (а это миллионы токенов за считаные минуты).
В той же Elastic признают, что используют в SOC модель Sonnet 4.6. Это немедленно вызывает вопрос: а что произойдет при исчерпании бюджета или срабатывании в модели фильтров безопасности? В худшем случае произойдет следующее: AI SOC запускает «оркестр агентов» для расследования подозрительных событий, похожих на перемещение по сети. Агент обращается в API Anthropic, но месячный бюджет департамента исчерпан, и API возвращает ошибки. Расследование останавливается на полпути, люди узнают об этом полдня спустя. Причем, если постоянно меняющиеся «фильтры безопасности» большого ИИ-провайдера примут запросы от SOC как вредоносные, тот же эффект возможен и без исчерпания бюджета, как показал опыт Hugging Face при расследовании взлома их инфраструктуры со стороны OpenAI.
И, разумеется, злоумышленник заинтересован в таком исходе. Он может напрямую влиять на расходы защитников, модифицируя доступные ему данные (TXT-записи DNS, заголовки HTTP, комментарии в коде, имена файлов и так далее) и внедряя в них вредоносные промпты в расчете на то, что они будут обработаны ИБ-системами. В кейсе GhostJacking вектором для промпт-инъекции становятся журналы WAF, а в еще одной работе исследователям удалось атаковать сами фильтры безопасности LLM (guardrails), провоцируя своими запросами увеличение задержки (latency) в 148 раз, а количество потребленных токенов в 63 раза. То есть по идее система продолжает работать правильно, но при этом значительно вырастают задержка в обработке оповещений и расходы.
Опасный тихий отказ
Далеко не всегда исчерпание бюджета в агентских сценариях проявляется как явная ошибка с сообщением «лимит запросов исчерпан» и немедленным оповещением ответственных. При определенной конфигурации могут возникнуть «партизанские» сценарии: запрос к модели не проходит по тайм-ауту, система автоматически переключается на более дешевую модель, в результате качество ее выводов падает, перестают запускаться субагенты и периодические задачи. А ИБ-команда еще долгие часы может считать, что все работает как раньше.
Как контролировать ИИ-расходы в ИБ
Задача управления расходами, конечно, не сводится к «не допускать перерасходов». Отрасль уже проходила эту ловушку при внедрении SIEM: когда пришлось платить за объем собираемой телеметрии, компании стали выборочно, и не всегда эффективно, ограничивать сбор журналов. В результате они получили слепые зоны детектирования. С токенами возможна та же ситуация, но быстрее и в большем масштабе. От неудачной политики сокращения расходов могут пострадать глубина расследования и качество реагирования. А при отсутствии такой политики решение что-то урезать будет принимать не архитектор и не CISO на этапе проектирования системы, а дежурный аналитик в три часа ночи. Либо же вообще автоматический ограничитель, установленный производителем системы.
Несколько простых принципов позволяют избежать предсказуемых перерасходов и лучше контролировать те ситуации, которые действительно непредсказуемы.
Не отдавайте ИИ-модели то, что можно проверить обычным запросом. Все однотипное и заранее известное нужно по старинке закрывать правилами и запросами к данным. Их можно разрабатывать с помощью ИИ, но работать они должны детерминировано. Модель следует подключать только там, где действительно нужна оценка неоднозначной ситуации.
Используйте строгие лимиты и агрессивно оповещайте об их превышении. Лимиты должны комбинироваться: предел на одну задачу, предел на сутки и так далее. Оповещение о превышении лимитов должно немедленно доходить как до дежурных специалистов, так и до ответственных за систему в целом.
Заранее решите, что происходит при достижении лимита. Остановиться и сэкономить, потеряв часть контроля, или продолжить и заплатить — выбрать нужно до инцидента.
Ограничьте права и набор инструментов у агентов. Чем меньше действий доступно системе, тем эффективнее она работает над узкой задачей, тем меньше у нее возможностей раздуть расходы, тем меньше ее может «раскрутить» посторонний.
Строго сканируйте внешние, недоверенные данные. Приходящие извне заявки, обращения, сообщения и комментарии, а также различные технические поля, способные нести произвольный текст (DNS-записи, HTTP-заголовки, имена файлов) могут не только приводить к промпт-инъекциям, но и целенаправленно раздувать объем работы. Ограничивайте их размер и следите за нагрузкой, которую они создают.
Чтобы не сталкиваться с отказами внешних поставщиков и сохранить полный контроль над данными организации, оцените возможность применения в ИБ локальных моделей, запущенные on-premise. Они не относятся к передовым, но узкая специализация и дообучение на данных компании дадут достойную эффективность без неожиданных отказов.
В более сложной архитектуре использование LLM можно разделить на несколько уровней. Первую линию (маршрутизация, отсев шума, обогащение) берут на себя локальные компактные модели. Это значительно снижает волатильность бюджета. Второй уровень — большая локальная модель, которой достается содержательная работа: связать события, проверить гипотезу, собрать картину инцидента. Она тоже не тарифицируется по запросам, но ее пропускная способность конечна, поэтому вместо перерасхода бюджета возможны перегрузки и появление очереди событий. И только отдельные, действительно трудные случаи уходят в передовые облачные модели, желательно с явного одобрения живого аналитика. В такой схеме переменные расходы остаются, но они ограничены небольшим числом случаев, и каждый из них — осознанный выбор, а не побочный эффект работающего по ночам сценария.
По сути, все это — воспроизведение классической многоуровневой модели SOC, где первая линия фильтрует, а третья разбирается, только роли исполняют не люди, а модели. Вместе со структурой наследуется и ее известная болезнь: самая «дешевая» линия поспешно закрывает то, что должна была передать дальше.
]]>Кажется, что решить проблему с брешами очень легко. Нужно поставить сканер, почаще проверять инфраструктуру и обновлять уязвимые системы. Но статистика сервиса Kaspersky Incident Response свидетельствует об обратном: каждая третья кибератака в России в этом году начиналась именно с эксплуатации ошибки, причем речь часто идет об известных дефектах, а не об уязвимостях нулевого дня.
Дело в том, что наличие сканера вовсе не говорит о качественном управлении уязвимостями. Продукт только находит ошибки (причем не всегда оперативно), после чего на плечи команды ложатся задачи по их приоритизации и устранению. Эти процессы могут тянуться неделями, а тем временем в инфраструктуру легко может попасть злоумышленник.
Где теряется время
Первое промедление может произойти сразу после появления информации об уязвимости в базах данных. Помимо контроля брешей, служба ИБ занимается десятком других задач, поэтому мониторинг информации полностью доверяет сканеру. Если он настроен на еженедельный запуск, новая уязвимость попадет в отчет примерно через несколько дней. В компании, где сканирование проводится раз в квартал, это происходит сильно позже. Злоумышленники же целенаправленно следят за лентой публикаций и сразу узнают о новых брешах.
Когда в руки специалистов попадает отчет, в нем оказывается далеко не одна ошибка, поэтому встает вопрос, с чего начать. Критические уязвимости проходят вне очереди, но злоумышленники могут воспользоваться не только ими. Между тем решения по приоритизации редко принимаются на основе данных: чаще за основу берется порядок ошибок в отчете, название уязвимой системы (какая на слуху, с той и начинают) или повышенная активность ее владельца. Из-за этого риск пропустить серьезную угрозу очень велик. Наконец ИТ-департамент берет уязвимость в работу, и… она вновь попадает в очередь: нужно проверить совместимость обновления, дождаться окна обслуживания.
Установив обновление, специалисты с легким сердцем закрывают тикет и ставят статус «выполнено». Но проверит ли кто-нибудь, что патч встал на все затронутые машины? Даже на ту, которая в момент установки была выключена? Вероятно, нет, и тогда компания будет думать, что уязвимость закрыта, хотя фактически она останется в инфраструктуре еще на неопределенный срок. Это худший из возможных исходов: риск остался, но перестал быть виден.
Сложите все вместе, и получится, что от публикации до реального закрытия проходят месяцы. Обвинить тут особо некого: каждый участник цепочки сделал то, что должен был. Просто сама эта цепочка собрана из звеньев, между которыми есть пробелы.
Рецепт управления уязвимостями
Чтобы у злоумышленников было как можно меньше поводов заглянуть к вам в инфраструктуру, важно убедиться, что в организации четко выстроены четыре основных процесса.
Инвентаризация
Невозможно проверить безопасность системы, о существовании которой никто не знает. Вместе с тем практически в любой крупной инфраструктуре найдется сервер, поднятый «на неделю» три года назад, сетевое устройство, оставшееся от предыдущих владельцев бизнеса, или рабочая станция, которую забыли при переезде офиса. Все эти активы могут представлять серьезную угрозу.
Задача инвентаризации — обеспечить полную прозрачность ИТ-инфраструктуры. Для этого составляется актуальный список активов.
Приоритизация
При анализе уязвимости не стоит ориентироваться только на оценку из публичного каталога, например NVD, — она может существенно расходиться с реальным ущербом от эксплуатации бреши. Значительное влияние будет оказывать то, как устроена инфраструктура конкретной организации. Например, один и тот же дефект в сервере, который находится в изолированном сегменте, и в системе, доступной из Интернета, — это два очень разных риска.
Полезная приоритизация учитывает не только публичный уровень опасности, но и роль уязвимого актива в инфраструктуре, вероятность эксплуатации и реальные тренды атак. Ориентироваться можно на различные отраслевые отчеты, например, в этом году команда Kaspersky Security Services подготовила подробное исследование первоначальных векторов атак с примерами реальных инцидентов.
Настройка конфигураций
Слишком мягкие настройки доступа, отключенные механизмы защиты и оставленные учетные записи по умолчанию формально не являются уязвимостями, но именно они часто становятся точкой входа. Чтобы злоумышленник не смог воспользоваться недостаточной настройкой конфигураций, следует соблюдать несколько правил базовой гигиены:
- удалять учетные записи по умолчанию;
- использовать сложные пароли и MFA;
- отключать неиспользуемые сервисы;
- применять принцип минимальных привилегий.
Подтверждение
На этом этапе слепые пятна встречаются особенно часто. Как правило, после того как ИТ-департамент формально устанавливает обновление, уязвимость считается закрытой. Однако прежде чем окончательно выдохнуть, важно как минимум проверить, что патч успешно применился на всех затронутых системах и действительно устранил уязвимость.
Пять задач — одно решение
Наше новое решение Kaspersky Vulnerability Management помогает специалистам по ИБ наладить централизованное управление уязвимостями, активами и ошибками конфигурации. Продукт решает пять ключевых задач.
- Сокращает время между публикацией данных об уязвимости и ее обнаружением на активах. Продукт автоматически проводит инвентаризацию инфраструктуры, отслеживая даже давно забытые всеми активы, и непрерывно сканирует ее в поисках уязвимостей. Проверка выполняется двумя способами: агентным и безагентным. В первом случае решение работает поверх Kaspersky Endpoint Security, что позволяет проводить глубокий анализ рабочих станций и серверов без передачи сервисных учетных данных по сети. Во втором — анализирует порты и сервисы там, где агента нет. Оба способа дополняют друг друга, позволяя полностью покрыть инфраструктуру компании.
- Проверяет конфигурации. Соблюдение стандартов безопасности проверяется по готовым профилям, включая профили ФСТЭК.
- Приоритизирует уязвимости. Приоритеты выставляются с учетом уровня опасности, особенностей конкретного актива, вероятности эксплуатации и других параметров.
- Оперативно исправляет ошибки. Здесь работают рекомендации по устранению и централизованный патч-менеджмент, встроенный в привычную инфраструктуру администрирования.
- Помогает удостовериться, что брешь закрыта полностью. Задача по устранению дефекта признается завершенной только после повторной проверки.
Kaspersky Vulnerability Management помогает превратить управление уязвимостями из набора разрозненных действий в продуманный цикл. Подробности о возможностях и лицензировании можно найти на странице решения.
]]>Версии WordPress, затронутые уязвимостью CVE-2026-87902
По данным, опубликованным WordPress на GitHub, уязвимости подвержены все версии CMS, начиная с 4.7.0 и заканчивая 7.1.1. Компания выпустила обновления для всех поддерживаемых веток системы. Полную таблицу, в которой перечислены номера пропатченных версий, можно найти там же, на GitHub-страничке компании. Самый свежий WordPress следует обновлять до версии 7.1.2 (или более новой).
В чем суть уязвимости CVE-2026-87902 и почему она столь опасна?
В нормальной ситуации WordPress подключает PHP-файлы шаблонов только из специальной папки используемой темы. Однако из-за уязвимости CVE-2026-87902 атакующий может составить запрос к WordPress таким образом, что будет подключен произвольный PHP-файл. Причем без необходимости какой-либо авторизации. Да, для этого файл уже должен быть каким-то образом загружен на атакуемый сервер, но для атакующего это не такая уж проблема.
Звучит как уязвимость обхода пути (path traversal vulnerability), однако в большинстве публикаций уязвимость CVE-2026-87902 относят к классу RCE, потому что при определенной конфигурации сервера WordPress и PHP атака может привести к запуску произвольного кода.
Как оставаться в безопасности?
Единственный способ обезопасить свой WordPress-сайт — установить обновленную версию. Обнаруживший уязвимость исследователь также предлагает несколько советов по усилению безопасности системы, но подчеркивает, что они дополняют патч, а не заменяют его.
Новостной сайт The Hacker News приводит несколько имен PHP-файлов и IP-адресов, используемых в атаке через CVE-2026-87902. Они могут служить индикаторами компрометации системы.
В условиях, когда между публикацией данных о существовании уязвимости и началом атак с ее применением проходит всего несколько часов, важно, чтобы в компании было грамотно настроенное централизованное управление уязвимостями. Для этого следует использовать специализированное решение, способное выявлять и устранять уязвимости, приоритизировать их с учетом реальных рисков и автоматизировать процессы исправления.
]]>Кроме того, для злоумышленника, атакующего организацию, любой процесс, автоматизированный с помощью ИИ и доступный для внешнего воздействия, по сути является удобной мишенью для «нового DDoS». Дело в том, что отчеты об ошибках в приложении, обзоры товара или обращения в техподдержку, как и любые другие внешние данные, которые компания обрабатывает через ИИ, могут послужить инструментом в атаке, направленной на повышенный расход токенов (фрагментов слова, являющихся базовой единицей ввода и вывода в LLM).
Год взрывного роста… счетов
В 2026 году крупные компании впервые столкнулись со значительным перерасходом бюджетов, отведенных на ИИ-системы. В Uber потратили весь годовой бюджет к апрелю, в неназванной компании забыли установить лимиты на Claude и потратили 500 млн долларов за один месяц. Хотя поставщики ИИ регулярно рапортуют о снижении цен и повышении эффективности моделей, переход от чатботов к агентским системам, работающим постоянно и автономно, повышает траты токенов в сотни и тысячи раз. При этом модель «фиксированная подписка за 20 или 100 долларов» для компаний уходит в прошлое, все крупные поставщики переводят бизнес-клиентов на оплату по фактическим расходам.
В результате компании сталкиваются с проблемой, хорошо знакомой по таким услугам, как облачные серверы и сотовая связь. В отсутствие специализированных систем учета и управления стоимостью организация узнает, сколько будет стоить тот или иной процесс или проект, только после его завершения. В телекоме и у облачных провайдеров подобная проблема в конце концов была решена благодаря разработке изощренных систем биллинга, а у их клиентов в обиход вошел даже специальный термин FinOps. Для ИИ этот процесс пока находится в зачаточном состоянии. Более того, решение проблемы будет осложнено вероятностной природой ИИ-генерации.
Непредсказуемый расход токенов
Чтобы понять, почему расходы так быстро растут и так слабо предсказуемы, нужно вспомнить, как работает языковая модель и что превращает ее в ИИ-агента. Модель не сохраняет состояния (stateless), иными словами, она не помнит ничего между обращениями. Каждый раз, когда агент делает следующий шаг, в модель приходится заново отправлять всю историю работы по конкретной задаче (контекст): исходное задание, предыдущие рассуждения, содержимое прочитанных файлов, ответы всех инструментов. С каждым шагом этот «пересказ» становится длиннее, особенно если в задаче нужны циклические повторы. Если шаг не удался, ответ оказался непонятным или инструмент выдал ошибку, агент просто пробует еще раз, дополнительно раздувая размеры контекста. А если задачу выполняет не один агент, а несколько, которые делят работу между собой и обмениваются результатами, то этот объем умножается на их количество. В итоге расход токенов растет не постепенно, а рывками, и предсказать его на старте задачи почти невозможно.
Запуская две разные сессии в ИИ-агенте для решения ровно одной и той же задачи (два тикета техподдержки, две задачи аналитики и так далее), можно потратить на них разное количество токенов, которое может различаться в 30 (!) раз. Это зависит от того, сколько шагов, ошибок и повторов понадобится для решения. Повышенный расход не обязательно зависит от сложности задачи. Хорошо известны случаи, когда ИИ зависал «в петле размышлений» и тратил несуразно много ресурсов на тривиальные задачи.
Три поколения ИИ в корпоративных системах (включая ИБ-системы) потребляют деньги совершенно по-разному:
- классическое машинное обучение (ML). Обычно работает с хорошо структурированными данными и не слишком требовательно к вычислениям. Расход предсказуем и невелик. Это фиксированная статья бюджета;
- чатбот или иной ИИ-ассистент на базе LLM. Тратит токены, но темп задает человек: сотрудник запустил задачу вручную, затем оценил результат, взял паузу. Расход растет примерно пропорционально числу активных пользователей, его можно грубо оценить по количеству лицензий;
- автономный ИИ-агент. Человек ставит цель и отключается, а дальше система сама решает, что делать и сколько шагов нужно выполнить. Счетчик крутится до тех пор, пока задача не будет сочтена выполненной, и предсказуемого «потолка» у расходов нет.
«Токеномика» в атаках: Denial of Wallet как новый DDoS
Поскольку обращения к LLM значительно дороже обычных вызовов стандартного ПО, автоматизированное выполнение повседневных корпоративных задач имеет непривычно высокую цену. Так, в Gartner оценивают разрешение одного запроса клиента к службе поддержки пользователей при помощи LLM примерно в $3. Легко представить себе, как злоумышленники бомбардируют компанию тысячами длинных, изощренных запросов, сгенерированных в недорогой LLM, и наносят значительный денежный ущерб. Поскольку процесс автоматизирован, аномалии в нем могут быть замечены далеко не сразу.
Если злоумышленник знает, какая агентская система и какая LLM используются в бизнес-процессе, он может провести атаку более точно и причинить значительно больший ущерб. Авторы исследования GitInject подсчитали, что атакующий, способный создавать на GitHub сообщения об ошибках (issues) в организации, использующей ИИ-агентов в анализе ошибок, способен нанести ущерб до $111 и «сжечь» 400 минут GitHub Actions со счета жертвы. И это только в рамках единичной атаки, до момента, когда срабатывают инструменты защиты GitHub. Естественно, такая атака может быть многократно повторена, для атакующего это бесплатно.
Наиболее опасный, хоть и трудно оценимый в деньгах, риск несут атаки, провоцирующие LLM на избыточные рассуждения. В работе OverThink авторы продемонстрировали, как безобидно сформулированная задача подается в языковую модель, в итоге приносит корректный результат, но в процессе решения потребляет в 46 (!) раз больше токенов, чем могла бы. Причем все протестированные исследователями задачи успешно проходили существующие фильтры безопасности.
В новой версии топа OWASP по рискам языковых моделей эта проблема рекордно выросла в приоритете: Unbounded Token Consumption теперь обозначается LLM06:2026, и среди ее вариаций явно выделена атака «отказ кошелька» (Denial of Wallet), приводящая к исчерпанию бюджета жертвы на LLM.
Как не стать жертвой «нового DDoS»
В первую очередь следует отказаться от принципа «используем ИИ ради использования ИИ». Далеко не все задачи имеет смысл поручать автономным агентам. Целесообразно периодически проводить экономическую переоценку стоимости использования искусственного интеллекта.
Кроме того, следует ограничивать права и набор инструментов, доступных автономному ИИ-агенту. Чем меньше действий доступно системе, тем эффективнее она работает над узкой задачей, тем меньше у нее возможностей раздуть расходы, тем меньше шансов, что кто-то сможет «раскрутить» ее на ненужные траты токенов.
Мы также рекомендуем использовать строгие лимиты расхода токенов и настроить систему оповещения об их превышении. Имеет смысл вводить параллельные ограничения: предел на одну задачу, предел на сутки и так далее. Оповещение о превышении лимитов должно немедленно доходить до ответственного за систему специалиста, чтобы он мог принять взвешенное решение — продолжить или остановить процесс.
Строго проверяйте внешние, недоверенные данные. Любая обрабатываемая ИИ информация, приходящая извне, будь то заявки, обращения, сообщения и комментарии, а также различные технические поля, способные нести произвольный текст (DNS-записи, HTTP-заголовки, имена файлов), могут не только приводить к промпт-инъекциям, но и целенаправленно раздувать объем работы. Следует ограничивать их размер и следить за нагрузкой, которую они создают.
Считайте цену единицы работы и сверяйте счета поставщика со своими данными. Стоимость одного разбора, одной заявки, одной проверки — единственный способ понять, за что вы платите, и заметить ошибки в счетах.
]]>Облачные платформы в руках хакеров
Облачные платформы служат для злоумышленников удобным инструментом, чтобы быстро и с минимальными затратами развернуть фишинговый сайт, веб-приложение или отдельную страницу. Так, на многих из них действуют бесплатные тарифы, а регистрация занимает считаные минуты и часто не требует дополнительной верификации. Это значит, что в случае блокировки одного аккаунта любой пользователь может сразу создать новый.
Опасность заключается в том, что инструменты, полагающиеся на фиды фишинговых адресов, скорее всего, не распознают опасный ресурс: поддомены создаются с такой скоростью, что вендоры защитных решений далеко не всегда успевают отследить и внести их в список блокируемых. Помогают злоумышленникам и встроенные механизмы защиты облачных платформ, позволяющие скрыть реальный IP сервера. На внимательность пользователей тоже не стоит рассчитывать: даже если кто-то и обратит внимание на адрес страницы, то знакомый домен не вызовет подозрений.
Один из наиболее опасных сценариев использования вредоносных доменов на известных облачных платформах — атака с применением техники Adversary-in-the-Middle (AiTM, разновидность Man-in-the-Middle). Используя фишинговую страницу, злоумышленник встраивается в коммуникацию между пользователем и легитимным сервисом. Когда жертва входит в свой аккаунт, атакующий перехватывает сессионный токен, который подтверждает уже пройденную аутентификацию и позволяет использовать активную сессию пользователя. Никакая MFA от такой атаки не спасет.
Подобная утечка учетных данных может долго оставаться незамеченной, а злоумышленник тем временем успевает продать их в даркнете. Если данные окажутся в руках опытных хакеров, например APT-группировки, компания может столкнуться с длительной целевой атакой. Злоумышленники получат возможность нарушить работу критических систем и сервисов или похитить информацию, представляющую коммерческую или технологическую ценность.
Как проходит атака с применением AiTM
Рассмотрим подробнее, как выглядит AiTM-атака, о которой мы говорили выше, на примере реально выявленного нашими экспертами кейса. Если вам интересен детальный разбор механики с фрагментами кода, то вы можете найти его на экспертном блоге Securelist.
Этап 1. Выбор жертвы
Первым делом злоумышленник рассылает потенциальным жертвам фишинговые письма с вредоносной ссылкой. Предлог может быть самым стандартным, например просьба подписать некие рабочие документы. Из огромной базы, по которой ведется рассылка, фишеру нужно выделить действительно используемые адреса. Именно поэтому ссылка из письма ведет не сразу на основной фишинговый ресурс, а на страницу с псевдокапчей, где нужно ввести e-mail.
Чтобы не вызвать подозрений ни у пользователя, ни у защитных инструментов, злоумышленники, как правило, используют на этом этапе взломанные легитимные сайты. При этом даже если «песочница» или анализатор зафиксируют нарушение и HTML-страница будет заблокирована, то злоумышленник почти ничего не потеряет — такие ресурсы используются как расходники.
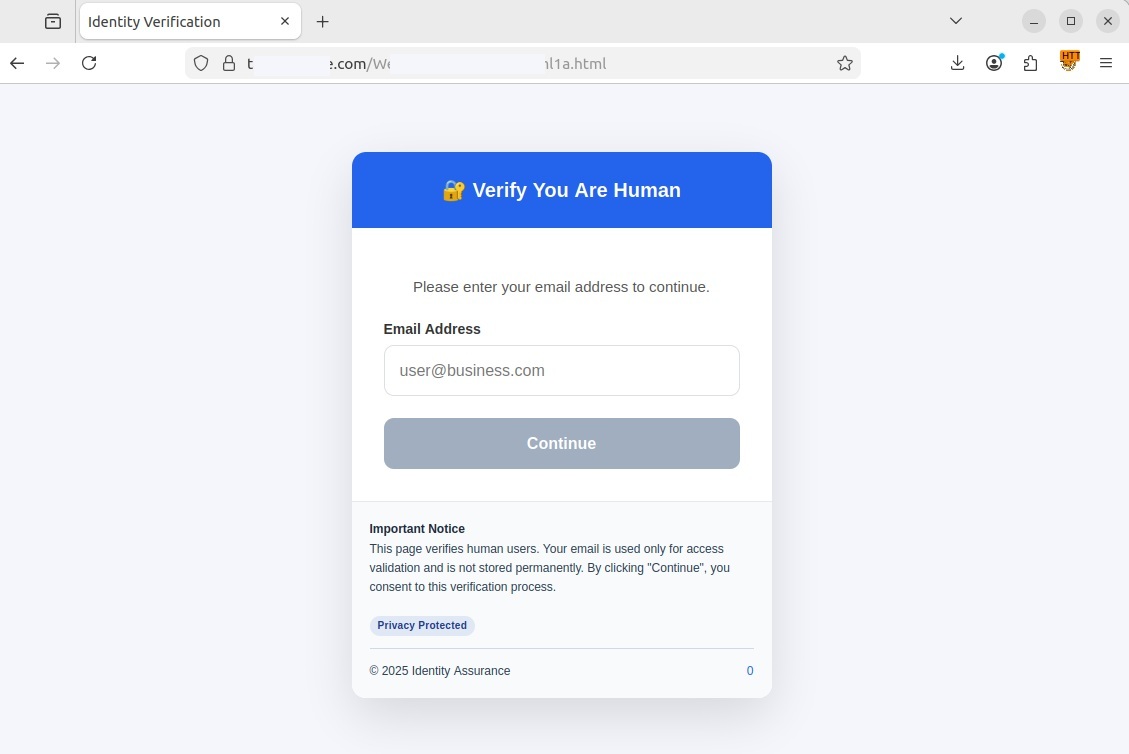
Ложная капча запрашивает электронную почту пользователя
Разобравшись с «капчей», пользователь переходит на вторую страницу, созданную с помощью облачной платформы.
Этап 2. Создание прозрачного прокси
Здесь тоже капча, но уже настоящая — в отличие от первой, она не собирает персональные данные, а защищает фишинговую страницу от краулеров. После прохождения проверки в браузере жертвы запускается скрипт для перехвата трафика и разворачивается специальная библиотека для создания веб-прокси. Так формируется прозрачный прокси, за счет которого все данные, введенные пользователем на следующем этапе, автоматически продублируются злоумышленнику. Подтвердив, что он не робот, пользователь попадает на третью страницу.
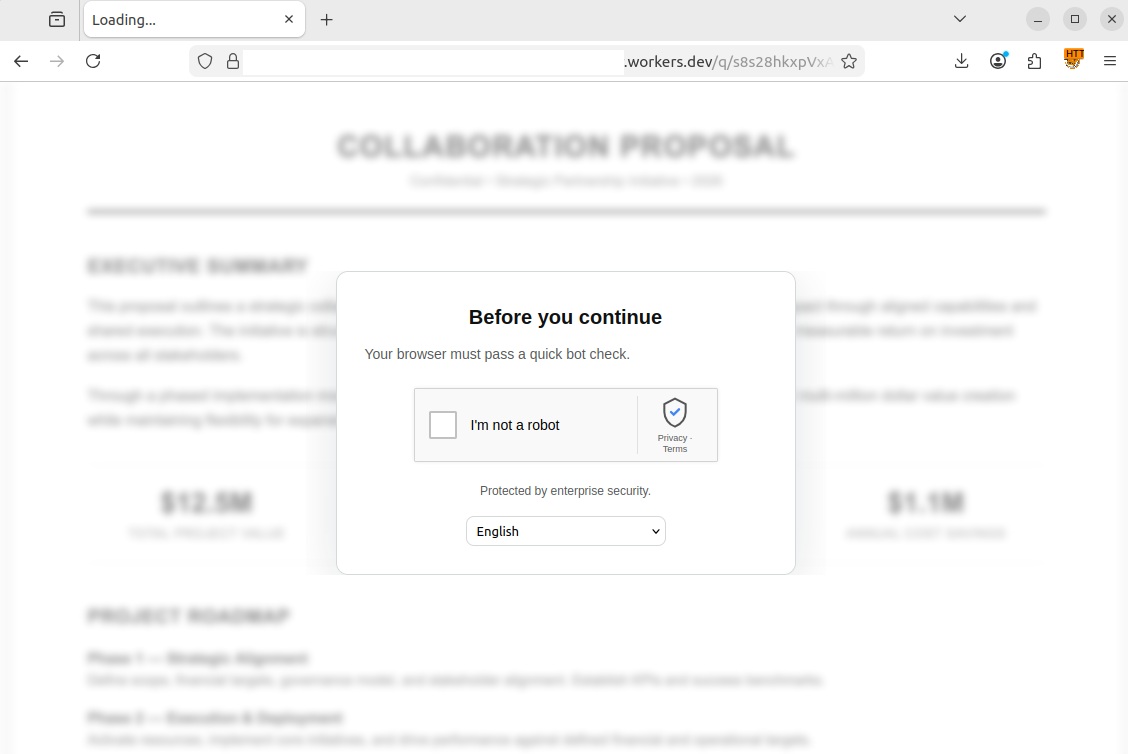
После прохождения второй капчи в браузере жертвы создается прозрачный прокси
Этап 3. Подмена окна браузера
Теперь к подмене трафика добавляется подмена интерфейса (Browser-in-the-Browser, BiTB). Суть в том, что внутри легитимной веб-страницы открывается блок, стилизованный под настоящее всплывающее окно. Внутри него загружается реальная форма аутентификации (например, на сайте Microsoft). Когда жертва вводит логин, пароль и код MFA внутри такого «браузера в браузере», прокси-скрипт перехватывает учетные данные и сессионные токены.
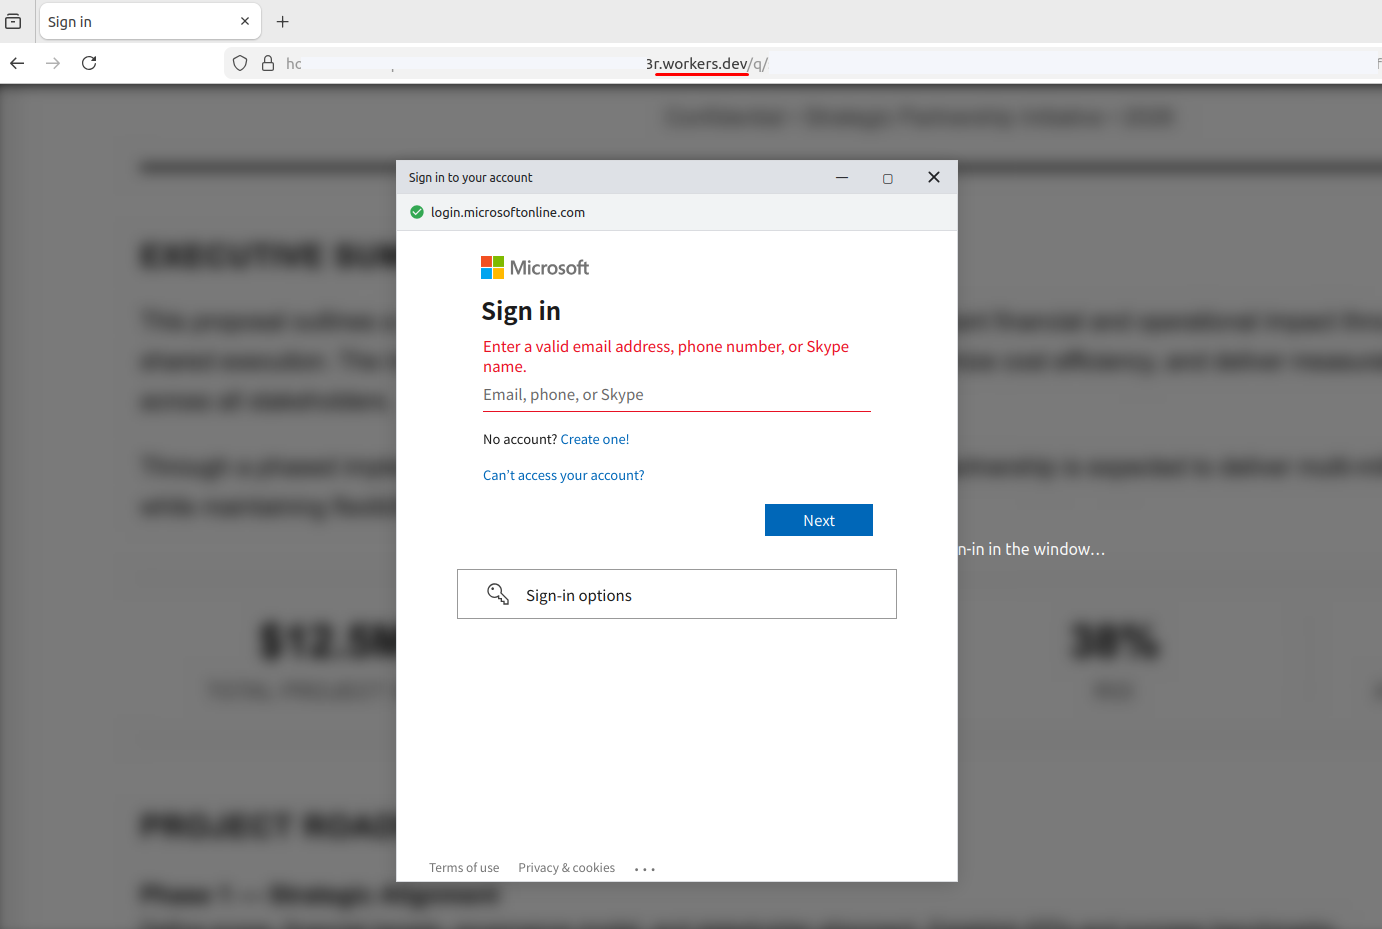
Данные, которые пользователь вводит в реальной форме аутентификации, дублируются злоумышленнику
После успешной аутентификации прокси отправляет команду на закрытие окна и перекидывает жертву на страницу с системной ошибкой, например Session Expired. Этот шаг вновь направлен на то, чтобы усыпить бдительность пользователя. Жертва думает, что произошел технический сбой, и пытается войти снова, в то время как мошенник уже получил полный доступ к сессии и может продолжить атаку внутри корпоративной сети.
«Облачный фишинг» в цифрах
За последние 12 месяцев (с июля 2025 года по июнь 2026 года) мы выявили почти 400 тыс. ссылок на фишинговые страницы, размещенные на популярных облачных платформах и в децентрализованных сетях. Чаще всего злоумышленники используют домены pages.dev и vercel.app — присваивающие их платформы Cloudflare и Vercel предлагают бесплатные тарифы, автоматическую выдачу SSL-сертификатов и глобальные CDN. В топ-3 с незначительным отрывом вошел также github.io (платформа GitHub Pages). На нем размещено множество легитимных проектов, поэтому массовая блокировка фишинговых страниц была бы невозможна без ущерба для добросовестных пользователей.
Популярностью пользуется и децентрализованная сеть IPFS (InterPlanetary File System, «межпланетная файловая система»). Используя этот протокол связи, злоумышленник может размещать фишинговые страницы прямо у себя на компьютере и предоставлять доступ к ним через специальный IPFS-шлюз. Такими шлюзами являются домены dweb.link и ipfs.io (пятое и шестое место). Главная опасность заключается в том, что даже при блокировке одного шлюза фишинговая страница остается доступной через другие узлы сети.
В десятку лидеров также вошли визуальные конструкторы Wix и Webflow. На них можно довольно быстро создавать страницы без глубоких знаний кода, что снижает порог входа для злоумышленников, не слишком подкованных с технической точки зрения.
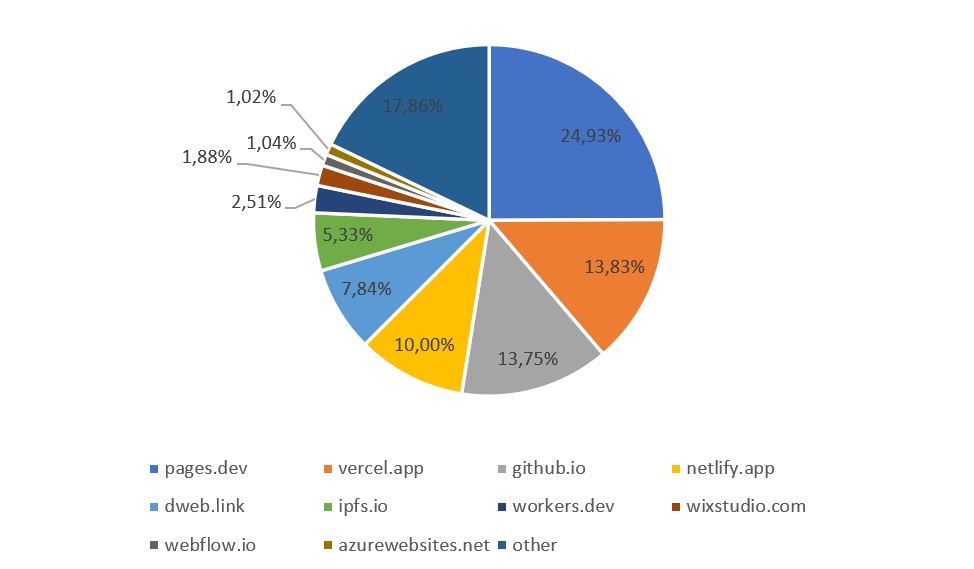
Топ-3 домена по популярности у фишеров: pages.dev, vercel.app и github.io
Как защититься
Атаки с использованием облачных платформ не так просто разглядеть и остановить, поэтому подход к их предотвращению должен быть комплексным. Первый и самый очевидный шаг — это обеспечить нейтрализацию фишинговых ссылок еще до того, как их получат пользователи. Справиться с этой задачей поможет наше решение для корпоративной почты Kaspersky Secure Mail Gateway. Для многоуровневой защиты конечных устройств используйте Kaspersky Endpoint Security. Чтобы минимизировать риски возможных атаках, важно также научить сотрудников критически относиться к любому запросу на ввод учетных данных, даже если окно, запрашивающее почту, выглядит совершенно безопасным.
]]>