
„Zum Buch kann ich nur sagen: Der Verlag fragte mich, ob ich eine Neuauflage meines Büchleins von 2016 schreiben wollen würde. Wollte ich nicht. Aber ein Sammelband wäre doch was, schlug ich vor. Christina war zum Glück bereit, mitzumachen. Zwei Dutzend fähiger Kolleg:innen erklärten sich bereit. Texte beizusteuern. Vielen Dank an alle! Ob uns gelungen ist, die Themenfelder in dem knapp 400 Seiten-Buch gut abzudecken, müssen andere beurteilen.“ (Aus: 15 Jahre Datenjournalismus und Open Data)
Buch beim Halem-Verlag
https://www.halem-verlag.de/produkt/handbuch-daten-und-ki-im-journalismus/
Die Covid19-Pandemie bedeutete eine Zäsur für den Datenjournalismus. Markierten die Afghanistan War Logs von 2010 quasi die Geburtsstunde des data-driven-journalism, hat er es zehn Jahre später tagtäglich auf die Start- und Titelseiten geschafft. Waren zuvor Graphen und Tabellen nur im Sport und bei der Börse sowie Kartenvisualisierungen im Wetter täglich wiederkehrender Bestandteil, sind jetzt Dashboards, Graphen, Diagramme und Karten zu Infektionszahlen & Co. normal geworden. Zudem finden sich mittlerweile ellenlange, über viele Monate angewachsene und verfeinerte Datendossiers vollgepfropft mit Diagrammen auf diversen Nachrichtenwebsites.

Angesichts der erfreulichen Klickzahlen für die Datenstücke wird sich in Redaktionen sicher Gedanken darüber gemacht, was demnächst an die Stelle der Infektionszahlen treten könnte. Es liegt auf der Hand, dass Klimadaten-Dashboards ein möglicher Ersatz wären. Doch die hohe Aufmerksamkeit für die Pandemiedaten rührt daher, dass es um Fragen von Gesundheit, gar um Leben und Tod ging – des eigenen und des der eigenen Nächsten. Zudem hingen unmittelbare, spürbare Einschränkungen von der Entwicklung der Zahlen ab.
Auch wenn die Klimakrise mit jedem Einzelnen im Zusammenhang steht, ist es doch deutlich schwerer den unmittelbaren Bezug abzubilden und erfahrbar zu machen. Das ist die Crux der Klimakrisenkommunikation: Seit Jahrzehnten ist bekannt, dass der Klimawandel kommt, doch passiert ist zu wenig – auch weil die Folgen scheinbar weit in der zeitlichen Ferne liegen und die Klimawandelphänomene über den gesamten Globus scheinbar unzusammenhängend verteilt sind.
Einsparziele auf den Zahn fühlen
Wie lässt sich die Verschränkung der abstrakten Klimakrise mit dem Leben der/des Einzelnen weniger abstrakt vermitteln? Und wie tappt man dabei nicht in die Falle, die Klimakrise als individuelles Problem zu framen? Etwa wie der PR-Trick, den 2004 der Ölkonzern BP mit dem Carbon Footprint ersann.
Klimadatenjournalismus sollte es nicht darauf beruhen lassen, Temperaturanstiegsprognosen, schmelzendes Eismassen und schrumpfende Kohlenstoffbudgets wiederzugeben; vielmehr muss er sich darum drehen, vollmundig angekündigte Einsparziele wie jetzt nach dem Urteil des Bundesverfassungsgerichts anhand von Daten auf den Zahn zu fühlen: Sind die angekündigten Maßnahmen konkret genug, erscheinen sie realistisch oder bauen sie auf fragwürdigen Fantasien über z.B. Wasserstofftechnologie und Zertifikatshandel auf? Kontinuierlich wäre zu beobachten, wer und was dem Erreichen der Ziele im Weg steht.

Nimmt man beispielsweise obenstehende Grafik, könnte Klimadatenjournalismus nun anhand existierender Studien skizzieren, welche CO2-Preise wohl angemessen wären, um die nötige Emissionsminderung zu erreichen. Und er könnte umreißen, welche finanziellen Effekte das auf Industrie, Land- und Dienstleistungswirtschaft sowie private Haushalte hätte. Vermutlich würde deutlich: Ohne zügige und einschneidende Veränderungen der Konsumgewohnheiten sowie des Individualverkehrs, ohne Abschied vom Wachstumsfetisch und der 5-Tage-Arbeitswoche wird es kaum gehen.
Neue Datenpolitik
Das Problem ist: Dank Satelliten, Sensoren und zahllosen Wissenschaftler*innen haben wir zwar eine recht gute Datenlage und ein fundiertes Verständnis darüber, was hinsichtlich des Klimawandels akut geschieht. Doch die Daten über seine maßgeblichen Verursacher*innen und derjenigen, die Profit auf Kosten des Ökosystems machen, sind wesentlich schwerer zu ermitteln. So fehlen etwa hierzulande transparente Unternehmensregister und generell der Zugriff auf die Finanzflüsse international operierender Unternehmen. Nutznießende des rücksichtslosen Umweltverbrauchs können mit allerlei Tricks ihr Geschäftsgebaren, ihre Investments und ihr Vermögen verschleiern – und damit auch verhindern, sich der Gesellschaft gegenüber verantworten zu müssen.
Um besser die polit-ökonomischen Vorgänge rund um das Klimathema analysieren zu können, bräuchte es also mehr zugängliche Daten über das Wirtschaften von lokal bis global. Vielleicht wäre es Zeit für eine Renaissance der Open Data-Idee, der es bislang oft an einem Alltagsbezug mangelte und die eine gewisse Beliebigkeit atmete. Eine neue Klimadatenpolitik müsste beispielsweise darauf drängen, dass Mobilitäts- und Logistikdaten, die auf der durch öffentliche Gelder bereitgestellten Straßen- und Schieneninfrastruktur entstehen, zumindest auch staatlichen Stellen in „Echtzeit“ zur Verfügung stehen. Ähnlich könnte gelten: Wer CO2-relevanten Handel betreibt, etwa Supermarktketten, muss seinen Kunden*innen Daten über deren individuellen Einkauf (Kassenzettel) auf Verlangen digital als strukturierten Datensatz zur Verfügung stellen. Dann könnten z.B. Redaktionen oder gemeinnützige Organisationen diese per Datenspendenplattformen in Data Trusts zusammenführen, auswerten und Erkenntnisse über Konsumgewohnheiten aufzeigen: Denn will man diese gemeinschaftlich umsteuern, dürfen diese Daten nicht nur in den Datenbanken der Konzerne liegen, sondern müssen der Allgemeinheit zur Verfügung stehen.
Das Konzept CO2-Preis impliziert, dass sich zumindest theoretisch grob näherungsweise berechnen lassen könnte, wie viel CO2-Ausstoß mit jedem verdienten und ausgegebenen Euro verknüpft ist – inklusive des historischen Umweltverbrauchs u.a. durch die seit Kolonialzeiten weiterhin stattfindende Umverteilung von Süd nach Nord. Möglicherweise wäre die Etablierung einer solchen CO2-Parallelwährung hilfreich, um das oben beschriebene Probleme der Abstraktion des Bezugs zur Klimakrise zu überwinden: Das eh schon äußerst abstrakte Konzept „Geld“ ist von jeder/m gelernt und könnte um eine solche Übersetzungsfunktion erweitert werden. Der Science-Fiction-Autor Kim Stanley Robinson wirbt seit einiger Zeit für die Einführung einer Carbon Coin, die als Äquivalent für die Vermeidung von CO2-Ausstoß ausgegeben würde.
Mehr Bewegtbild
Datenjournalismus an sich sollte mehr über Formate für Plattformen wie Instagram, TikTok und YouTube nachdenken. Das heißt: Bewegtbild/Animation plus Sprache. Das entspricht der Generation, die nicht mehr wie die vor 1990 geborene mit Text/Print als Primärmedium aufgewachsen ist, sondern mit verschiedenformatigen Bildschirmen. Für die Fotos, Grafiken, Clips, Filme, Computerspiele, Chats und Audio gleichrangig neben dem geschriebenen Wort stehen.
Die Frage bleibt wie Klimadatenjournalismus in Kurzformaten funktionieren könnte und welche Themen er bespielt. Zumindest handwerklich können als Inspiration die Dataviz-Videos von Robert Kosara (eagereyes) bei YouTube dienen. Wie auch die Videos von Lisa Charlotte Rost von DataWrapper, etwa dieses zum Thema „Warum sollte man beim Visualisieren ein Ziel haben?“. Klar ist: Es würden weitere Skills und veränderte/erweiterte Arbeitsabläufe in den Datenteams benötigt – und damit mehr finanzielle Ressourcen.
So informativ die ersten Beiträge von KlimaVor8 oder die 24 minütige „data -driven documentary“ von Neil Haloran auch sind: Mangelt es wirklich noch an Aufklärung darüber wie der Klimawandel von Menschen gemacht wurde? Und was bringt ein Bericht über die Probleme beim Erneuerbare-Energien-Gesetz, ohne die dazugehörigen Macht- und Konzerninteressen zu betrachten? Unser dringendstes Problem ist, dass wir ins Handeln kommen. Und Journalismus, speziell auch Datenjournalismus, kann der Gesellschaft dabei helfen, die richtigen Handlungspfade zu entdecken.
Zuerst erschienen auf klimajournalismus.de
]]>Über den möglichen Effekt der Corona-Mutante B117 auf den Pandemieverlauf in Deutschland gab die Süddeutsche Zeitung unlängst Prognosen ab. Diesen Teil des Stücks „Die unsichtbare Welle“ halte ich für Alarmismus. Wohlgemerkt geht es nicht darum, zu sagen, die Mutation B117 sei nicht ansteckender oder sie sei harmlos. Der Punkt ist: Ihr Effekt lässt sich schwer vorhersagen und die Herleitung der Szenarien der SZ steht auf wackeligen Füßen. (Die SZ recyclt die alarmistische Prognose zahlenmässig leicht entschärft in einem Beitrag (Paywall) von heute: „Die magische 50“. Der Spiegel veröffentlichte (Paywall) heute ebenfalls Modellrechnungen, die auf ähnlichen Annahmen wie die der SZ fußen.)
[Siehe Kommentar von zwei der Autoren unten.]
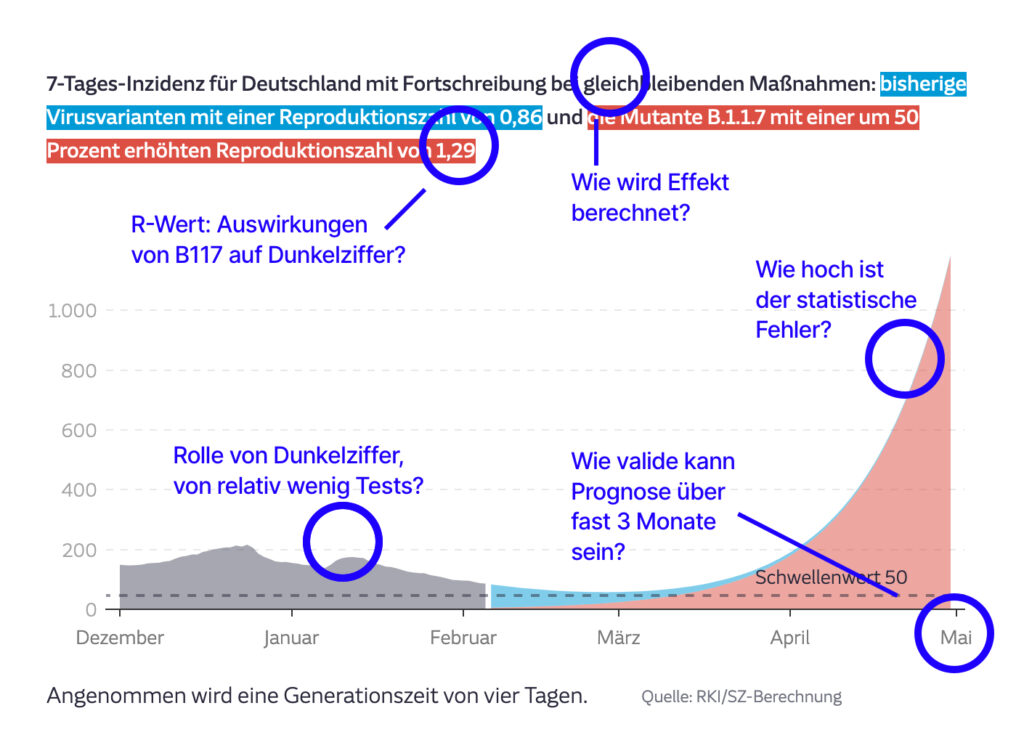
Um den Einwand vorwegzunehmen, dass die SZ im Text sehr wohl auf „Unsicherheiten“ hinweisen würde: Meiner Meinung nach ist es nicht Aufgabe von Journalismus, Spekulation zu betreiben. Wenn ein gewisses Maß an Unsicherheit herrscht, wenn etwas „ähnlich schwer zu kalkulieren“ ist, dann sollte man es besser einfach lassen. Prognosen sind nicht das Geschäft von Journalismus, geschweige denn die unterkomplexe Modellierung von Pandemieverläufen.
Denn so kommt es zu solch‘ Geraune: „Ohne einen verschärften Lockdown“ und ohne einen Impfeffekt, so die SZ, wäre „sogar eine Inzidenz von mehr als 1000 gegen Ende April möglich.“ Die Steilheit diese These wird dann noch in einem Diagramm präsentiert: So tritt das Problem der autoritativen Wirkung von Datenvisualisierungen ein. Die werden schnell als wahrhaftig wahrgenommen – noch mehr, wenn sie weitgehend kontextfrei auf Social Media zirkulieren. Darüber schrieb ich vor einigen Wochen – lustigerweise auch unter dem Titel „Die unsichtbare Welle“ – für den Freitag.
Gummimetrik Inzidenz
Die SZ legt ihren Prognosen den „R-Wert“ und die 7-Tagen-Inzidenz zugrunde. Beide Metriken sind hierzulande recht grobe Indikatoren für den Pandemieverlauf (siehe dazu diese Diskussion des R-Werts beim BR.) Warum sind sie grob? Weil sie beide einzig aus der Anzahl der positiven Tests abgeleitet werden: Wird weniger getestet, sinkt die Zahl der erkannten Infektionen; steigt die Zahl der Tests, steigt auch die Zahl der erkannten Infektionen.
Selbstredend gibt es keinen direkten 1-zu-1 Zusammenhang zwischen einem Steigen oder Sinken der Testanzahl und den erkannten Infektionen. Vielmehr ist es ein Trend: Er ist abhängig davon, ob gerade eine Ausbruchssituation herrscht oder die Pandemie abklingt – was sich dann eben auch in steigenden oder sinkenden Positivraten zeigt. Es spielen neben der derzeitigen Impfstrategie auch regionale Unterschiede im Pandemieverlauf in den Inzidenzwert hinein (und heben sich dann auf nationaler Ebene möglicherweise wieder auf); dazu gesellen sich diverse Verzerrungen wie durch die Inkubationszeit, zeitliche Verzögerung bei den Meldungen der erkannten Fälle etc.. Würde man mehr testen (oder gar systematisch Kontrollgruppen beobachten) wäre der Inzidenzwert aussagekräftiger. Doch im Vergleich zu Ländern wie Großbritannien und Dänemark wird in Dtl. deutlich weniger getestet; nur etwa die Hälfte der Testkapazitäten von 2,3 Mio./Woche wird derzeit ausgeschöpft (siehe RKI-Lagebericht 3.2.2021, S. 11).

Schließlich kommt noch die Dunkelziffer ins Spiel: Wie hoch ist die Zahl derjenigen Infizierten, die symptomlos (aber ansteckend) sind sowie derer, die sich krank und ungetestet zur Arbeit schleppen usw. usf. ? (Von der vom RKI im Herbst 2020 angekündigten Antikörperstudie gibt es weiterhin keine Neuigkeiten.) Gängige Schätzungen über die Höhe der Dunkelziffer liegen beim 2-6 fachen der erkannten Infektionen. Sprich: Wenn von einer 7-Tage-Inzidenz unter 50 exklusive der Dunkelziffer als Zielmarke gesprochen wird, ist eigentlich eine tatsächliche 7-Tage-Inzidenz inklusive Dunkelziffer von ungefähr 150 bis 350 Infektionen pro 100.000 Einwohner*innen gemeint. Der Inzidenzwert in seiner gebräuchlichen Form hat also in etwa die Qualität einer Pi-mal-Daumen-Metrik.
Fiktion von harten Daten
Die SZ nimmt also nun diese schwammigen Inzidenzwerte und ignoriert die Problematik der Dunkelziffer: Statt diese Unzulänglichkeiten wenigstens zu erwähnen, wird der Eindruck vermittelt, hier würde mit harten Daten hantiert. Um die Fiktion nicht zu stören, wird auch kein Konfidenzintervall (statistischer Fehler) gezeigt. Vier Szenarien für eine höhere Ansteckungsrate von der B117-Mutante werden berechnet: 30, 40 und 50 Prozent höhere Ansteckungsrate bei „gleichbleibenden“ Lockdown-Maßnahmen sowie ein Szenario mit 40 Prozent und „verschärften“ Maßnahmen. Unklar bleibt:
- Woher weiß die SZ, dass der Ausbruch in UK Ende des Jahres 2020 maßgeblich durch B117 getrieben war (und nicht bspw. auch die Weihnachtszeit ohne harten Lockdown eine Rolle spielte)? Wenn die SZ also eine Quelle für ihre Annahme hat, wäre es hilfreich gewesen, wenn sie benannt worden wäre.
- In UK gab es einen zügigen Rückgang der erkannten Infektionen diesen Januar trotz der Dominanz der infektiöseren B117-Variante. Anhand welcher Grundlage bewertet die SZ die Effekte der Maßnahmen in UK (Tier 4) im Unterschied zu den vermeintlich unzureichenden Maßnahmen in Deutschland?
- Wie lässt sich eine Bewertung, wie ausreichend welche Maßnahme in Deutschland funktionieren, vornehmen, wenn weiterhin weitgehend unklar ist, wo Ansteckungen geschehen? Inwiefern kann die SZ beurteilen, ob die derzeitigen Maßnahmen hierzulande nicht ausreichen, die Neuinfektion bei Ausbreitung der B117-Variante zu bremsen? Kennt die SZ wissenschaftliche Untersuchungen dazu? Eben erst begonnen hat die Studie „StopptCovid“.
- Was meint die SZ genau mit „verschärfte Maßnahmen“? Wie berechnet sie über mehrere Monate im Voraus, welchen Effekt diese haben könnten? Bezieht sie in ihre Prognose in irgendeiner Form die Auswirkungen der steigenden Impfzahlen sowie die weiter steigende Anzahl von mit Corona-Antikörpern ausgestatteten Personen (erkannte Infektionen plus Dunkelziffer) ein?
Als neulich die taz Stimmungsmache hinsichtlich der B117 Mutante veröffentlichte, habe ich das als Datenboulevardjournalismus kritisiert. In einer Zeit, in der viel Verunsicherung herrscht, sollte Journalismus nicht Ängste schüren. Sondern für Klarheit sorgen, Wissenslücken benennen und einen fundierten Diskurs ermöglichen. Dazu trägt der Prognoseteil des besagten Stücks der SZ wenig bei.
]]>
Nach fast einem Jahr Corona-Datenberichterstattung ist weiterhin zu beobachten, dass in zahlreichen Redaktionen viel Halbinformiertheit über Infektionszahlen und Co. verbreitet ist und folglich auch von ihnen verbreitet wird. Zur Klarheit und Beruhigung im Diskurs über die Lage trägt das nicht bei; vielmehr schürt es Aufgeregtheit und Verwirrung.
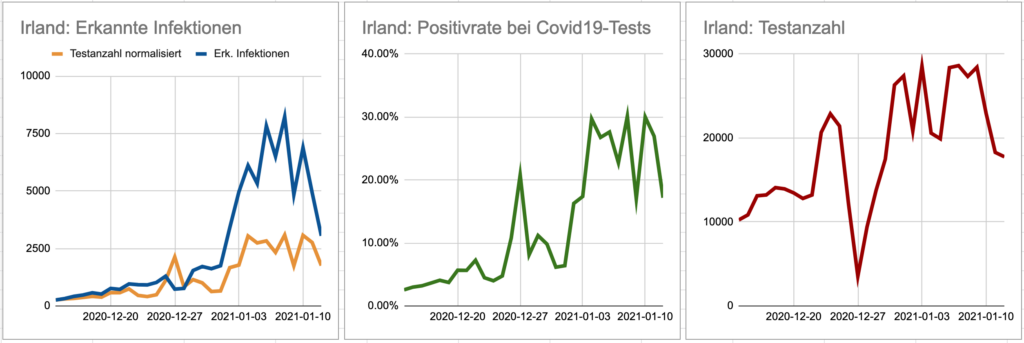
Jüngst lieferte die „taz“ ein anschauliches Beispiel dafür. „Die mutierte Kurve“ lautet der Titel der Printausgabe vom 13.1.21, der auf der gleichen Seite durch einen Kommentar und eine dazugehörige Seite 3 begleitet wurde. Die „neue Coronavariante“, so die taz im Kurztext zur Titelgrafik, sei besonders ansteckend. Gemeint ist wohl die Mutante B.1.1.7 und nicht die in Südafrika entdeckte B.1.351. So im Ungefähren geht es weiter. Es sei umstritten, ob die in Kurve der erkannten Infektionen in Irland in der Titelgrafik etwas mit besagter Mutante zu tun habe. Sicher sei, wenn diese hierzulande vermehrt auftrete, würden die bisherigen Maßnahmen nicht ausreichen. Dazu später mehr.

Das Boulevardeske an dieser Titelgrafik ist, dass sie – um Alarmismus zu betreiben – eine Datenentwicklung zeigt, ohne sie analytisch in einen Kontext zu stellen. So wäre es wichtig gewesen, darauf hinzuweisen, dass in den letzten drei Wochen in Irland an manchen Tagen dreimal so viel getestet wurde wie in den Wochen vor diesem Zeitraum. Würde man beispielsweise die Testanzahl am 14. Dezember 2020 zur Grundlage einer Grafik nehmen, aber die gleiche Positivrate der jeweiligen Tage verwenden, sähe die Kurve gleich weniger dramatisch aus (Tests von 2 Personen je 1000 EW statt z.T. 6 pro 1000). Was nicht bedeuten soll, dass die Entwicklung in Irland nicht bemerkenswert wäre: Tatsächlich stieg die Positivrate der Tests zeitweilig auf fast 30 Prozent an (in Dtl. lag sie in der vergangenen Woche bei knapp 13 Prozent). Hätte die taz also beispielsweise drei Grafiken gebracht, die zusammen den nötigen Kontext liefern würde, wäre das weniger plump und mehr erkenntnisreich gewesen.


Daten via Our World in Data
Die Fixation auf die täglichen Infektionszahlen, die allerorten rauf- und runtergebetet werden, als ob sie eine verlässliche Metrik wären (sind sie nicht), ist auch Grundlage des dazugehörigen taz-Kommentars „Es reicht nicht“. In dem ist die Rede von „schockierend“ und „zu befürchten“ und sich „verdichtenden Anzeichen“. Deswegen seien die Lockdown-Massnahmen nicht genug. Doch weisen die eh aussageschwachen Infektionszahlen (wie hoch ist die Dunkelziffer?) nicht darauf hin, dass derzeit eine Entwicklung wie in Irland oder Dänemark stattfindet. Die Feststellung, dass es derzeit „nicht reicht“, widerspricht zudem dem aktuellen Trend auf den Intensivstationen. Dort sinken seit einer Woche die Zahlen. Was sowohl eine wesentlich härtere Metrik als sich „verdichtende Anzeichen“ ist – als auch eines der erklärten Ziele der Lockdown-Massnahmen.

Die eigentliche Titelgeschichte auf Seite 3 der taz ist entsprechend alarmistisch mit „Die Sorgen wachsen exponentiell“ überschrieben. Im Text selbst ist dann nur die Rede davon, dass die Sorge bei der Bundesregierung „hoch“ sei. Hauptsächlich geht es um die B.1.1.7-Mutante und deren wohl höhere Ansteckungsrate. Und einige Fälle dieser Variante, die in Deutschland entdeckt wurden. „Inwieweit sich die Mutante darüber hinaus weiterverbreitet hat, ist unklar“, heißt in dem Zusammenhang. Aussagen darüber oder Einschätzungen dazu, ob die jetzigen Lockdown-Massnahmen angesichts einer möglichen Ausbreitung von B.1.1.7 ausreichen, liefert die Titelgeschichte nicht.
Fazit: Knackige Schlagzeilen zu Corona-Mutanten, die auf Fakten beruhen, die „niemand weiß“, zukünftig besser dem Boulevard überlassen.
—
Einer der taz-Autoren nimmt unten in den Kommentaren Stellung zur Kritik.
]]>
Es lässt sich darüber streiten, was Innovation im Journalismus eigentlich bedeutet. Das will ich an dieser Stelle aber nicht tun, sondern auf die Diskussion des Begriffs in der Studie „Die Innovationslandschaft des Journalismus in Deutschland“ der Landesmedienanstalt NRW aus dem Sommer 2020 verweisen (S. 8ff.). Dort wird vor allem auch auf die „Produktinnovation“ eingegangen, die so umrissen wird: „Veränderungen bei den am Markt angebotenen Produkten und Dienstleistungen des Journalismus, die für Kundinnen und Kunden sichtbar und nutzbar sind“.
Ich habe in den letzten zehn Jahren an einer Handvoll Firmen und dann noch nicht gestarteten Vorhaben, die man zum Bereich der journalistischen Produktinnovation zählen könnte, mitgearbeitet. Während bei mir am Anfang eher Enthusiasmus in Paarung mit Blauäugigkeit und Ahnungslosigkeit über Business und Branche bestimmende Faktoren waren, wandelte sich mein Enthusiasmus in späteren Jahren mehr hin zu Ernüchterung: Die Innovationsbehäbigkeit in geraumen Teilen der Sender- und Verlagsbranche plus einer kargen Förderlandschaft bildeten zumindest für mich nicht das Ökosystem, in dem ich mich weiter unternehmerisch betätigen wollte (eine Bestandsaufnahme der Branche und Fördersituation liefert oben genannte Studie). So skizziere ich im Folgenden ein Förderprogramm auf Basis meiner Erfahrungen und dem, was ich von Kolleg*innen über deren (z.T. gescheiterten) Vorhaben mitbekommen habe.
Wenig Impact
Wenn ein Förderprogramm „Innovation“ im Journalismus befördern soll — und nicht im benachbarten Verlagswesen oder Anzeigenbusiness –, muss es eine langfristige Entfaltung der redaktionellen Arbeit und gar den ein oder anderen Pivot (Schwenk) unterfüttern. Wenn es weniger um unmittelbaren Journalismus (Artikel & Sendungen), sondern um technische Lösungen, etwa für spezielle Formate und Dienste, geht, dürfte eine über mehrere Jahre angelegte Förderung ebenfalls geeignet sein. Deren Ziel sollte nicht sein, Hirngespinste von Unicorn-Medien-Startups zu befördern und Renditeerwartung von VCs (Venture Capitalists) zu stillen. Sondern Redaktionen und Dienste zu schaffen, die sich als KMU — Klein- und Mittelständische Unternehmen — oder Verein-Firmenkonstrukten, Genossenschaften usw. etablieren können, um ein zeitgemäßes journalistisches Ökosystem zu formen: Dieses dürfte im Wesentlichen im digitalen Raum stattfinden.
Der Impact von kurzfristigen Förderprogrammen ist überschaubar. So haben die 21,5 Millionen Euro, die Google unter dem Dach der “Digital News Initiative” in Deutschland über fünf Jahre hinweg ausschüttete, wenig Spuren hinterlassen. Der Effekt des „Prototypefund“ der Open Knowledge Foundation Dtl., finanziert vom Bundesforschungsministerium, der mittlerweile hunderte Vorhaben mit bis zu 50.000 Euro aus dem Sektor „Civic Tech“ & Co. ausstatte, ist ebenfalls übersichtlich: Hier fehlt eindeutig ein Anschlussprogramm, das vielversprechenden Konzepten eine längerfristige Perspektive bietet.
Fünf Jahre
Solch eine Perspektive könnte den Zeitraum von fünf Jahre umfassen:. Innerhalb dieses sollte sich im Falle des Journalismus eine Medienmarke — ob lokal, regional, bundesweit oder in einer Nische — soweit etablieren können, dass sie sich eine eigenständige und tragende Finanzierung erarbeiten kann. Die Rede ist hier von Redaktionen oder Dienstleistern mit einer schlanken Verwaltungsstruktur, die eher bei einer Personaldecke von 10 bis 20 Personen als von 50 oder mehr liegen wird. Eine Vorstellung von einer Kostenstruktur eines journalistischen Projekts in dieser Liga gaben unlängst die „Krautreporter“ preis; der Monatsbericht von “netzpolitik.org“ verschafft ebenfalls einen Eindruck der Kosten von journalistischen Unternehmungen, die nicht Verlegerfamilien oder Aktienbesitzer*innen reich machen sollen.
Nehmen wir ein Zehntel der 220 Millionen Euro, die seitens der Bundesregierung an Verlage vergeben werden soll, als Grundlage: Mit 22 Millionen Euro ließe sich ein sechsjähriges Förderprogramm auflegen, das zehn journalistische Vorhaben solide für fünf Jahre finanzieren könnte. Das Fördermodell würde auf Basis eines Stufenplans mit drei Phasen funktionieren: Prototyp, Konkretisierung und Umsetzung.

Eingangs müsste der organisatorische Rahmen aufgesetzt werden, der über die gesamte Strecke etwa 3 Millionen Euro Kosten verursachen wird (Overhead): Neben Personalmittel, Miete und Sachkosten schlagen hier auch Honorare für Beirat, Mentoring und Coaching zu buche. Rund ein halbes Jahr dürfte es dauern, bis die Geschäftsstelle des Programms etabliert und entsprechendes Personal eingestellt ist (je nach Phase drei bis zehn Personen). Weiter müsste die Ausschreibung für die Prototypenphase veröffentlicht und ein Beirat gefunden werden. Auch müssten entsprechende Mentor*innen und Coaches identifiziert werden.
Prototypenphase
Nach der Bewerbungsphase für die Projekte und die entsprechende Auswahl durch den Beirat starten 50 ausgewählten Projekte, die für sechs Monate 50.000 Euro Mittel erhalten. Sie werden durch Coaches und Mentor*innen begleitet und können zusätzlich noch Trainings (z.B. Marktanalyse, Buchhaltung, Finanzplanung, Personalwesen, Rechtliches) wahrnehmen.
Ab dem 4. Monat der sechsmonatigen Prototypenphase sichtet der Beirat die 50 Projekte und legt verschiedene Bewertungsverfahren an. So werden Ende des 5. Monats zwanzig von den fünfzig ausgewählt, die ihr Projekt konkretisieren können (ggf. könnten sich an dieser Stelle auch bestehende Projekte bewerben).
Konkretisierung
Die zwanzig Projekte, die überzeugt haben, erhalten für ein Jahr 200.000 Euro. Der Launch, zumindest einer ersten Version (Beta, MVP — Minimal Viable Product) sollte nach 2/3 dieses Jahres erfolgen. Gleichzeitig erarbeitet jedes Projekt – unterstützt durch Mentoring und Coaching – Personal- und Businesspläne. Diese Pläne, das Team sowie die Gestalt der eigentlichen Unternehmung dienen dann als Grundlage, anhand derer im 10. Monat die Hälfte der zwanzig Vorhaben für eine vierjährige Förderung vom Beirat ausgewählt werden.
Umsetzung
Mit einem Budget von insgesamt 1,25 Millionen Euro ausgestattet, die in jährlichen Chargen ausgezahlt werden, können sich die Vorhaben nun etablieren. Die Förderung in den ersten beiden der vier Jahren liegt bei je 400.000, im dritten bei 300.000 und im letzten bei 150.000 Euro (siehe Grafik ganz oben). Diese Staffelung bietet anfangs genug finanzielle Stabilität und Planungssicherheit. Sie verlangt aber auch, will die Unternehmung auf mindestens gleichen Niveau weiter operieren, das in den ersten beiden Jahren ein wie auch immer geartetes absehbar tragendes Finanzierungsmodell gefunden wird. Innerhalb der vier Jahre können die Projekte auf ein gewisses Kontingent von Mentoring und Coaching sowie Beratungen zugreifen.
Selbstredend gäbe es für solch ein Programm noch viele Details zu klären: Wie sieht ein (möglichst wenig aufwendiges) Reporting aus? Wie gestaltet sich das Controlling der Finanzen? Wie setzt sich der Beirat zusammen und wie transparent operiert er? Wer ist Träger des Programms, der staatsferne gewährleistet? Könnten thematische Vorgaben — z.B. 50 Prozent der sich bewerbenden Vorhaben müssen einen lokaljournalistische Ausrichtung haben — Sinn ergeben?
Jedenfalls denke ich, dass ein Programm dieser Art dem hiesigen Journalismus guttun würde. Mit zusätzlichen 4 Millionen Euro pro Jahr könnte es sogar verstetigt werden und in einigen Jahren würden dann jährlich zehn journalistische Vorhaben starten. Die dann hoffentlich gekommen sind, um zu bleiben.
Transparenzhinweis: Der Autor hat als “datenjournalist.de” den Aufruf des “Arbeitskreis Digitale Publisher“ anlässlich der 220 Mio. Förderung unterzeichnet. In dem Zusammenhang sei auch auf den Offenen Brief des “Forum gemeinnütziger Journalismus” verwiesen.
Zuerst erschienen bei Medium.
]]>
Artikel für Wochenzeitung „der Freitag“ (Nr. 46, 12. Nov 2020)
Seit einem Dreivierteljahr gehört die Berichterstattung zu Corona nun dazu wie der Wetterbericht. Es ist normal geworden, dass in Nachrichtensendungen, Zeitungen und auf Websites die aktuellen Zahlen genannt und gezeigt werden. Daten-Dashboards, Diagramme und Karten finden sich allerorten. Sie sollen helfen, das Infektionsgeschehen abzubilden, Trends zu zeigen und politische Entscheidungen nachvollziehbar zu machen.
Dabei kommt diesen Diagrammen und Karten eine zweischneidige Rolle zu. Einerseits sind sie eben gut dafür geeignet, Verläufe sowie An- und Abstiege in Trends zu schildern: Die meisten Menschen sind mit einem auf Mustererkennung optimierten Sehapparat ausgestattet und können über solche Grafiken deutlich mehr Informationen aufnehmen als in der gleichen Zeit per Text oder gesprochenem Wort. Das Problem andererseits ist, dass die Informationen, die durch die Diagramme transportiert werden, schnell als wahr und aussagekräftig empfunden werden.
]]>
[Update 26.10.20 – 08:00 Uhr: Dieser Beitrag wurde angesichts der nunmehr dritten Änderung, die der Tagesspiegel an seinem Artikel vornahm, ergänzt].
In Zeiten der Covid19-Pandemie, in der Daten – deren Analyse und Visualisierung – auch in der breiten Öffentlichkeit eine wohl kaum dagewesene Rolle spielen, kommt Datenjournalist*innen eine wichtige Rolle zu: Zugang zu Daten zu beschaffen, Ordnung in die Datenmengen zu bringen und diese auf Relevanz und Aussagekraft abzuklopfen, sind ureigene Aufgaben des Metiers.
Deswegen ist die Betrachtung von Beispielen, die nicht gelungen sind, hilfreich. Um andere dafür zu sensibilisieren, dass bei einem Themengebiet wie Corona, bei dem einiges an Verunsicherung herrscht, noch mehr Sorgfalt als sonst an den Tag gelegt werden sollte. Daten-Fehlinterpretationen können sich schnell als vermeintliche Gewissheiten verbreiten. Was kontraproduktiv ist.
Der Tagesspiegel meinte am Freitag, den 23.10.20, er sei dazu in der Lage, die Frage zu beantworten, die sonst niemand beantworten kann: „Wo sich die Menschen mit Corona infizieren“ [Die Überschrift lautet jetzt „Wo infizieren sich Menschen mit Corona?“.]“ Die Antwort darauf sei: „Die Menschen stecken sich vor allem zu Hause an.“ Quasi als Kronzeuge für diese Behauptung diente ein Diagramm des Robert Koch-Instituts (RKI), das in dessen Lagebericht (pdf) vom 20.10.2020 auf Seite 12 veröffentlicht wurde.

Was dem Tagesspiegel entgangen war, ist, dass die Grafik nur ca. 16 Prozent des Ausbruchsgeschehen aller dem RKI gemeldeten Infektionen darstellt. Das stand zum einem im Textteil unterhalb des Diagramms selbst. Dass es sich nur um einen kleinen Teil aller gemeldeten Infektionen handeln konnte, machte zudem die Beschriftung der y-Achse deutlich (vierstellige Ziffern vs. Kalenderwochen).
So etwas kommt vor. Ich machte den Tagesspiegel über einige Kanäle auf den Fehler aufmerksam. Und nach einiger Zeit wurde reagiert und eine Korrektur angekündigt. Damit hätte die Sache sich gehabt. Doch die Korrektur war nur kosmetischer Natur. Die falsche, unbelegbare Grundaussage des Textes blieb bestehen (abgesehen davon, dass der Tagesspiegel entgegen seiner eigenen Redaktionsrichtlinien die Korrektur nicht kenntlich machte).
[Ergänzung 26.10.20] Am späten Samstagnachmittag (24.10.20), etwa 24 Stunden nach der ersten Korrektur – wohl auch auf Reaktion auf diesen Text hier – wurde dann unter dem Artikel auf Änderungen hingewiesen und der Artikel zum 2. Mal geändert. Der Hinweis war recht knapp und nach dann in einer weiteren 3. Korrektur ausführlicher. So heißt es nun im Artikel selbst:
„Einige kritisieren diese Art der Auswertung, weil aufgrund der hohen Dunkelziffer offen ist, ob solche Auswertungen tatsächlich eine hohe Aussagekraft haben. Andererseits sind solche Erhebungen derzeit eben die einzigen strukturierten Erhebungen zu Ausbruchsorten: So lange nicht über zufällige Stichproben in der Bevölkerung anlasslose Tests stattfinden, ist es schwer, bessere Auswertungen durchzuführen.„
Hier tritt der Grund für den Trugschluss seitens des Tagesspiegel erneut zu Tage (s.u.): Die Daten des RKI und auch der Gesundheitsämter sind keine „strukturierten“ Erhebungen. So heißt es zu den Daten des RKI in einem aktuellen Beitrag (23.10.20) des NDR: „Ihr Zweck ist nicht, eine repräsentative Aussage zu treffen, sondern als Alarmanlage zu fungieren“. Weiter schreibt der NDR: „Ein Forscher bezeichnet die Frage nach der Höhe der Dunkelziffer sogar als ‚Million-Dollar-Question‘.“
Warum der Tagesspiegel an seiner Aussage im Vorspann „Oft passieren Ausbrüche im Privaten“ weiter festhält, obwohl er mittlerweile selbst in seinem Korrekturhinweis am Ende seines Artikels auf die Problematik der Dunkelziffer eingeht, ist mir weiterhin unverständlich. [Ergänzung Ende]
Was nicht passt, wird passend gemacht
Die Neufassung des Tagesspiegel-Textes drehte sprachlich ein wenig runter. Etwa wurde aus der Kopfzeile „Die Gefahr lauert zu Hause“ nun „Die Gefahr lauert auch im Privaten“.
Die Grundthese, im Privaten fänden die meisten Infektionen statt, wird weiter behauptet. Neu ist, dass nun RKI-Präsident Lothar Wieler im Text zitiert wird. Demnach soll er am Donnerstag (22.10.20) mit Verweis auf das Diagramm aus seinem Haus gesagt haben: „Ein Großteil der Menschen steckt sich im privaten Umfeld an.“ Allein, dass der RKI-Präsident die Grafik seinen eigenes Hauses missversteht, sollte dem RKI zu denken geben (es hätte sowohl im Text als auch in der Grafik des Lageberichs durchaus deutlicher werden können, dass es sich nur um einen kleinen Anteil aller gemeldeten Fälle handelt).
Die Aussage zum „privaten Umfeld“ lässt sich so nicht treffen. Es ist nämlich völlig unklar, ob die in besagtem Diagramm aufgeschlüsselten 16 Prozent des Ausbruchsgeschehens als repräsentativ gelten können. Darüber hinaus – und das ist der Grund für den eigentliche Trugschluss des gesamten Tagesspiegel-Artikels – gibt es eine Dunkelziffer beim Infektionsgeschehen (siehe Grafik ganz oben). Deswegen können auch die anderen Beispiele, die der Tagesspiegel z.T. nachträglich anführt, nur spekulativer Natur sein („Dass viele der aktuell Neuinfizierten sich tatsächlich in ihren eigenen Haushalten infizieren, bestätigen Daten einiger Bundesländer auf Anfrage“ [Der Satz wurde vom Tagesspiegel mittlerweise gestrichen]). Denn die Anzahl der tatsächlichen Infektionen (also inkl. der Dunkelziffer) ist schlicht nicht bekannt und es gibt dazu bislang keine gesicherte Erkenntnis.
Der Medizinstatistiker Gerd Antes sagte unlängst in einem Interview mit dem SWR (20.10.20) hinsichtlich der Dunkelziffer: „Über allem schwebt aber der große, dunkle Schatten, dass die Zahlen nicht richtig sind, weil wir keine systematisch erfassten Zahlen haben.“
Zur Nachverfolgung des Ausbruchgeschehens gab Antes zu bedenken: „Wenn Sie im privaten Kreis jemanden erwischen mit einem positiven Test, dann haben Sie es wesentlich einfacher, die Beteiligten zu ermitteln. Viel einfacher als in einer Bar, wo auch noch die Hälfte der Angaben falsch sind. Die Atmosphäre ist auch viel freundlicher. In einer Familie haben sie oft eine enorme Bereitschaft, die Daten zu liefern und alles mitzumachen, was empfohlen wird. Das geht ganz schnell und die landen dann vollständig in der Statistik des Landesgesundheitsamtes, während die anderen zum großen Teil einfach weg sind.“
Die von Antes beschriebene Verzerrung in der Datenerhebung könnte Ausdruck des „Überlebensirrtum/ Survivorship Bias“ (Wikipedia) sein: Der bevorzugt erfolgreiche und/oder einfach zugängliche Vorgänge.
Was hätte der Tagesspiegel besser machen können?
– Plausibilätsprüfung: Warum hat noch niemand anderes den vermeintlichen „Scoop“ erkannt, wenn das Indiz dafür doch für alle zugänglich und offensichtlich ist?
– Fachmenschen um Einschätzung bitten
– Quellen genau benennen und verlinken
Vor allem hätte der Tagesspiegel meiner Meinung nach den Text zurückziehen müssen, der nunmehr seit 24 Stunden als einer der „meistdiskutierten“ Beiträge auf seiner Website steht. Er verbreitet weiterhin fahrlässig Fehlinformationen, obwohl die Redaktion auf offensichtliche Mängel hingewiesen wurde, die sie auch zur Kenntnis genommen hat.
Es ist derzeit nicht hilfreich, Leuten zu vermitteln, die größte Ansteckungsgefahr ginge von privaten Haushalten aus. Eine Aussage wie „diese Orte spiegeln sich absolut nicht in den politischen Maßnahmen wider“ ist schlicht eine Behauptungen und journalistisch nicht haltbar. [Der Tagesspiegel hat diesen Satz nun geändert und schreibt: „… spiegeln sich auch nicht in den politischen Maßnahmen wider.“]
Anmerkung (26.10.20 – 08:00 Uhr): Dieser Text wurde um den Hinweis auf den „Survivorship-Bias“ (Danke @fil_ter) ergänzt. Weiter wurde das Zitat aus dem Artikel nach der 3. Korrektur des Tagesspiegels und der Absatz davor sowie die beiden darauf folgenden eingefügt. An drei Stellen wurde auf Änderungen im Tagesspiegel-Text hingewiesen.
]]>„Was sind die größten Hindernisse für die Verlage, voll in den Datenjournalismus bzw. die Automatisierung einzusteigen?
Wagnisbereitschaft und Talente. Die erfolgreiche Formel, wie solch ein Dienst aussehen könnte, hat bislang niemand gefunden – sonst würden wir davon sicher zahlreiche Varianten sehen. Wirklich neue Formate zu entwickeln, würde zum einen Wagnisbereitschaft und Investionsausdauer für einige Jahren bei den Verlagen erfordern. Und es bräuchte dafür die Kompetenzen. Sowohl in den Führungsetagen, um so etwas zu ermöglichen und fördern – als auch in den Redaktionen. Die Ausbildungsmöglichkeiten, die Spezialisten für den Journalismus im Zeitalter der digitale Transformation liefern könnten, sind in Deutschland rar. Die wenigen Talente in dem Sektor, die sich meist aus Eigeninitiative heraus profilieren konnten, machen Karriere bei den wenigen Häusern, die so etwas sowohl wertschätzen als auch entsprechend interessante Herausforderungen anbieten. Dieser ‚brain drain‘ lässt für Regional- und Lokalzeitungsverlage wenig übrig.„
Das komplette Interview gibt es hier.
.
]]>
Der große Augenmerk, der in vielen Medien auf die Zahl der offiziell Infizierten gerichtete wird, ist problematisch. Genauso wie darauf beruhende Berechnung von Verdoppelungszeiträumen und Vergleiche der Zahlen verschiedenen Länder miteinander. Warum?
In einem Interview mit der Schwäbischen Zeitung (5.4.2020) fasst Klaus Meier, Professor für Journalistik an der Katholischen Universität Eichstätt, die Problematik gut zusammen:
„Ich würde gerne etwas aufgreifen, was einerseits toll gemacht, aber andererseits hochproblematisch ist: Das sind Formate, die Zahlen zur Pandemie aufbereiten — interaktive Grafiken, die super gemacht sind und die viele Nutzer auch stark interessieren. Aber das führt dazu, dass man diese Zahlen wie Tabellenstände im Sport miteinander vergleicht: Sind wir jetzt schon wie Italien oder Spanien? Wie schneiden die USA ab? Wie stehen die Bundesländer und Landkreise in Deutschland da? Wer überholt wen? Die Zahlen werden für bare Münze in Echtzeit genommen. Aber auch wenn die Zahlen sauber recherchiert sind, können sie gar nicht das leisten, was man von ihnen erwartet: nämlich ein getreues Abbild der Wirklichkeit zu sein. … Man sollte immer wieder darauf hinweisen, welchen Hintergrund und welche Schwächen diese Zahlen haben. Journalisten sollten diese Zahlenfixiertheit hinterfragen und die Gültigkeit der Zahlen relativieren. Und Mediennutzer sollten sich nicht nur über Zahlen oder Tabellen informieren, sondern lieber zweimal am Tag längere Texte lesen, die diese Zahlen einordnen.“
Gernd Antes, Professor an der Medizinischen Universität Freiburg gilt als “Statistikexperte” und sagte im Interview mit dem Spiegel (31.03.2020):
Die Corona-Fälle, von denen wir jeden Tag im Fernsehen und Radio hören, beschreiben, wer positiv auf das neue Virus getestet wurde. Wie viele Menschen sich tatsächlich infizieren, wissen wir dagegen nicht. Die Schätzungen variieren extrem. Je nach Experten ist davon die Rede, dass sich fünf- bis zehnmal mehr Menschen infizieren als nachgewiesen werden. Manche Schätzungen liegen beim Zwanzigfachen oder sind noch höher. So eine Streuung ist ein sicheres Zeichen, dass niemand auch nur ungefähr weiß, wo die Wahrheit liegt. In der Folge können wir nur sehr grob abschätzen, wann und in welchem Umfang die Krankenhäuser mit schwer Erkrankten rechnen müssen.
Auf den Nachdenkseiten meinte der Statistiker Gerd Bosbach (03.04.2020) im Interview:
Ich bin nach wie vor überrascht, woher die politischen Entscheider die Sicherheit für die Richtigkeit ihres Vorgehens hernehmen, ohne die Zahl der Infizierten in der Bevölkerung zu kennen. Was sie kennen und worauf sie offenbar ihre Maßnahmen und das Festhalten an denselben stützen, ist die Zahl der positiv auf das Corona-Virus Getesteten. Das aber ist eine Größe, die extrem von der Anzahl der durchgeführten Tests abhängt … Die Zahl der positiv Getesteten umfasst eine kleine, nicht repräsentativ ausgewählte Gruppe. Es sind dies Menschen, die starke Krankheitssymptome aufweisen, wegen Vorerkrankungen oder ihres hohen Alters ein erhöhtes Risiko tragen, Kontaktpersonen im Umfeld von Infizierten sowie Personen, die nah am Patienten dran sind, wie Ärzte und Pflegepersonal. Um es salopp zu sagen: Wenn sie in dieser Gruppe morgen doppelt so viele Menschen testen wie heute, werden sie morgen wahrscheinlich auch fast doppelt so viele Infizierte finden wie heute. Daraus lässt sich aber weder ermessen, wie sehr das Virus in der Gesamtbevölkerung bereits verbreitet ist, noch in welchem Tempo es sich verbreitet.“
Jens Schröder, Datenschubser bei Meedia, hat sich am 02.04.2020 vorgenommen, regelmässig die Belegung der Intensivbetten zu untersuchen. Weil:
“Mein Problem an dieser Berichterstattung: Die Zahlen der Infizierten sind solang irreführend, solang die Dunkelziffer der Infizierten, die nicht getestet wurden, unbekannt ist … Deutlich relevanter sind die Zahlen der Patienten, die ins Krankenhaus müssen und vor allem derjenigen, die auf Intensivstationen behandelt werden müssen. Denn hier gibt es keine Dunkelziffer. Wenn jemand so krank ist, dass er auf eine Intensivstation muss, dann wird er auch dort landen. Zumindest so lang, wie die Stationen nicht überlastet sind. Die Dunkelziffer von schwer Erkrankten wird also klein oder sehr klein sein.
Auch Nate Silver von FiveThirtyEight warnt in einem längerem Beitrag (05.04.2020) über die reine Fixierung auf die erkannten Fallzahlen. Er dekliniert vier Szenarien durch, wie Coronavisustests ablaufen könnten und welche Auswirkungen das auf die entsprechenden Zahlen haben könnte.
But if you’re not accounting for testing patterns, it can throw your conclusions entirely out of whack. You don’t just run the risk of being a little bit wrong: Your analysis could be off by an order of magnitude. Or even worse, you might be led in the opposite direction of what is actually happening
Leider gibt es zu den Tests in Deutschland bislang nur wöchentlich Zahlen in den Situationsberichten des Robert Koch Instituts (RKI): mittwochs. Hier ist auffällig, dass bislang die Positivtestrate stieg. Dennochl lässt sich — ohne zu wissen, nach welchen Kriterien oder Systematik es zu einem Test gekommen ist — aus diesen Zahlen nicht viel herauslesen. Einzig wird klar: Die täglich berichtete Fallzahl von Corona-Infizierten ist einzig Ausdruck von der Anzahl der durchgeführten Tests — und sonst nichts.

Wie die Zahlen zustandekommen, hat das Institut in einem “Epidemiologisches Bulletin” (pdf) am 02.04.2020 erläutert. Dort wird auch auf die Testkapazitäten eingegangen. Diese scheint um einiges höher zu liegen als die tatsächlich durchgeführten Tests. Hier wäre interessant zu erfahren, ob ein logistisches Nadelöhr der Grund dafür ist und wo das liegt. Auch wäre spannend zu wissen, wie die Testkapazitäten regional verteilt sind und wie die regionale Auslastung aussieht.

Klar ist: Erst, wenn weitflächig und wiederholt repräsentative Tests wie sie jetzt in München durchgeführt werden sollen, geschehen, können demnächst validere Aussagen über den Stand der Pandemie herzulande getroffen werden.
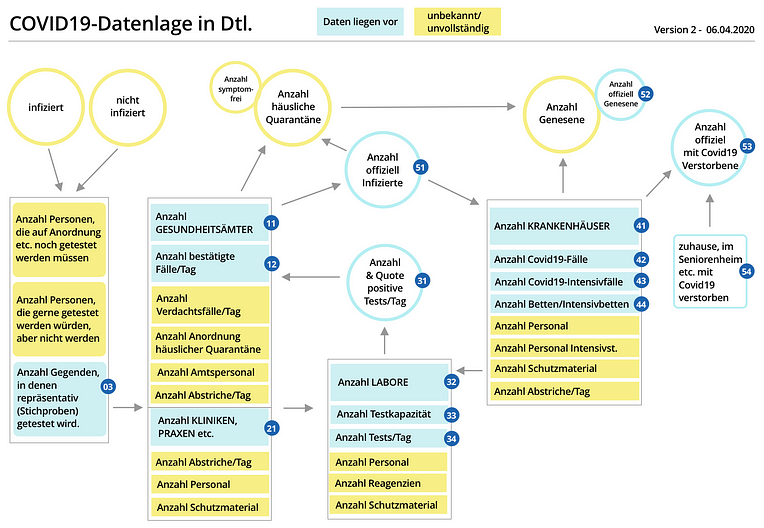
In einer Tabelle habe ich begonnen die Daten, die meines Wissens nach rund um den Coronavirus vorliegen — oder nicht–, zu sammeln. Die Grafik eingangs versucht, eine Systematik davon zu zeigen.
Zuerst erschienen bei Medium.
]]>steht es in der Einleitung des heute erschienenen »Manifests für einen Journalismus der Dinge — Strategien für den Journalismus 4.0«. Es handelt sich um Version 1 und will ein Diskussionsvorschlag sein.
Auf den ersten Blick ist klar, dass »Journalismus der Dinge« auf das »Internet der Dinge« anspielt (IoT — Internet of Things). Folglich wird IoT im zweiten Satz der Präambel des Manifests entsprechend prominent angeführt. Es wird aber auch auf den ersten Blick klar, dass dieses Wortspiel nicht weit trägt. Genauso wie niemand vom »Journalismus der Kamera«, »Journalismus der Stifte« oder »Journalismus der Lautsprecher« spricht, ist auch bei Dingen der Genitiv fehl am Platz — Journalismus wird nicht von Dingen gemacht. Er wird von Menschen gemacht, die dafür Dinge verwenden, um zum Beispiel über Dinge zu berichten.
Abgesehen von der in meinen Augen untauglichen Begrifflichkeit selbst, machen die zehn Thesen des Manifests auch deutlich, dass dieser »Journalismus der Dinge« kaum klar zu definieren ist: Vielmehr ist es der Versuch, diverse bereits bestehende Methoden und Genres von Journalismus unter einen Hut zu bringen. Was legitim wäre, böte es ein Mehrwert oder würde es helfen, ein bislang unbekanntes Phänomen oder Methodenset zu beschreiben. Damit etwa im Diskurs über Journalismus als gesellschaftliche Kraft neue Perspektiven aufgemacht werden können oder die Selbstverständigung besser gelingt.
Die Autor*innen des Manifests scheinen davon überzeugt, dass diese Notwendigkeit bestünde: Weil immer mehr Geräte und »Dinge« miteinander vernetzt seien (»Drohnen, Sprachassistenten, Fitnesstracker, Satelliten, Kameras, Luft-, PH- oder Abstandssensoren«) und diese »so verfügbar und billig wie nie zuvor« seien, würde dieser »neue Journalismus« benötigt. Denn: »Das Internet der Dinge verändert die Welt grundlegend.« Diese Entwicklung habe »langfristige Folgen für Gesellschaft, Umwelt und die Verteilung von Macht«. Der »Journalismus der Dinge« soll ermöglichen, »diese Entwicklungen sowohl kritisch begleiten als auch kreativ nutzen zu können«.
Warum der »alte« Journalismus das bislang nicht leistet, wird nicht explizit erwähnt. Ebensowenig wird mitgeteilt, warum dem bereits in die Jahre gekommene Marketingversprechen (»IoT wird die Welt verändern«) offenbar unkritisch gefolgt wird. Zudem bleibt unklar, was genau unter dem »Internet der Dinge« überhaupt verstanden werden soll. Dass Satelliten und Sprachassistenten dazu gezählt werden, ist zumindest ein eigenwilliges Verständnis.
Inkonsistenz und Widersprüchlichkeit
Nach der Einleitung folgen zehn Thesen, durch die sich ein Motto zieht: »Dinge« fungiert als Platzhalterbegriff für verschiedenste Aspekte und Ansätze im Journalismus. So wird gleich in der ersten These — »Dinge vermitteln die Welt« — deutlich: Im Wesentlichen geht es bei dem »Journalismus der Dinge« darum, was bereits seit nunmehr zehn Jahren als »Datenjournalismus« und »Sensorjournalismus« bekannt ist. So heißt es in besagter These: »Jeden Tag erheben Sensoren Massen von Daten.« Weiter geht es dann unvermittelt: »Dinge sind eine neue Hardware des Journalismus.« Was wenig Sinn ergibt, wenn etwa Satelliten und Kameras zu diesen »Dingen« zählen, die seit vielen Jahrzehnten existieren und schon lange unter anderem für journalistische Zwecke Einsatz finden.
»Dinge übernehmen Verantwortung« ist die zweite These betitelt. »Maschinen treffen zunehmend automatisch Entscheidungen«, wird dort behauptet. Das kann man so sehen — es ist aber hoch umstritten, weil damit die Auftraggeberinnen, Entwicklerinnen und Betreiber*innen der Maschinen aus der Verantwortung entlassen werden. Oder hat das VW-Auto »entschieden«, bei der Abgasprüfung zu betrügen?
Wahrscheinlich meinen es die Autor*innen gar nicht so, denn am Ende der These wird angeführt, dass Journalismus »Verantwortung den richtigen zuzuweisen« können soll. Was wiederum mit der Überschrift der These nicht zusammenpasst, weil es offenbar doch nicht per se die Dinge sind, die die Verantwortung übernehmen.
Solcherart Inkonsistenz und Widersprüchlichkeit zieht sich durch alle zehn Thesen. Mal sind Dinge die Interfaces von Smartphones, dann gibt es »Journalismus-Dinge« und andere Dinge sind dann wiederum Ausspielkanäle.
Es scheint so, dass in den Thesen verschiedenste Versatzstücke aus anderen Konzepten und Methoden zusammengerührt werden: Neben Daten- und Sensorjournalismus finden sich Aspekte von »Algorithmic Accountability Reporting« und »Citizen Journalism« wieder.
Und nicht zuletzt redet das Manifest schlicht von den allgemeinen Potentialen und Charakteristika des reinen Journalismus ohne Präfix und Zusatz. Dabei kommt ein Brei heraus, der in Teilen missverständlich oder schlicht unvollständig bzw. unverständlich ist: »Wenn die vernetzte Barbie mit Kindern Weltpolitik diskutiert, wenn der Radfahrer seine Daten mit der Redaktion teilt, werden Leser Teil der Recherche.« Aha.
Letztlich bleibt der Eindruck zurück, dass die Autor*innen des Manifests im »Journalismus der Dinge« einen Tausendsassa sehen wollen. Doch weder über seine Identität noch seine eigene Geschichte ist man im Klaren. Vielleicht gelingt es der zweiten Version des Manifests, dies klarer zufassen.
]]>